GAS6 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

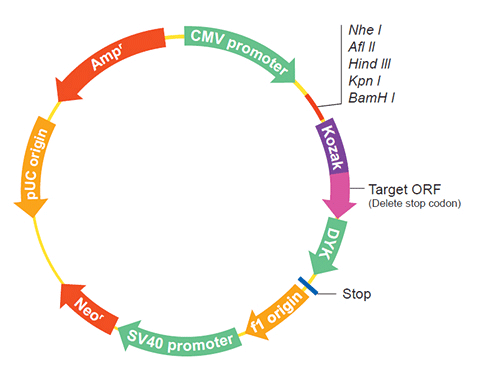
The following GAS6 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the GAS6 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa64090 XM_008957523.1
Latest version!
Pan paniscus growth arrest specific 6 (GAS6), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 9-11 $258.30
$369.00
OPa64089 XM_008957522.1
Latest version!
Pan paniscus growth arrest specific 6 (GAS6), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa64090
    Clone ID Related Accession (Same CDS sequence) XM_008957523.1
    Accession Version XM_008957523.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1218bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product growth arrest-specific protein 6 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027881.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    ATGGACACCT GTGAGGACAT CTTGCCGTGC GTGCCCTTCA GCGTGGCCAA GAGTGTGAAG 
    TCCTTGTACC TGGGCCGGAT GTTCAGTGGG ACCCCCGTGA TCCGACTGCG CTTCAAGAGG
    CTGCAGCCCA CCAGGCTCGT AGCTGAGTTT GACTTCCGGA CCTTTGACCC CGAGGGCATC
    CTCCTCTTCG CCGGAGGCCA CCAGGACAGC ACCTGGATCG TGCTGGCCCT GAGAGCCGGC
    CGGCTGGAGC TGCAGCTGCG CTACAACGGT GTCGGCCGTG TCACCAGCAG CGGCCCGGTC
    ATCAACCATG GCATGTGGCA GACAATCTCT GTTGAGGAGC TGGCACGGAA TCTGGTCATC
    AAGGTCAACA GGGACGCTGT CATGAAAATC GCGGTGGCCG GGGACTTGTT CCAACCGGAG
    CGAGGACTAT ATCATCTGAA CCTCACTGTG GGAGGTATTC CCTTCCATGA GAAGGACCTC
    GTGCAGCCTA TAAACCCTCG TCTGGATGGC TGCATGAGGA GCTGGAACTG GCTGAACGGA
    GAAGACACCA CCATCCAGGA AACAGTGAAA GCGAACACGA GGATGCAGTG CTTCTCGGTG
    ACGGAGAGAG GCTCTTTCTA CCCCGGGAGC GGCTTTGCCT TCTACAGCCT GGACTACATG
    CGGACCCCTC TGGACATCGG GACTGAATCA ACCTGGGAAA TAGAAGTCGT GGCTCACATC
    CGCCCAGCCG CAGACACGGG CGTGCTGTTC GCGCTCTGGG TCCCCGACCT CCGTGCTGTG
    CCTCTCTCTG TGGCCCTGGT AGACTATCAC TCCACGAAGA AACTCAAGAA GCAGCTGGTG
    GTCCTGGCCG TGGAGCACGT GGCCTTGGCC CTAATGGAGA TCAAGGTCTG CGATGGCCAA
    GAGCACGTGG TCACCGTCTC GCTGAGGGAC GGTGAGGCCA CCCTGGAGGT GGACGGCACC
    AGGGGCCAGA GCGAGGTGAG CGCCACGCAG CTGCAGGAGA GGCTGGCCGT GCTCGAGAGG
    CACCTGCGGA GCCCCGTGCT CACCTTTGCC GGCGGCCTGC CAGATGTGCC GGTGACTTCA
    GCGCCAGTCA CCGCATTCTA CCGCGGCTGC ATGACACTGG AGGTCAACCG GAGGCTGCTG
    GACCTGGACG AGGCGGCGTA CAAGCACAGC GACATCACGG CCCACTCCTG CCCCCCCGTG
    GAGCCCGCCG CAGCCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008955771.1
    CDS644..1861
    Translation

    Target ORF information:

    RefSeq Version XM_008957523.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus growth arrest specific 6 (GAS6), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008957523.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    ATGGACACCT GTGAGGACAT CTTGCCGTGC GTGCCCTTCA GCGTGGCCAA GAGTGTGAAG 
    TCCTTGTACC TGGGCCGGAT GTTCAGTGGG ACCCCCGTGA TCCGACTGCG CTTCAAGAGG
    CTGCAGCCCA CCAGGCTCGT AGCTGAGTTT GACTTCCGGA CCTTTGACCC CGAGGGCATC
    CTCCTCTTCG CCGGAGGCCA CCAGGACAGC ACCTGGATCG TGCTGGCCCT GAGAGCCGGC
    CGGCTGGAGC TGCAGCTGCG CTACAACGGT GTCGGCCGTG TCACCAGCAG CGGCCCGGTC
    ATCAACCATG GCATGTGGCA GACAATCTCT GTTGAGGAGC TGGCACGGAA TCTGGTCATC
    AAGGTCAACA GGGACGCTGT CATGAAAATC GCGGTGGCCG GGGACTTGTT CCAACCGGAG
    CGAGGACTAT ATCATCTGAA CCTCACTGTG GGAGGTATTC CCTTCCATGA GAAGGACCTC
    GTGCAGCCTA TAAACCCTCG TCTGGATGGC TGCATGAGGA GCTGGAACTG GCTGAACGGA
    GAAGACACCA CCATCCAGGA AACAGTGAAA GCGAACACGA GGATGCAGTG CTTCTCGGTG
    ACGGAGAGAG GCTCTTTCTA CCCCGGGAGC GGCTTTGCCT TCTACAGCCT GGACTACATG
    CGGACCCCTC TGGACATCGG GACTGAATCA ACCTGGGAAA TAGAAGTCGT GGCTCACATC
    CGCCCAGCCG CAGACACGGG CGTGCTGTTC GCGCTCTGGG TCCCCGACCT CCGTGCTGTG
    CCTCTCTCTG TGGCCCTGGT AGACTATCAC TCCACGAAGA AACTCAAGAA GCAGCTGGTG
    GTCCTGGCCG TGGAGCACGT GGCCTTGGCC CTAATGGAGA TCAAGGTCTG CGATGGCCAA
    GAGCACGTGG TCACCGTCTC GCTGAGGGAC GGTGAGGCCA CCCTGGAGGT GGACGGCACC
    AGGGGCCAGA GCGAGGTGAG CGCCACGCAG CTGCAGGAGA GGCTGGCCGT GCTCGAGAGG
    CACCTGCGGA GCCCCGTGCT CACCTTTGCC GGCGGCCTGC CAGATGTGCC GGTGACTTCA
    GCGCCAGTCA CCGCATTCTA CCGCGGCTGC ATGACACTGG AGGTCAACCG GAGGCTGCTG
    GACCTGGACG AGGCGGCGTA CAAGCACAGC GACATCACGG CCCACTCCTG CCCCCCCGTG
    GAGCCCGCCG CAGCCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa64089
    Clone ID Related Accession (Same CDS sequence) XM_008957522.1
    Accession Version XM_008957522.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1629bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product growth arrest-specific protein 6 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027881.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    ATGGGCAACT TCTTCTGCCT GTGTAAAGCT GGCTGGGGGG GCCGGCTCTG CGACAAAGAT 
    GTCAACGAAT GCAGCCAGGA GAACGGGGGC TGCCTCCAGA TCTGCCACAA CAAGCCGGGC
    AGCTTCCACT GTTCCTGCCA CAGCGGCTTC GAGCTCTCCT CTGATGGCAG GACCTGCCAA
    GACATAGACG AGTGCGCAGA CTCGGAGGCC TGCGGGGAGG CGCGCTGCAA GAACCTGCCC
    GGCTCCTACT CCTGCCTCTG TGACGAGGGC TTTGCGTACA GCTCCCAGGA GAAGGCTTGC
    CGAGATGTGG ACGAGTGTCT GCAGGGCCGC TGTGAGCAGG TCTGCGTGAA CTCCCCAGGG
    AGCTACACCT GCCACTGTGA CGGGCGTGGG GGCCTCAAGC TGTCCCAGGA CATGGACACC
    TGTGAGGACA TCTTGCCGTG CGTGCCCTTC AGCGTGGCCA AGAGTGTGAA GTCCTTGTAC
    CTGGGCCGGA TGTTCAGTGG GACCCCCGTG ATCCGACTGC GCTTCAAGAG GCTGCAGCCC
    ACCAGGCTCG TAGCTGAGTT TGACTTCCGG ACCTTTGACC CCGAGGGCAT CCTCCTCTTC
    GCCGGAGGCC ACCAGGACAG CACCTGGATC GTGCTGGCCC TGAGAGCCGG CCGGCTGGAG
    CTGCAGCTGC GCTACAACGG TGTCGGCCGT GTCACCAGCA GCGGCCCGGT CATCAACCAT
    GGCATGTGGC AGACAATCTC TGTTGAGGAG CTGGCACGGA ATCTGGTCAT CAAGGTCAAC
    AGGGACGCTG TCATGAAAAT CGCGGTGGCC GGGGACTTGT TCCAACCGGA GCGAGGACTA
    TATCATCTGA ACCTCACTGT GGGAGGTATT CCCTTCCATG AGAAGGACCT CGTGCAGCCT
    ATAAACCCTC GTCTGGATGG CTGCATGAGG AGCTGGAACT GGCTGAACGG AGAAGACACC
    ACCATCCAGG AAACAGTGAA AGCGAACACG AGGATGCAGT GCTTCTCGGT GACGGAGAGA
    GGCTCTTTCT ACCCCGGGAG CGGCTTTGCC TTCTACAGCC TGGACTACAT GCGGACCCCT
    CTGGACATCG GGACTGAATC AACCTGGGAA ATAGAAGTCG TGGCTCACAT CCGCCCAGCC
    GCAGACACGG GCGTGCTGTT CGCGCTCTGG GTCCCCGACC TCCGTGCTGT GCCTCTCTCT
    GTGGCCCTGG TAGACTATCA CTCCACGAAG AAACTCAAGA AGCAGCTGGT GGTCCTGGCC
    GTGGAGCACG TGGCCTTGGC CCTAATGGAG ATCAAGGTCT GCGATGGCCA AGAGCACGTG
    GTCACCGTCT CGCTGAGGGA CGGTGAGGCC ACCCTGGAGG TGGACGGCAC CAGGGGCCAG
    AGCGAGGTGA GCGCCACGCA GCTGCAGGAG AGGCTGGCCG TGCTCGAGAG GCACCTGCGG
    AGCCCCGTGC TCACCTTTGC CGGCGGCCTG CCAGATGTGC CGGTGACTTC AGCGCCAGTC
    ACCGCATTCT ACCGCGGCTG CATGACACTG GAGGTCAACC GGAGGCTGCT GGACCTGGAC
    GAGGCGGCGT ACAAGCACAG CGACATCACG GCCCACTCCT GCCCCCCCGT GGAGCCCGCC
    GCAGCCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008955770.1
    CDS356..1984
    Translation

    Target ORF information:

    RefSeq Version XM_008957522.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus growth arrest specific 6 (GAS6), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008957522.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    ATGGGCAACT TCTTCTGCCT GTGTAAAGCT GGCTGGGGGG GCCGGCTCTG CGACAAAGAT 
    GTCAACGAAT GCAGCCAGGA GAACGGGGGC TGCCTCCAGA TCTGCCACAA CAAGCCGGGC
    AGCTTCCACT GTTCCTGCCA CAGCGGCTTC GAGCTCTCCT CTGATGGCAG GACCTGCCAA
    GACATAGACG AGTGCGCAGA CTCGGAGGCC TGCGGGGAGG CGCGCTGCAA GAACCTGCCC
    GGCTCCTACT CCTGCCTCTG TGACGAGGGC TTTGCGTACA GCTCCCAGGA GAAGGCTTGC
    CGAGATGTGG ACGAGTGTCT GCAGGGCCGC TGTGAGCAGG TCTGCGTGAA CTCCCCAGGG
    AGCTACACCT GCCACTGTGA CGGGCGTGGG GGCCTCAAGC TGTCCCAGGA CATGGACACC
    TGTGAGGACA TCTTGCCGTG CGTGCCCTTC AGCGTGGCCA AGAGTGTGAA GTCCTTGTAC
    CTGGGCCGGA TGTTCAGTGG GACCCCCGTG ATCCGACTGC GCTTCAAGAG GCTGCAGCCC
    ACCAGGCTCG TAGCTGAGTT TGACTTCCGG ACCTTTGACC CCGAGGGCAT CCTCCTCTTC
    GCCGGAGGCC ACCAGGACAG CACCTGGATC GTGCTGGCCC TGAGAGCCGG CCGGCTGGAG
    CTGCAGCTGC GCTACAACGG TGTCGGCCGT GTCACCAGCA GCGGCCCGGT CATCAACCAT
    GGCATGTGGC AGACAATCTC TGTTGAGGAG CTGGCACGGA ATCTGGTCAT CAAGGTCAAC
    AGGGACGCTG TCATGAAAAT CGCGGTGGCC GGGGACTTGT TCCAACCGGA GCGAGGACTA
    TATCATCTGA ACCTCACTGT GGGAGGTATT CCCTTCCATG AGAAGGACCT CGTGCAGCCT
    ATAAACCCTC GTCTGGATGG CTGCATGAGG AGCTGGAACT GGCTGAACGG AGAAGACACC
    ACCATCCAGG AAACAGTGAA AGCGAACACG AGGATGCAGT GCTTCTCGGT GACGGAGAGA
    GGCTCTTTCT ACCCCGGGAG CGGCTTTGCC TTCTACAGCC TGGACTACAT GCGGACCCCT
    CTGGACATCG GGACTGAATC AACCTGGGAA ATAGAAGTCG TGGCTCACAT CCGCCCAGCC
    GCAGACACGG GCGTGCTGTT CGCGCTCTGG GTCCCCGACC TCCGTGCTGT GCCTCTCTCT
    GTGGCCCTGG TAGACTATCA CTCCACGAAG AAACTCAAGA AGCAGCTGGT GGTCCTGGCC
    GTGGAGCACG TGGCCTTGGC CCTAATGGAG ATCAAGGTCT GCGATGGCCA AGAGCACGTG
    GTCACCGTCT CGCTGAGGGA CGGTGAGGCC ACCCTGGAGG TGGACGGCAC CAGGGGCCAG
    AGCGAGGTGA GCGCCACGCA GCTGCAGGAG AGGCTGGCCG TGCTCGAGAG GCACCTGCGG
    AGCCCCGTGC TCACCTTTGC CGGCGGCCTG CCAGATGTGC CGGTGACTTC AGCGCCAGTC
    ACCGCATTCT ACCGCGGCTG CATGACACTG GAGGTCAACC GGAGGCTGCT GGACCTGGAC
    GAGGCGGCGT ACAAGCACAG CGACATCACG GCCCACTCCT GCCCCCCCGT GGAGCCCGCC
    GCAGCCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.