FBXL18 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

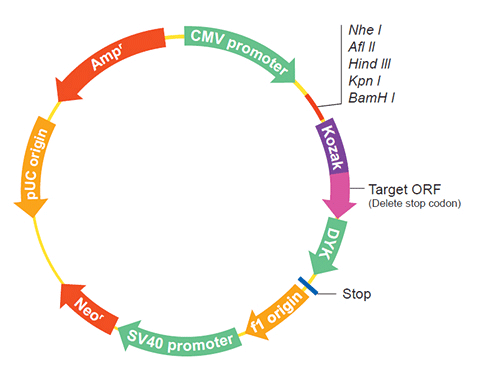
The following FBXL18 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the FBXL18 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa53186 XM_008973175.2
Latest version!
Pan paniscus F-box and leucine rich repeat protein 18 (FBXL18), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa53187 XM_008973176.1
Latest version!
Pan paniscus F-box and leucine rich repeat protein 18 (FBXL18), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa53188 XM_014345544.1
Latest version!
Pan paniscus F-box and leucine rich repeat protein 18 (FBXL18), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa53189 XM_008973177.1
Latest version!
Pan paniscus F-box and leucine rich repeat protein 18 (FBXL18), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa53186
    Clone ID Related Accession (Same CDS sequence) XM_008973175.2
    Accession Version XM_008973175.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2256bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product F-box/LRR-repeat protein 18 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027875.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_008973175.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGGCCAGCT CCGGAGAGGA CATATCCAAT GATGATGATG ACATGCACCC TGCAGCAGCC 
    GGGATGGCGG ACGGGGTCCA CCTCCTAGGG TTCTCTGATG AGATCCTCCT TCACATCCTG
    AGTCACGTCC CCAGCACAGA TCTGATTCTG AACGTCCGGC GTACCTGTCG GAAGCTTGCA
    GCCCTGTGCC TTGACAAGAG CCTCATCCAC ACCGTGTTGC TGCAAAAGGA CTATCAGGCG
    AGCGAGGACA AAGTGAGGCA GCTGGTGAAG GAGATCGGCC GGGAGATCCA GCAGCTGAGC
    ATGGCTGGCT GCTACTGGCT GCCTGGCTCC ACCGTGGAAC ACGTGGCCCG CTGCCGCAGC
    CTGGTGAAGG TGAACCTCTC GGGCTGCCAC CTCACCTCCC TGCGCCTCTC CAAGATGCTC
    TCGGCCCTGC AGCACCTGCG CTCGCTGGCC ATCGACGTGA GCCCCGGCTT CGACGCCAGC
    CAGCTGAGCA GCGAGTGCAA GGCCACCCTG AGCCGCGTGC GGGAGCTCAA GCAGACGCTG
    TTCACTCCCT CCTACGGCGT GGTGCCCTGC TGCACCAGCC TAGAGAAGCT GCTGCTCTAC
    TTCGAGATTC TGGACCGCAC GCGCGAGGGC GCCATCCTCT CGGGCCAGCT TATGGTGGGC
    CAGAGCAACG TGCCGCACTA CCAGAACCTG CGGGTCTTCT ATGCGCGCCT GGCCCCCGGC
    TACATCAACC AGGAGGTGGT GCGGCTCTAC CTGGCTGTGC TTAGCGACCG CACTCCTCAG
    AACCTCCACG CCTTCCTCAT CTCCGTCCCT GGCAGCTTCG CGGAGAGCGG CGCCACCAAG
    AACCTCCTGG ACTCCATGGC GCGCAATGTC GTGCTGGATG CCCTGCAGCT GCCCAAGTCC
    TGGCTGAACG GCTCTTCCCT CCTGCAGCAC ATGAAATTCA ACAACCCGTT CTACTTCAGT
    TTCAGCCGCT GTACCCTGTC AGGCGGCCAT CTGATCCAGC AGGTCATCAA CGGCGGGAAG
    GACCTGCGGA GCCTGGCCAG CTTGAACCTC AGCGGCTGCG TCCACTGCCT GTCCCCAGAC
    TCGCTGCTCC GCAAGGCGGA GGACGACATC GACAGCAGCA TCCTGGAGAC GCTGGTGGCG
    TCCTGCTGCA ACCTGCGCCA CCTGAACCTC TCGGCCGCCC ACCACCACAG CTCGGAGGGC
    CTGGGCCGGC ACCTCTGCCA GCTCCTGGCC CGGCTGCGTC ACCTGCGCTC CCTCTCCCTG
    CCTGTCTGCT CTGTCGCTGA CTCCGCCCCG CGCGCCGACC GCGCGCCCGC CCAGCCGGCC
    ATGCACGCAG TGCCGCGCGG CTTTGGCAAG AAAGTGCGTG TGGGCGTGCA GTCCTGTCCC
    AGCCCCTTCT CGGGCCAGGC GGGCCCCCAG CCCTCCTCCG TGTTCTGGTC TCTGCTGAAG
    AACCTGCCCT TCCTGGAACA CCTCGAGCTG ATCGGGTCCA ACTTCTCCTC CGCCATGCCC
    CGCAACGAGC CCGCCATCCG CAACTCGCTC CCACCCTGCA GCCGCGCACA GAGCGTCGGG
    GACTCGGAGG TGGCCGCCAT CGGCCAGCTG GCCTTCCTGC GGCACCTGAC GCTCGCACAG
    CTGCCCAGCG TCCTTACGGG CTCCGGGCTG GTCAATATCG GCCTGCAGTG CCAGCAGTTA
    CGGTCCCTGT CGCTGGCCAA CCTGGGCATG ATGGGGAAGG TGGTGTACAT GCCCGCGCTC
    TCAGACATGT TGAAGCACTG CAAGCGGCTG AGGGACCTCA GGCTGGAGCA GCCCTACTTC
    AGCGCCAACG CCCAGTTCTT CCAGGCGCTG AGCCAGTGCC CCTCGCTGCA GCGCCTGTGC
    CTGGTCTCTC GCAGCGGCAC CCTCCAGCCT GATGCCGTGC TGGCTTTCAT GGCTCGCTGC
    CTGCAGGTCG TCATGTGCCA CCTGTTCACC GGGGAGTCCC TCGCCACCTG CAAGAGCCTG
    CAGCAGTCGC TTCTCCGCAG GGCATCCTGG AGTTTGATGC TCCGCTGCTG CGCAGGAAGT
    CAGGTGGGGA GAGGTGACAG GAAGGAGGCC CCAGCTGTTC ACAGAGTTGC AGGAAGAGCC
    ATCAGCCAGG ACGTCTTGAG CCACTGGGCC CCGACAACCC TGCTTGCCAG ACTCTGGGGT
    AGTCTGTTGC CCTTGCGGTC TGCCGCTGGC TGTCTCAGGA ATAATCCTGG TTGGGGTTTC
    CCCCACTCTG GTTGTAAAAA CAACTTGTGT TTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971423.1
    CDS119..2374
    Translation

    Target ORF information:

    RefSeq Version XM_008973175.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus F-box and leucine rich repeat protein 18 (FBXL18), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973175.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    ATGGCCAGCT CCGGAGAGGA CATATCCAAT GATGATGATG ACATGCACCC TGCAGCAGCC 
    GGGATGGCGG ACGGGGTCCA CCTCCTAGGG TTCTCTGATG AGATCCTCCT TCACATCCTG
    AGTCACGTCC CCAGCACAGA TCTGATTCTG AACGTCCGGC GTACCTGTCG GAAGCTTGCA
    GCCCTGTGCC TTGACAAGAG CCTCATCCAC ACCGTGTTGC TGCAAAAGGA CTATCAGGCG
    AGCGAGGACA AAGTGAGGCA GCTGGTGAAG GAGATCGGCC GGGAGATCCA GCAGCTGAGC
    ATGGCTGGCT GCTACTGGCT GCCTGGCTCC ACCGTGGAAC ACGTGGCCCG CTGCCGCAGC
    CTGGTGAAGG TGAACCTCTC GGGCTGCCAC CTCACCTCCC TGCGCCTCTC CAAGATGCTC
    TCGGCCCTGC AGCACCTGCG CTCGCTGGCC ATCGACGTGA GCCCCGGCTT CGACGCCAGC
    CAGCTGAGCA GCGAGTGCAA GGCCACCCTG AGCCGCGTGC GGGAGCTCAA GCAGACGCTG
    TTCACTCCCT CCTACGGCGT GGTGCCCTGC TGCACCAGCC TAGAGAAGCT GCTGCTCTAC
    TTCGAGATTC TGGACCGCAC GCGCGAGGGC GCCATCCTCT CGGGCCAGCT TATGGTGGGC
    CAGAGCAACG TGCCGCACTA CCAGAACCTG CGGGTCTTCT ATGCGCGCCT GGCCCCCGGC
    TACATCAACC AGGAGGTGGT GCGGCTCTAC CTGGCTGTGC TTAGCGACCG CACTCCTCAG
    AACCTCCACG CCTTCCTCAT CTCCGTCCCT GGCAGCTTCG CGGAGAGCGG CGCCACCAAG
    AACCTCCTGG ACTCCATGGC GCGCAATGTC GTGCTGGATG CCCTGCAGCT GCCCAAGTCC
    TGGCTGAACG GCTCTTCCCT CCTGCAGCAC ATGAAATTCA ACAACCCGTT CTACTTCAGT
    TTCAGCCGCT GTACCCTGTC AGGCGGCCAT CTGATCCAGC AGGTCATCAA CGGCGGGAAG
    GACCTGCGGA GCCTGGCCAG CTTGAACCTC AGCGGCTGCG TCCACTGCCT GTCCCCAGAC
    TCGCTGCTCC GCAAGGCGGA GGACGACATC GACAGCAGCA TCCTGGAGAC GCTGGTGGCG
    TCCTGCTGCA ACCTGCGCCA CCTGAACCTC TCGGCCGCCC ACCACCACAG CTCGGAGGGC
    CTGGGCCGGC ACCTCTGCCA GCTCCTGGCC CGGCTGCGTC ACCTGCGCTC CCTCTCCCTG
    CCTGTCTGCT CTGTCGCTGA CTCCGCCCCG CGCGCCGACC GCGCGCCCGC CCAGCCGGCC
    ATGCACGCAG TGCCGCGCGG CTTTGGCAAG AAAGTGCGTG TGGGCGTGCA GTCCTGTCCC
    AGCCCCTTCT CGGGCCAGGC GGGCCCCCAG CCCTCCTCCG TGTTCTGGTC TCTGCTGAAG
    AACCTGCCCT TCCTGGAACA CCTCGAGCTG ATCGGGTCCA ACTTCTCCTC CGCCATGCCC
    CGCAACGAGC CCGCCATCCG CAACTCGCTC CCACCCTGCA GCCGCGCACA GAGCGTCGGG
    GACTCGGAGG TGGCCGCCAT CGGCCAGCTG GCCTTCCTGC GGCACCTGAC GCTCGCACAG
    CTGCCCAGCG TCCTTACGGG CTCCGGGCTG GTCAATATCG GCCTGCAGTG CCAGCAGTTA
    CGGTCCCTGT CGCTGGCCAA CCTGGGCATG ATGGGGAAGG TGGTGTACAT GCCCGCGCTC
    TCAGACATGT TGAAGCACTG CAAGCGGCTG AGGGACCTCA GGCTGGAGCA GCCCTACTTC
    AGCGCCAACG CCCAGTTCTT CCAGGCGCTG AGCCAGTGCC CCTCGCTGCA GCGCCTGTGC
    CTGGTCTCTC GCAGCGGCAC CCTCCAGCCT GATGCCGTGC TGGCTTTCAT GGCTCGCTGC
    CTGCAGGTCG TCATGTGCCA CCTGTTCACC GGGGAGTCCC TCGCCACCTG CAAGAGCCTG
    CAGCAGTCGC TTCTCCGCAG GGCATCCTGG AGTTTGATGC TCCGCTGCTG CGCAGGAAGT
    CAGGTGGGGA GAGGTGACAG GAAGGAGGCC CCAGCTGTTC ACAGAGTTGC AGGAAGAGCC
    ATCAGCCAGG ACGTCTTGAG CCACTGGGCC CCGACAACCC TGCTTGCCAG ACTCTGGGGT
    AGTCTGTTGC CCTTGCGGTC TGCCGCTGGC TGTCTCAGGA ATAATCCTGG TTGGGGTTTC
    CCCCACTCTG GTTGTAAAAA CAACTTGTGT TTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa53187
    Clone ID Related Accession (Same CDS sequence) XM_008973176.1
    Accession Version XM_008973176.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2157bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product F-box/LRR-repeat protein 18 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027875.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGGCCAGCT CCGGAGAGGA CATATCCAAT GATGATGATG ACATGCACCC TGCAGCAGCC 
    GGGATGGCGG ACGGGGTCCA CCTCCTAGGG TTCTCTGATG AGATCCTCCT TCACATCCTG
    AGTCACGTCC CCAGCACAGA TCTGATTCTG AACGTCCGGC GTACCTGTCG GAAGCTTGCA
    GCCCTGTGCC TTGACAAGAG CCTCATCCAC ACCGTGTTGC TGCAAAAGGA CTATCAGGCG
    AGCGAGGACA AAGTGAGGCA GCTGGTGAAG GAGATCGGCC GGGAGATCCA GCAGCTGAGC
    ATGGCTGGCT GCTACTGGCT GCCTGGCTCC ACCGTGGAAC ACGTGGCCCG CTGCCGCAGC
    CTGGTGAAGG TGAACCTCTC GGGCTGCCAC CTCACCTCCC TGCGCCTCTC CAAGATGCTC
    TCGGCCCTGC AGCACCTGCG CTCGCTGGCC ATCGACGTGA GCCCCGGCTT CGACGCCAGC
    CAGCTGAGCA GCGAGTGCAA GGCCACCCTG AGCCGCGTGC GGGAGCTCAA GCAGACGCTG
    TTCACTCCCT CCTACGGCGT GGTGCCCTGC TGCACCAGCC TAGAGAAGCT GCTGCTCTAC
    TTCGAGATTC TGGACCGCAC GCGCGAGGGC GCCATCCTCT CGGGCCAGCT TATGGTGGGC
    CAGAGCAACG TGCCGCACTA CCAGAACCTG CGGGTCTTCT ATGCGCGCCT GGCCCCCGGC
    TACATCAACC AGGAGGTGGT GCGGCTCTAC CTGGCTGTGC TTAGCGACCG CACTCCTCAG
    AACCTCCACG CCTTCCTCAT CTCCGTCCCT GGCAGCTTCG CGGAGAGCGG CGCCACCAAG
    AACCTCCTGG ACTCCATGGC GCGCAATGTC GTGCTGGATG CCCTGCAGCT GCCCAAGTCC
    TGGCTGAACG GCTCTTCCCT CCTGCAGCAC ATGAAATTCA ACAACCCGTT CTACTTCAGT
    TTCAGCCGCT GTACCCTGTC AGGCGGCCAT CTGATCCAGC AGGTCATCAA CGGCGGGAAG
    GACCTGCGGA GCCTGGCCAG CTTGAACCTC AGCGGCTGCG TCCACTGCCT GTCCCCAGAC
    TCGCTGCTCC GCAAGGCGGA GGACGACATC GACAGCAGCA TCCTGGAGAC GCTGGTGGCG
    TCCTGCTGCA ACCTGCGCCA CCTGAACCTC TCGGCCGCCC ACCACCACAG CTCGGAGGGC
    CTGGGCCGGC ACCTCTGCCA GCTCCTGGCC CGGCTGCGTC ACCTGCGCTC CCTCTCCCTG
    CCTGTCTGCT CTGTCGCTGA CTCCGCCCCG CGCGCCGACC GCGCGCCCGC CCAGCCGGCC
    ATGCACGCAG TGCCGCGCGG CTTTGGCAAG AAAGTGCGTG TGGGCGTGCA GTCCTGTCCC
    AGCCCCTTCT CGGGCCAGGC GGGCCCCCAG CCCTCCTCCG TGTTCTGGTC TCTGCTGAAG
    AACCTGCCCT TCCTGGAACA CCTCGAGCTG ATCGGGTCCA ACTTCTCCTC CGCCATGCCC
    CGCAACGAGC CCGCCATCCG CAACTCGCTC CCACCCTGCA GCCGCGCACA GAGCGTCGGG
    GACTCGGAGG TGGCCGCCAT CGGCCAGCTG GCCTTCCTGC GGCACCTGAC GCTCGCACAG
    CTGCCCAGCG TCCTTACGGG CTCCGGGCTG GTCAATATCG GCCTGCAGTG CCAGCAGTTA
    CGGTCCCTGT CGCTGGCCAA CCTGGGCATG ATGGGGAAGG TGGTGTACAT GCCCGCGCTC
    TCAGACATGT TGAAGCACTG CAAGCGGCTG AGGGACCTCA GGCTGGAGCA GCCCTACTTC
    AGCGCCAACG CCCAGTTCTT CCAGGCGCTG AGCCAGTGCC CCTCGCTGCA GCGCCTGTGC
    CTGGTCTCTC GCAGCGGCAC CCTCCAGCCT GATGCCGTGC TGGCTTTCAT GGCTCGCTGC
    CTGCAGGTCG TCATGTGCCA CCTGTTCACC GGGGAGTCCC TCGCCACCTG CAAGAGCCTG
    CAGCAGTCGC TTCTCCGCAG CTTCCAGGCC GAGCGGCCCG CGTTAAACGT CGTCGTCTTC
    CCTCTGCTCC ACGAGGGCCT GACCGACGTC ATCCGGGACG TCCCCCTGGT GCACCTGGAT
    GAGATCACCT TATTTAAGAG CAGAGTGGCC GAGGAACCGC CGAACCTGTG GTGGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971424.1
    CDS119..2275
    Translation

    Target ORF information:

    RefSeq Version XM_008973176.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus F-box and leucine rich repeat protein 18 (FBXL18), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973176.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGGCCAGCT CCGGAGAGGA CATATCCAAT GATGATGATG ACATGCACCC TGCAGCAGCC 
    GGGATGGCGG ACGGGGTCCA CCTCCTAGGG TTCTCTGATG AGATCCTCCT TCACATCCTG
    AGTCACGTCC CCAGCACAGA TCTGATTCTG AACGTCCGGC GTACCTGTCG GAAGCTTGCA
    GCCCTGTGCC TTGACAAGAG CCTCATCCAC ACCGTGTTGC TGCAAAAGGA CTATCAGGCG
    AGCGAGGACA AAGTGAGGCA GCTGGTGAAG GAGATCGGCC GGGAGATCCA GCAGCTGAGC
    ATGGCTGGCT GCTACTGGCT GCCTGGCTCC ACCGTGGAAC ACGTGGCCCG CTGCCGCAGC
    CTGGTGAAGG TGAACCTCTC GGGCTGCCAC CTCACCTCCC TGCGCCTCTC CAAGATGCTC
    TCGGCCCTGC AGCACCTGCG CTCGCTGGCC ATCGACGTGA GCCCCGGCTT CGACGCCAGC
    CAGCTGAGCA GCGAGTGCAA GGCCACCCTG AGCCGCGTGC GGGAGCTCAA GCAGACGCTG
    TTCACTCCCT CCTACGGCGT GGTGCCCTGC TGCACCAGCC TAGAGAAGCT GCTGCTCTAC
    TTCGAGATTC TGGACCGCAC GCGCGAGGGC GCCATCCTCT CGGGCCAGCT TATGGTGGGC
    CAGAGCAACG TGCCGCACTA CCAGAACCTG CGGGTCTTCT ATGCGCGCCT GGCCCCCGGC
    TACATCAACC AGGAGGTGGT GCGGCTCTAC CTGGCTGTGC TTAGCGACCG CACTCCTCAG
    AACCTCCACG CCTTCCTCAT CTCCGTCCCT GGCAGCTTCG CGGAGAGCGG CGCCACCAAG
    AACCTCCTGG ACTCCATGGC GCGCAATGTC GTGCTGGATG CCCTGCAGCT GCCCAAGTCC
    TGGCTGAACG GCTCTTCCCT CCTGCAGCAC ATGAAATTCA ACAACCCGTT CTACTTCAGT
    TTCAGCCGCT GTACCCTGTC AGGCGGCCAT CTGATCCAGC AGGTCATCAA CGGCGGGAAG
    GACCTGCGGA GCCTGGCCAG CTTGAACCTC AGCGGCTGCG TCCACTGCCT GTCCCCAGAC
    TCGCTGCTCC GCAAGGCGGA GGACGACATC GACAGCAGCA TCCTGGAGAC GCTGGTGGCG
    TCCTGCTGCA ACCTGCGCCA CCTGAACCTC TCGGCCGCCC ACCACCACAG CTCGGAGGGC
    CTGGGCCGGC ACCTCTGCCA GCTCCTGGCC CGGCTGCGTC ACCTGCGCTC CCTCTCCCTG
    CCTGTCTGCT CTGTCGCTGA CTCCGCCCCG CGCGCCGACC GCGCGCCCGC CCAGCCGGCC
    ATGCACGCAG TGCCGCGCGG CTTTGGCAAG AAAGTGCGTG TGGGCGTGCA GTCCTGTCCC
    AGCCCCTTCT CGGGCCAGGC GGGCCCCCAG CCCTCCTCCG TGTTCTGGTC TCTGCTGAAG
    AACCTGCCCT TCCTGGAACA CCTCGAGCTG ATCGGGTCCA ACTTCTCCTC CGCCATGCCC
    CGCAACGAGC CCGCCATCCG CAACTCGCTC CCACCCTGCA GCCGCGCACA GAGCGTCGGG
    GACTCGGAGG TGGCCGCCAT CGGCCAGCTG GCCTTCCTGC GGCACCTGAC GCTCGCACAG
    CTGCCCAGCG TCCTTACGGG CTCCGGGCTG GTCAATATCG GCCTGCAGTG CCAGCAGTTA
    CGGTCCCTGT CGCTGGCCAA CCTGGGCATG ATGGGGAAGG TGGTGTACAT GCCCGCGCTC
    TCAGACATGT TGAAGCACTG CAAGCGGCTG AGGGACCTCA GGCTGGAGCA GCCCTACTTC
    AGCGCCAACG CCCAGTTCTT CCAGGCGCTG AGCCAGTGCC CCTCGCTGCA GCGCCTGTGC
    CTGGTCTCTC GCAGCGGCAC CCTCCAGCCT GATGCCGTGC TGGCTTTCAT GGCTCGCTGC
    CTGCAGGTCG TCATGTGCCA CCTGTTCACC GGGGAGTCCC TCGCCACCTG CAAGAGCCTG
    CAGCAGTCGC TTCTCCGCAG CTTCCAGGCC GAGCGGCCCG CGTTAAACGT CGTCGTCTTC
    CCTCTGCTCC ACGAGGGCCT GACCGACGTC ATCCGGGACG TCCCCCTGGT GCACCTGGAT
    GAGATCACCT TATTTAAGAG CAGAGTGGCC GAGGAACCGC CGAACCTGTG GTGGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa53188
    Clone ID Related Accession (Same CDS sequence) XM_014345544.1
    Accession Version XM_014345544.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2076bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product F-box/LRR-repeat protein 18 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027875.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCCAGCT CCGGAGAGGA CATATCCAAT GATGATGATG ACATGCACCC TGCAGCAGCC 
    GGGATGGCGG ACGGGGTCCA CCTCCTAGGG TTCTCTGATG AGATCCTCCT TCACATCCTG
    AGTCACGTCC CCAGCACAGA TCTGATTCTG AACGTCCGGC GTACCTGTCG GAAGCTTGCA
    GCCCTGTGCC TTGACAAGAG CCTCATCCAC ACCGTGTTGC TGCAAAAGGA CTATCAGGCG
    AGCGAGGACA AAGTGAGGCA GCTGGTGAAG GAGATCGGCC GGGAGATCCA GCAGCTGAGC
    ATGGCTGGCT GCTACTGGCT GCCTGGCTCC ACCGTGGAAC ACGTGGCCCG CTGCCGCAGC
    CTGGTGAAGG TGAACCTCTC GGGCTGCCAC CTCACCTCCC TGCGCCTCTC CAAGATGCTC
    TCGGCCCTGC AGCACCTGCG CTCGCTGGCC ATCGACGTGA GCCCCGGCTT CGACGCCAGC
    CAGCTGAGCA GCGAGTGCAA GGCCACCCTG AGCCGCGTGC GGGAGCTCAA GCAGACGCTG
    TTCACTCCCT CCTACGGCGT GGTGCCCTGC TGCACCAGCC TAGAGAAGCT GCTGCTCTAC
    TTCGAGATTC TGGACCGCAC GCGCGAGGGC GCCATCCTCT CGGGCCAGCT TATGGTGGGC
    CAGAGCAACG TGCCGCACTA CCAGAACCTG CGGGTCTTCT ATGCGCGCCT GGCCCCCGGC
    TACATCAACC AGGAGGTGGT GCGGCTCTAC CTGGCTGTGC TTAGCGACCG CACTCCTCAG
    AACCTCCACG CCTTCCTCAT CTCCGTCCCT GGCAGCTTCG CGGAGAGCGG CGCCACCAAG
    AACCTCCTGG ACTCCATGGC GCGCAATGTC GTGCTGGATG CCCTGCAGCT GCCCAAGTCC
    TGGCTGAACG GCTCTTCCCT CCTGCAGCAC ATGAAATTCA ACAACCCGTT CTACTTCAGT
    TTCAGCCGCT GTACCCTGTC AGGCGGCCAT CTGATCCAGC AGGTCATCAA CGGCGGGAAG
    GACCTGCGGA GCCTGGCCAG CTTGAACCTC AGCGGCTGCG TCCACTGCCT GTCCCCAGAC
    TCGCTGCTCC GCAAGGCGGA GGACGACATC GACAGCAGCA TCCTGGAGAC GCTGGTGGCG
    TCCTGCTGCA ACCTGCGCCA CCTGAACCTC TCGGCCGCCC ACCACCACAG CTCGGAGGGC
    CTGGGCCGGC ACCTCTGCCA GCTCCTGGCC CGGCTGCGTC ACCTGCGCTC CCTCTCCCTG
    CCTGTCTGCT CTGTCGCTGA CTCCGCCCCG CGCGCCGACC GCGCGCCCGC CCAGCCGGCC
    ATGCACGCAG TGCCGCGCGG CTTTGGCAAG AAAGTGCGTG TGGGCGTGCA GTCCTGTCCC
    AGCCCCTTCT CGGGCCAGGC GGGCCCCCAG CCCTCCTCCG TGTTCTGGTC TCTGCTGAAG
    AACCTGCCCT TCCTGGAACA CCTCGAGCTG ATCGGGTCCA ACTTCTCCTC CGCCATGCCC
    CGCAACGAGC CCGCCATCCG CAACTCGCTC CCACCCTGCA GCCGCGCACA GAGCGTCGGG
    GACTCGGAGG TGGCCGCCAT CGGCCAGCTG GCCTTCCTGC GGCACCTGAC GCTCGCACAG
    CTGCCCAGCG TCCTTACGGG CTCCGGGCTG GTCAATATCG GCCTGCAGTG CCAGCAGTTA
    CGGTCCCTGT CGCTGGCCAA CCTGGGCATG ATGGGGAAGG TGGTGTACAT GCCCGCGCTC
    TCAGACATGT TGAAGCACTG CAAGCGGCTG AGGGACCTCA GGCTGGAGCA GCCCTACTTC
    AGCGCCAACG CCCAGTTCTT CCAGGCGCTG AGCCAGTGCC CCTCGCTGCA GCGCCTGTGC
    CTGGTCTCTC GCAGCGGCAC CCTCCAGCCT GATGCCGTGC TGGCTTTCAT GGCTCGCTGC
    CTGCAGGTCG TCATGTGCCA CCTGTTCACC GGGGAGTCCC TCGCCACCTG CAAGAGCCTG
    CAGCAGTCGC TTCTCCGCAG GTGGGGAGAG GTGACAGGAA GGAGGCCCCA GCTGTTCACA
    GAGTTGCAGG AAGAGCCATC AGCCAGGACG TCTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014201030.1
    CDS119..2194
    Translation

    Target ORF information:

    RefSeq Version XM_014345544.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus F-box and leucine rich repeat protein 18 (FBXL18), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014345544.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCCAGCT CCGGAGAGGA CATATCCAAT GATGATGATG ACATGCACCC TGCAGCAGCC 
    GGGATGGCGG ACGGGGTCCA CCTCCTAGGG TTCTCTGATG AGATCCTCCT TCACATCCTG
    AGTCACGTCC CCAGCACAGA TCTGATTCTG AACGTCCGGC GTACCTGTCG GAAGCTTGCA
    GCCCTGTGCC TTGACAAGAG CCTCATCCAC ACCGTGTTGC TGCAAAAGGA CTATCAGGCG
    AGCGAGGACA AAGTGAGGCA GCTGGTGAAG GAGATCGGCC GGGAGATCCA GCAGCTGAGC
    ATGGCTGGCT GCTACTGGCT GCCTGGCTCC ACCGTGGAAC ACGTGGCCCG CTGCCGCAGC
    CTGGTGAAGG TGAACCTCTC GGGCTGCCAC CTCACCTCCC TGCGCCTCTC CAAGATGCTC
    TCGGCCCTGC AGCACCTGCG CTCGCTGGCC ATCGACGTGA GCCCCGGCTT CGACGCCAGC
    CAGCTGAGCA GCGAGTGCAA GGCCACCCTG AGCCGCGTGC GGGAGCTCAA GCAGACGCTG
    TTCACTCCCT CCTACGGCGT GGTGCCCTGC TGCACCAGCC TAGAGAAGCT GCTGCTCTAC
    TTCGAGATTC TGGACCGCAC GCGCGAGGGC GCCATCCTCT CGGGCCAGCT TATGGTGGGC
    CAGAGCAACG TGCCGCACTA CCAGAACCTG CGGGTCTTCT ATGCGCGCCT GGCCCCCGGC
    TACATCAACC AGGAGGTGGT GCGGCTCTAC CTGGCTGTGC TTAGCGACCG CACTCCTCAG
    AACCTCCACG CCTTCCTCAT CTCCGTCCCT GGCAGCTTCG CGGAGAGCGG CGCCACCAAG
    AACCTCCTGG ACTCCATGGC GCGCAATGTC GTGCTGGATG CCCTGCAGCT GCCCAAGTCC
    TGGCTGAACG GCTCTTCCCT CCTGCAGCAC ATGAAATTCA ACAACCCGTT CTACTTCAGT
    TTCAGCCGCT GTACCCTGTC AGGCGGCCAT CTGATCCAGC AGGTCATCAA CGGCGGGAAG
    GACCTGCGGA GCCTGGCCAG CTTGAACCTC AGCGGCTGCG TCCACTGCCT GTCCCCAGAC
    TCGCTGCTCC GCAAGGCGGA GGACGACATC GACAGCAGCA TCCTGGAGAC GCTGGTGGCG
    TCCTGCTGCA ACCTGCGCCA CCTGAACCTC TCGGCCGCCC ACCACCACAG CTCGGAGGGC
    CTGGGCCGGC ACCTCTGCCA GCTCCTGGCC CGGCTGCGTC ACCTGCGCTC CCTCTCCCTG
    CCTGTCTGCT CTGTCGCTGA CTCCGCCCCG CGCGCCGACC GCGCGCCCGC CCAGCCGGCC
    ATGCACGCAG TGCCGCGCGG CTTTGGCAAG AAAGTGCGTG TGGGCGTGCA GTCCTGTCCC
    AGCCCCTTCT CGGGCCAGGC GGGCCCCCAG CCCTCCTCCG TGTTCTGGTC TCTGCTGAAG
    AACCTGCCCT TCCTGGAACA CCTCGAGCTG ATCGGGTCCA ACTTCTCCTC CGCCATGCCC
    CGCAACGAGC CCGCCATCCG CAACTCGCTC CCACCCTGCA GCCGCGCACA GAGCGTCGGG
    GACTCGGAGG TGGCCGCCAT CGGCCAGCTG GCCTTCCTGC GGCACCTGAC GCTCGCACAG
    CTGCCCAGCG TCCTTACGGG CTCCGGGCTG GTCAATATCG GCCTGCAGTG CCAGCAGTTA
    CGGTCCCTGT CGCTGGCCAA CCTGGGCATG ATGGGGAAGG TGGTGTACAT GCCCGCGCTC
    TCAGACATGT TGAAGCACTG CAAGCGGCTG AGGGACCTCA GGCTGGAGCA GCCCTACTTC
    AGCGCCAACG CCCAGTTCTT CCAGGCGCTG AGCCAGTGCC CCTCGCTGCA GCGCCTGTGC
    CTGGTCTCTC GCAGCGGCAC CCTCCAGCCT GATGCCGTGC TGGCTTTCAT GGCTCGCTGC
    CTGCAGGTCG TCATGTGCCA CCTGTTCACC GGGGAGTCCC TCGCCACCTG CAAGAGCCTG
    CAGCAGTCGC TTCTCCGCAG GTGGGGAGAG GTGACAGGAA GGAGGCCCCA GCTGTTCACA
    GAGTTGCAGG AAGAGCCATC AGCCAGGACG TCTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa53189
    Clone ID Related Accession (Same CDS sequence) XM_008973177.1
    Accession Version XM_008973177.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2055bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product F-box/LRR-repeat protein 18 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027875.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCCAGCT CCGGAGAGGA CATATCCAAT GATGATGATG ACATGCACCC TGCAGCAGCC 
    GGGATGGCGG ACGGGGTCCA CCTCCTAGGG TTCTCTGATG AGATCCTCCT TCACATCCTG
    AGTCACGTCC CCAGCACAGA TCTGATTCTG AACGTCCGGC GTACCTGTCG GAAGCTTGCA
    GCCCTGTGCC TTGACAAGAG CCTCATCCAC ACCGTGTTGC TGCAAAAGGA CTATCAGGCG
    AGCGAGGACA AAGTGAGGCA GCTGGTGAAG GAGATCGGCC GGGAGATCCA GCAGCTGAGC
    ATGGCTGGCT GCTACTGGCT GCCTGGCTCC ACCGTGGAAC ACGTGGCCCG CTGCCGCAGC
    CTGGTGAAGG TGAACCTCTC GGGCTGCCAC CTCACCTCCC TGCGCCTCTC CAAGATGCTC
    TCGGCCCTGC AGCACCTGCG CTCGCTGGCC ATCGACGTGA GCCCCGGCTT CGACGCCAGC
    CAGCTGAGCA GCGAGTGCAA GGCCACCCTG AGCCGCGTGC GGGAGCTCAA GCAGACGCTG
    TTCACTCCCT CCTACGGCGT GGTGCCCTGC TGCACCAGCC TAGAGAAGCT GCTGCTCTAC
    TTCGAGATTC TGGACCGCAC GCGCGAGGGC GCCATCCTCT CGGGCCAGCT TATGGTGGGC
    CAGAGCAACG TGCCGCACTA CCAGAACCTG CGGGTCTTCT ATGCGCGCCT GGCCCCCGGC
    TACATCAACC AGGAGGTGGT GCGGCTCTAC CTGGCTGTGC TTAGCGACCG CACTCCTCAG
    AACCTCCACG CCTTCCTCAT CTCCGTCCCT GGCAGCTTCG CGGAGAGCGG CGCCACCAAG
    AACCTCCTGG ACTCCATGGC GCGCAATGTC GTGCTGGATG CCCTGCAGCT GCCCAAGTCC
    TGGCTGAACG GCTCTTCCCT CCTGCAGCAC ATGAAATTCA ACAACCCGTT CTACTTCAGT
    TTCAGCCGCT GTACCCTGTC AGGCGGCCAT CTGATCCAGC AGGTCATCAA CGGCGGGAAG
    GACCTGCGGA GCCTGGCCAG CTTGAACCTC AGCGGCTGCG TCCACTGCCT GTCCCCAGAC
    TCGCTGCTCC GCAAGGCGGA GGACGACATC GACAGCAGCA TCCTGGAGAC GCTGGTGGCG
    TCCTGCTGCA ACCTGCGCCA CCTGAACCTC TCGGCCGCCC ACCACCACAG CTCGGAGGGC
    CTGGGCCGGC ACCTCTGCCA GCTCCTGGCC CGGCTGCGTC ACCTGCGCTC CCTCTCCCTG
    CCTGTCTGCT CTGTCGCTGA CTCCGCCCCG CGCGCCGACC GCGCGCCCGC CCAGCCGGCC
    ATGCACGCAG TGCCGCGCGG CTTTGGCAAG AAAGTGCGTG TGGGCGTGCA GTCCTGTCCC
    AGCCCCTTCT CGGGCCAGGC GGGCCCCCAG CCCTCCTCCG TGTTCTGGTC TCTGCTGAAG
    AACCTGCCCT TCCTGGAACA CCTCGAGCTG ATCGGGTCCA ACTTCTCCTC CGCCATGCCC
    CGCAACGAGC CCGCCATCCG CAACTCGCTC CCACCCTGCA GCCGCGCACA GAGCGTCGGG
    GACTCGGAGG TGGCCGCCAT CGGCCAGCTG GCCTTCCTGC GGCACCTGAC GCTCGCACAG
    CTGCCCAGCG TCCTTACGGG CTCCGGGCTG GTCAATATCG GCCTGCAGTG CCAGCAGTTA
    CGGTCCCTGT CGCTGGCCAA CCTGGGCATG ATGGGGAAGG TGGTGTACAT GCCCGCGCTC
    TCAGACATGT TGAAGCACTG CAAGCGGCTG AGGGACCTCA GGCTGGAGCA GCCCTACTTC
    AGCGCCAACG CCCAGTTCTT CCAGGCGCTG AGCCAGTGCC CCTCGCTGCA GCGCCTGTGC
    CTGGTCTCTC GCAGCGGCAC CCTCCAGCCT GATGCCGTGC TGGCTTTCAT GGCTCGCTGC
    CTGCAGGTCG TCATGTGCCA CCTGTTCACC GGGGAGTCCC TCGCCACCTG CAAGAGCCTG
    CAGCAGTCGC TTCTCCGCAG GGCATCCTGG AGTTTGATGC TCCGCTGCTG CGCAGGAAGT
    CAGGTGAGCA CCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971425.1
    CDS119..2173
    Translation

    Target ORF information:

    RefSeq Version XM_008973177.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus F-box and leucine rich repeat protein 18 (FBXL18), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973177.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGGCCAGCT CCGGAGAGGA CATATCCAAT GATGATGATG ACATGCACCC TGCAGCAGCC 
    GGGATGGCGG ACGGGGTCCA CCTCCTAGGG TTCTCTGATG AGATCCTCCT TCACATCCTG
    AGTCACGTCC CCAGCACAGA TCTGATTCTG AACGTCCGGC GTACCTGTCG GAAGCTTGCA
    GCCCTGTGCC TTGACAAGAG CCTCATCCAC ACCGTGTTGC TGCAAAAGGA CTATCAGGCG
    AGCGAGGACA AAGTGAGGCA GCTGGTGAAG GAGATCGGCC GGGAGATCCA GCAGCTGAGC
    ATGGCTGGCT GCTACTGGCT GCCTGGCTCC ACCGTGGAAC ACGTGGCCCG CTGCCGCAGC
    CTGGTGAAGG TGAACCTCTC GGGCTGCCAC CTCACCTCCC TGCGCCTCTC CAAGATGCTC
    TCGGCCCTGC AGCACCTGCG CTCGCTGGCC ATCGACGTGA GCCCCGGCTT CGACGCCAGC
    CAGCTGAGCA GCGAGTGCAA GGCCACCCTG AGCCGCGTGC GGGAGCTCAA GCAGACGCTG
    TTCACTCCCT CCTACGGCGT GGTGCCCTGC TGCACCAGCC TAGAGAAGCT GCTGCTCTAC
    TTCGAGATTC TGGACCGCAC GCGCGAGGGC GCCATCCTCT CGGGCCAGCT TATGGTGGGC
    CAGAGCAACG TGCCGCACTA CCAGAACCTG CGGGTCTTCT ATGCGCGCCT GGCCCCCGGC
    TACATCAACC AGGAGGTGGT GCGGCTCTAC CTGGCTGTGC TTAGCGACCG CACTCCTCAG
    AACCTCCACG CCTTCCTCAT CTCCGTCCCT GGCAGCTTCG CGGAGAGCGG CGCCACCAAG
    AACCTCCTGG ACTCCATGGC GCGCAATGTC GTGCTGGATG CCCTGCAGCT GCCCAAGTCC
    TGGCTGAACG GCTCTTCCCT CCTGCAGCAC ATGAAATTCA ACAACCCGTT CTACTTCAGT
    TTCAGCCGCT GTACCCTGTC AGGCGGCCAT CTGATCCAGC AGGTCATCAA CGGCGGGAAG
    GACCTGCGGA GCCTGGCCAG CTTGAACCTC AGCGGCTGCG TCCACTGCCT GTCCCCAGAC
    TCGCTGCTCC GCAAGGCGGA GGACGACATC GACAGCAGCA TCCTGGAGAC GCTGGTGGCG
    TCCTGCTGCA ACCTGCGCCA CCTGAACCTC TCGGCCGCCC ACCACCACAG CTCGGAGGGC
    CTGGGCCGGC ACCTCTGCCA GCTCCTGGCC CGGCTGCGTC ACCTGCGCTC CCTCTCCCTG
    CCTGTCTGCT CTGTCGCTGA CTCCGCCCCG CGCGCCGACC GCGCGCCCGC CCAGCCGGCC
    ATGCACGCAG TGCCGCGCGG CTTTGGCAAG AAAGTGCGTG TGGGCGTGCA GTCCTGTCCC
    AGCCCCTTCT CGGGCCAGGC GGGCCCCCAG CCCTCCTCCG TGTTCTGGTC TCTGCTGAAG
    AACCTGCCCT TCCTGGAACA CCTCGAGCTG ATCGGGTCCA ACTTCTCCTC CGCCATGCCC
    CGCAACGAGC CCGCCATCCG CAACTCGCTC CCACCCTGCA GCCGCGCACA GAGCGTCGGG
    GACTCGGAGG TGGCCGCCAT CGGCCAGCTG GCCTTCCTGC GGCACCTGAC GCTCGCACAG
    CTGCCCAGCG TCCTTACGGG CTCCGGGCTG GTCAATATCG GCCTGCAGTG CCAGCAGTTA
    CGGTCCCTGT CGCTGGCCAA CCTGGGCATG ATGGGGAAGG TGGTGTACAT GCCCGCGCTC
    TCAGACATGT TGAAGCACTG CAAGCGGCTG AGGGACCTCA GGCTGGAGCA GCCCTACTTC
    AGCGCCAACG CCCAGTTCTT CCAGGCGCTG AGCCAGTGCC CCTCGCTGCA GCGCCTGTGC
    CTGGTCTCTC GCAGCGGCAC CCTCCAGCCT GATGCCGTGC TGGCTTTCAT GGCTCGCTGC
    CTGCAGGTCG TCATGTGCCA CCTGTTCACC GGGGAGTCCC TCGCCACCTG CAAGAGCCTG
    CAGCAGTCGC TTCTCCGCAG GGCATCCTGG AGTTTGATGC TCCGCTGCTG CGCAGGAAGT
    CAGGTGAGCA CCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.