LOC106669163 cDNA ORF clone, Cimex lectularius(bed bug)

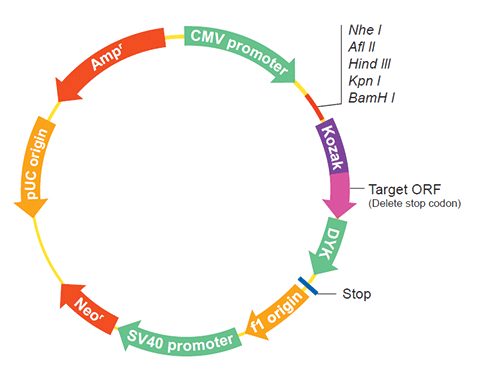
The following LOC106669163 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC106669163 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OCi33322 XM_014398465.2
Latest version!
Cimex lectularius RNA-binding protein 5 (LOC106669163), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
View Old Accession Versions >>
OCi33322 XM_014398465.1 Cimex lectularius RNA-binding protein 5 (LOC106669163), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OCi33322
    Clone ID Related Accession (Same CDS sequence) XM_014398465.1 , XM_014398465.2
    Accession Version XM_014398465.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2772bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-10-15
    Organism Cimex lectularius(bed bug)
    Product RNA-binding protein 5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014465071.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Cimex lectularius Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGGACCGAA GGCAATTTGG CGAAAATTAC TATGGGAGGC ATTACCAAGG CAGCCCATTC 
    TTCAATCCTG GTGGCCAGAA ATCTGCTGAA GAAGAGTTGG TAGCCCGGAG CAAAGAATGG
    ATGAACAGAC AAGATAGAGA CAGAGACCAG TGGAGGAGAT CTGTCGATGA TTTTCTAGAT
    GATAAAAGTA GCAGTAGGTA TCATAAGAGT AGGGACAGGT CTCGAGAAAG GTCTAGGTCC
    AGGGAAAGGG GGGAAAGAAA AGAGAGAAAA CGTTCTCGTG AAAGGAGTAG GGAGCGGGAA
    TCTTCGCGGC GATGGTCACC GGAAGATGAT GAAAGAGATA CAACAAATAC AAGAAGACGG
    CATGAGAGGG GGGAGGTTGC CAGGAGGGGC AGTGATGATA GAAAGGATAG GCATGGGCAG
    GAGTGGTCCA AATATAGGGG GGAAGAAAAA CCTGAATCTT CAAAGGAATC GTCATCTTCA
    TCCAGGAGGC ATTCGAAGGA TGAAGATGAA GAGAAGAAGT GGTCAAGTGA TGATGACATG
    AGTACAAGTG GATTTGAGCG AATGGAAGGG GATTTTGATA AACCGTACTC TGATTTTTCT
    TTAAGACCCG AGGATAGATT CGTATACAAA AAACAAGTTC CACAAAGGAC AATAATTATT
    AGAGGACTTG CTCAACACAT AACGGAACAA GATATACAAG ATGATATTAC ACTTTCTCAT
    TTGGTATGCA AAGATATTAG ATTAGTTAGG AGGAAAGATA CAGGAACATC AAGAGGTTTT
    GCTTTTGTTG AATTTAGTAC AGTTGGCGAT GCCATTAAGT GGATAGAATT AAAACAAGGG
    GAGCTCATGC TGAAAGATCA CTTTCGAGCT CTTCTGCAAT ACAGTCTGCC AAAGGATTAT
    TCTTTTGGTA GAGAGAAGTA CATGTCTGAT TGGTATTGTA AATGCCAAGC TCATAATTTT
    CGAAGAAGGA ATACCTGCTT CAAGTGTAAT TTGTCAAGAA GAGAAGTTGA AGTGGAATTT
    GTCGATACAA TAAGTTCATA TCCTACAAAT ACAGTCCTTC TAACAGGTTT AGATGTGTCA
    ACAACAGAAG AGAGTGTGCT CCAATCTATT AAGACACTAT CATCTCTTCC AATTAGAAGT
    GTACGGATTG GAAGAGATAT TGCAACAAAT ACTTCAAGGG GTGTTTGCTA CTTAGAAATG
    AACAGTGTCG TTGATGCCAT GTACCTTCAC AATGCTCTTC AAGCATCAAC ACCTTCAATA
    GATGGAAGAA CTGCACTTGT ATCATATGCA AAACTGGATC CTGTATCTAT GAATTCATCT
    GCTGCTATTA GTGTACAAAT AGCTAATGCA GCTGTAGCTG CAGCTCAGTG GAGTCACCAG
    AAGTCAGATA GTCAACAATA TCAACTTAGT GATGTGCCTA GACTTGCGGA ATACAGTGCT
    GCTCTTTATG CTACAACACC CCAAGAAAAG GCATCATATT TAGCTTACTA TGAAGAATAT
    TATAGGAAAC AAATTACAGA AGGTGAAAAC ATATCACTCC CTGTAAACAG TTCAAGCGGT
    CTTGCCACAG CCCAAGCTGC AGTTGCAGCA CACAAAAAGT CCAAAGATAG TAGTAGTAAG
    CTGTCACCAT TAACAGAAGC ACCAGATGGC TCTGGTGATA AGACTTATCC AGCTCCAGAT
    GTCACATCTT ACCAATATGA CAAATCGTCA GGATATTATT ACGATCCTCA TACCACACTT
    TATTATGATG CAAATTCACA ATACTACTAT AATAATAAAC TTGGTAAATT CCTCTATTGG
    GATGCCTCGA GGTGTACATA CTTGCCTTCA CCTACAGATA AGAGTCAGCC TCAAAACCAG
    TCAAATAATT CACCACAGGT TGATGCTGCA AACAAGGAAG AAGAGAAAAA GAATAAAGAA
    AAGGAGACTG AAAAAGACAA AGTTAAAGTA GCAAAGAGGA TTGCAAAAGA CATGGAAAGA
    TGGGCAAAAA CATTGAACCA AAAGAAAGAG AATGCAAAGC AGAACATTGT TCAAGCTCAG
    GCTGCCATAA CTAGCATGAA AGCAGCAGGT GCTGCAGACA TAGGTTATGC AGTACTTGAG
    AGAAAAGATT TGGCATTGCC CACACAGAAT GGGGCAGACC GTAGTTCCAA AAATGAAAGC
    TTAGTTGCAG CATACGGGCA AGGGAGTGAC AGTGAAGAAG AGGCAGCAGA AGAATCAGCA
    AATGAAGAGA AAATGCATAC AGATTGGATC AAGTTGGCTT GTTTGCTGTG CAAAAGGCAG
    TTTGCCAGCA AAGATGCTCT TGTCAAACAT CAGCAGTTAT CGGACCTACA CAAGCAAAAT
    CTTTCAGCTT GGTACAAGTC GAAGGGGTTG GACCCACATG ATGCCCAGAC AAGAAATACA
    CAATATCGAG ACAGGGCAAG AGAGCGAAGG ATGAAATACG GTGAGCCGGA TACACCACAG
    CCAAGCAAGC TGAAAGAGAC TTACATGAAA TCTAGGGAGG CAACAATCAA CTATGAAGAG
    CCCACAAGAG CGGGCATAGG GGCGGACAAC TTAGGTAATA AACTTTTACA AAAAATGGGG
    TGGCAAGAGG GCATGGGTTT AGGTAAATCA AATCAGGGAA GGACATGTAT TATTCAAGCA
    GAAAGGCGAT CTGCATGCGC TGGCCTTGGA ACCAAAAGTG TCGGGGTTAC TCCGGGTCCT
    GGGGAAACGT ATAAAGATTG TGTCAAAAAA ATGATGCAAA TTAGATATTC GGAAATCGAT
    GACCCATCGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014253951.1
    CDS492..3263
    Translation

    Target ORF information:

    RefSeq Version XM_014398465.1
    Organism Cimex lectularius(bed bug)
    Definition Cimex lectularius RNA-binding protein 5 (LOC106669163), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014398465.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGGACCGAA GGCAATTTGG CGAAAATTAC TATGGGAGGC ATTACCAAGG CAGCCCATTC 
    TTCAATCCTG GTGGCCAGAA ATCTGCTGAA GAAGAGTTGG TAGCCCGGAG CAAAGAATGG
    ATGAACAGAC AAGATAGAGA CAGAGACCAG TGGAGGAGAT CTGTCGATGA TTTTCTAGAT
    GATAAAAGTA GCAGTAGGTA TCATAAGAGT AGGGACAGGT CTCGAGAAAG GTCTAGGTCC
    AGGGAAAGGG GGGAAAGAAA AGAGAGAAAA CGTTCTCGTG AAAGGAGTAG GGAGCGGGAA
    TCTTCGCGGC GATGGTCACC GGAAGATGAT GAAAGAGATA CAACAAATAC AAGAAGACGG
    CATGAGAGGG GGGAGGTTGC CAGGAGGGGC AGTGATGATA GAAAGGATAG GCATGGGCAG
    GAGTGGTCCA AATATAGGGG GGAAGAAAAA CCTGAATCTT CAAAGGAATC GTCATCTTCA
    TCCAGGAGGC ATTCGAAGGA TGAAGATGAA GAGAAGAAGT GGTCAAGTGA TGATGACATG
    AGTACAAGTG GATTTGAGCG AATGGAAGGG GATTTTGATA AACCGTACTC TGATTTTTCT
    TTAAGACCCG AGGATAGATT CGTATACAAA AAACAAGTTC CACAAAGGAC AATAATTATT
    AGAGGACTTG CTCAACACAT AACGGAACAA GATATACAAG ATGATATTAC ACTTTCTCAT
    TTGGTATGCA AAGATATTAG ATTAGTTAGG AGGAAAGATA CAGGAACATC AAGAGGTTTT
    GCTTTTGTTG AATTTAGTAC AGTTGGCGAT GCCATTAAGT GGATAGAATT AAAACAAGGG
    GAGCTCATGC TGAAAGATCA CTTTCGAGCT CTTCTGCAAT ACAGTCTGCC AAAGGATTAT
    TCTTTTGGTA GAGAGAAGTA CATGTCTGAT TGGTATTGTA AATGCCAAGC TCATAATTTT
    CGAAGAAGGA ATACCTGCTT CAAGTGTAAT TTGTCAAGAA GAGAAGTTGA AGTGGAATTT
    GTCGATACAA TAAGTTCATA TCCTACAAAT ACAGTCCTTC TAACAGGTTT AGATGTGTCA
    ACAACAGAAG AGAGTGTGCT CCAATCTATT AAGACACTAT CATCTCTTCC AATTAGAAGT
    GTACGGATTG GAAGAGATAT TGCAACAAAT ACTTCAAGGG GTGTTTGCTA CTTAGAAATG
    AACAGTGTCG TTGATGCCAT GTACCTTCAC AATGCTCTTC AAGCATCAAC ACCTTCAATA
    GATGGAAGAA CTGCACTTGT ATCATATGCA AAACTGGATC CTGTATCTAT GAATTCATCT
    GCTGCTATTA GTGTACAAAT AGCTAATGCA GCTGTAGCTG CAGCTCAGTG GAGTCACCAG
    AAGTCAGATA GTCAACAATA TCAACTTAGT GATGTGCCTA GACTTGCGGA ATACAGTGCT
    GCTCTTTATG CTACAACACC CCAAGAAAAG GCATCATATT TAGCTTACTA TGAAGAATAT
    TATAGGAAAC AAATTACAGA AGGTGAAAAC ATATCACTCC CTGTAAACAG TTCAAGCGGT
    CTTGCCACAG CCCAAGCTGC AGTTGCAGCA CACAAAAAGT CCAAAGATAG TAGTAGTAAG
    CTGTCACCAT TAACAGAAGC ACCAGATGGC TCTGGTGATA AGACTTATCC AGCTCCAGAT
    GTCACATCTT ACCAATATGA CAAATCGTCA GGATATTATT ACGATCCTCA TACCACACTT
    TATTATGATG CAAATTCACA ATACTACTAT AATAATAAAC TTGGTAAATT CCTCTATTGG
    GATGCCTCGA GGTGTACATA CTTGCCTTCA CCTACAGATA AGAGTCAGCC TCAAAACCAG
    TCAAATAATT CACCACAGGT TGATGCTGCA AACAAGGAAG AAGAGAAAAA GAATAAAGAA
    AAGGAGACTG AAAAAGACAA AGTTAAAGTA GCAAAGAGGA TTGCAAAAGA CATGGAAAGA
    TGGGCAAAAA CATTGAACCA AAAGAAAGAG AATGCAAAGC AGAACATTGT TCAAGCTCAG
    GCTGCCATAA CTAGCATGAA AGCAGCAGGT GCTGCAGACA TAGGTTATGC AGTACTTGAG
    AGAAAAGATT TGGCATTGCC CACACAGAAT GGGGCAGACC GTAGTTCCAA AAATGAAAGC
    TTAGTTGCAG CATACGGGCA AGGGAGTGAC AGTGAAGAAG AGGCAGCAGA AGAATCAGCA
    AATGAAGAGA AAATGCATAC AGATTGGATC AAGTTGGCTT GTTTGCTGTG CAAAAGGCAG
    TTTGCCAGCA AAGATGCTCT TGTCAAACAT CAGCAGTTAT CGGACCTACA CAAGCAAAAT
    CTTTCAGCTT GGTACAAGTC GAAGGGGTTG GACCCACATG ATGCCCAGAC AAGAAATACA
    CAATATCGAG ACAGGGCAAG AGAGCGAAGG ATGAAATACG GTGAGCCGGA TACACCACAG
    CCAAGCAAGC TGAAAGAGAC TTACATGAAA TCTAGGGAGG CAACAATCAA CTATGAAGAG
    CCCACAAGAG CGGGCATAGG GGCGGACAAC TTAGGTAATA AACTTTTACA AAAAATGGGG
    TGGCAAGAGG GCATGGGTTT AGGTAAATCA AATCAGGGAA GGACATGTAT TATTCAAGCA
    GAAAGGCGAT CTGCATGCGC TGGCCTTGGA ACCAAAAGTG TCGGGGTTAC TCCGGGTCCT
    GGGGAAACGT ATAAAGATTG TGTCAAAAAA ATGATGCAAA TTAGATATTC GGAAATCGAT
    GACCCATCGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OCi33322
    Clone ID Related Accession (Same CDS sequence) XM_014398465.1 , XM_014398465.2
    Accession Version XM_014398465.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2772bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-02-27
    Organism Cimex lectularius(bed bug)
    Product RNA-binding protein 5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_019392841.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On Feb 28, 2018 this sequence version replaced XM_014398465.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Cimex lectularius Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGGACCGAA GGCAATTTGG CGAAAATTAC TATGGGAGGC ATTACCAAGG CAGCCCATTC 
    TTCAATCCTG GTGGCCAGAA ATCTGCTGAA GAAGAGTTGG TAGCCCGGAG CAAAGAATGG
    ATGAACAGAC AAGATAGAGA CAGAGACCAG TGGAGGAGAT CTGTCGATGA TTTTCTAGAT
    GATAAAAGTA GCAGTAGGTA TCATAAGAGT AGGGACAGGT CTCGAGAAAG GTCTAGGTCC
    AGGGAAAGGG GGGAAAGAAA AGAGAGAAAA CGTTCTCGTG AAAGGAGTAG GGAGCGGGAA
    TCTTCGCGGC GATGGTCACC GGAAGATGAT GAAAGAGATA CAACAAATAC AAGAAGACGG
    CATGAGAGGG GGGAGGTTGC CAGGAGGGGC AGTGATGATA GAAAGGATAG GCATGGGCAG
    GAGTGGTCCA AATATAGGGG GGAAGAAAAA CCTGAATCTT CAAAGGAATC GTCATCTTCA
    TCCAGGAGGC ATTCGAAGGA TGAAGATGAA GAGAAGAAGT GGTCAAGTGA TGATGACATG
    AGTACAAGTG GATTTGAGCG AATGGAAGGG GATTTTGATA AACCGTACTC TGATTTTTCT
    TTAAGACCCG AGGATAGATT CGTATACAAA AAACAAGTTC CACAAAGGAC AATAATTATT
    AGAGGACTTG CTCAACACAT AACGGAACAA GATATACAAG ATGATATTAC ACTTTCTCAT
    TTGGTATGCA AAGATATTAG ATTAGTTAGG AGGAAAGATA CAGGAACATC AAGAGGTTTT
    GCTTTTGTTG AATTTAGTAC AGTTGGCGAT GCCATTAAGT GGATAGAATT AAAACAAGGG
    GAGCTCATGC TGAAAGATCA CTTTCGAGCT CTTCTGCAAT ACAGTCTGCC AAAGGATTAT
    TCTTTTGGTA GAGAGAAGTA CATGTCTGAT TGGTATTGTA AATGCCAAGC TCATAATTTT
    CGAAGAAGGA ATACCTGCTT CAAGTGTAAT TTGTCAAGAA GAGAAGTTGA AGTGGAATTT
    GTCGATACAA TAAGTTCATA TCCTACAAAT ACAGTCCTTC TAACAGGTTT AGATGTGTCA
    ACAACAGAAG AGAGTGTGCT CCAATCTATT AAGACACTAT CATCTCTTCC AATTAGAAGT
    GTACGGATTG GAAGAGATAT TGCAACAAAT ACTTCAAGGG GTGTTTGCTA CTTAGAAATG
    AACAGTGTCG TTGATGCCAT GTACCTTCAC AATGCTCTTC AAGCATCAAC ACCTTCAATA
    GATGGAAGAA CTGCACTTGT ATCATATGCA AAACTGGATC CTGTATCTAT GAATTCATCT
    GCTGCTATTA GTGTACAAAT AGCTAATGCA GCTGTAGCTG CAGCTCAGTG GAGTCACCAG
    AAGTCAGATA GTCAACAATA TCAACTTAGT GATGTGCCTA GACTTGCGGA ATACAGTGCT
    GCTCTTTATG CTACAACACC CCAAGAAAAG GCATCATATT TAGCTTACTA TGAAGAATAT
    TATAGGAAAC AAATTACAGA AGGTGAAAAC ATATCACTCC CTGTAAACAG TTCAAGCGGT
    CTTGCCACAG CCCAAGCTGC AGTTGCAGCA CACAAAAAGT CCAAAGATAG TAGTAGTAAG
    CTGTCACCAT TAACAGAAGC ACCAGATGGC TCTGGTGATA AGACTTATCC AGCTCCAGAT
    GTCACATCTT ACCAATATGA CAAATCGTCA GGATATTATT ACGATCCTCA TACCACACTT
    TATTATGATG CAAATTCACA ATACTACTAT AATAATAAAC TTGGTAAATT CCTCTATTGG
    GATGCCTCGA GGTGTACATA CTTGCCTTCA CCTACAGATA AGAGTCAGCC TCAAAACCAG
    TCAAATAATT CACCACAGGT TGATGCTGCA AACAAGGAAG AAGAGAAAAA GAATAAAGAA
    AAGGAGACTG AAAAAGACAA AGTTAAAGTA GCAAAGAGGA TTGCAAAAGA CATGGAAAGA
    TGGGCAAAAA CATTGAACCA AAAGAAAGAG AATGCAAAGC AGAACATTGT TCAAGCTCAG
    GCTGCCATAA CTAGCATGAA AGCAGCAGGT GCTGCAGACA TAGGTTATGC AGTACTTGAG
    AGAAAAGATT TGGCATTGCC CACACAGAAT GGGGCAGACC GTAGTTCCAA AAATGAAAGC
    TTAGTTGCAG CATACGGGCA AGGGAGTGAC AGTGAAGAAG AGGCAGCAGA AGAATCAGCA
    AATGAAGAGA AAATGCATAC AGATTGGATC AAGTTGGCTT GTTTGCTGTG CAAAAGGCAG
    TTTGCCAGCA AAGATGCTCT TGTCAAACAT CAGCAGTTAT CGGACCTACA CAAGCAAAAT
    CTTTCAGCTT GGTACAAGTC GAAGGGGTTG GACCCACATG ATGCCCAGAC AAGAAATACA
    CAATATCGAG ACAGGGCAAG AGAGCGAAGG ATGAAATACG GTGAGCCGGA TACACCACAG
    CCAAGCAAGC TGAAAGAGAC TTACATGAAA TCTAGGGAGG CAACAATCAA CTATGAAGAG
    CCCACAAGAG CGGGCATAGG GGCGGACAAC TTAGGTAATA AACTTTTACA AAAAATGGGG
    TGGCAAGAGG GCATGGGTTT AGGTAAATCA AATCAGGGAA GGACATGTAT TATTCAAGCA
    GAAAGGCGAT CTGCATGCGC TGGCCTTGGA ACCAAAAGTG TCGGGGTTAC TCCGGGTCCT
    GGGGAAACGT ATAAAGATTG TGTCAAAAAA ATGATGCAAA TTAGATATTC GGAAATCGAT
    GACCCATCGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014253951.1
    CDS371..3142
    Translation

    Target ORF information:

    RefSeq Version XM_014398465.2
    Organism Cimex lectularius(bed bug)
    Definition Cimex lectularius RNA-binding protein 5 (LOC106669163), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014398465.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    ATGGACCGAA GGCAATTTGG CGAAAATTAC TATGGGAGGC ATTACCAAGG CAGCCCATTC 
    TTCAATCCTG GTGGCCAGAA ATCTGCTGAA GAAGAGTTGG TAGCCCGGAG CAAAGAATGG
    ATGAACAGAC AAGATAGAGA CAGAGACCAG TGGAGGAGAT CTGTCGATGA TTTTCTAGAT
    GATAAAAGTA GCAGTAGGTA TCATAAGAGT AGGGACAGGT CTCGAGAAAG GTCTAGGTCC
    AGGGAAAGGG GGGAAAGAAA AGAGAGAAAA CGTTCTCGTG AAAGGAGTAG GGAGCGGGAA
    TCTTCGCGGC GATGGTCACC GGAAGATGAT GAAAGAGATA CAACAAATAC AAGAAGACGG
    CATGAGAGGG GGGAGGTTGC CAGGAGGGGC AGTGATGATA GAAAGGATAG GCATGGGCAG
    GAGTGGTCCA AATATAGGGG GGAAGAAAAA CCTGAATCTT CAAAGGAATC GTCATCTTCA
    TCCAGGAGGC ATTCGAAGGA TGAAGATGAA GAGAAGAAGT GGTCAAGTGA TGATGACATG
    AGTACAAGTG GATTTGAGCG AATGGAAGGG GATTTTGATA AACCGTACTC TGATTTTTCT
    TTAAGACCCG AGGATAGATT CGTATACAAA AAACAAGTTC CACAAAGGAC AATAATTATT
    AGAGGACTTG CTCAACACAT AACGGAACAA GATATACAAG ATGATATTAC ACTTTCTCAT
    TTGGTATGCA AAGATATTAG ATTAGTTAGG AGGAAAGATA CAGGAACATC AAGAGGTTTT
    GCTTTTGTTG AATTTAGTAC AGTTGGCGAT GCCATTAAGT GGATAGAATT AAAACAAGGG
    GAGCTCATGC TGAAAGATCA CTTTCGAGCT CTTCTGCAAT ACAGTCTGCC AAAGGATTAT
    TCTTTTGGTA GAGAGAAGTA CATGTCTGAT TGGTATTGTA AATGCCAAGC TCATAATTTT
    CGAAGAAGGA ATACCTGCTT CAAGTGTAAT TTGTCAAGAA GAGAAGTTGA AGTGGAATTT
    GTCGATACAA TAAGTTCATA TCCTACAAAT ACAGTCCTTC TAACAGGTTT AGATGTGTCA
    ACAACAGAAG AGAGTGTGCT CCAATCTATT AAGACACTAT CATCTCTTCC AATTAGAAGT
    GTACGGATTG GAAGAGATAT TGCAACAAAT ACTTCAAGGG GTGTTTGCTA CTTAGAAATG
    AACAGTGTCG TTGATGCCAT GTACCTTCAC AATGCTCTTC AAGCATCAAC ACCTTCAATA
    GATGGAAGAA CTGCACTTGT ATCATATGCA AAACTGGATC CTGTATCTAT GAATTCATCT
    GCTGCTATTA GTGTACAAAT AGCTAATGCA GCTGTAGCTG CAGCTCAGTG GAGTCACCAG
    AAGTCAGATA GTCAACAATA TCAACTTAGT GATGTGCCTA GACTTGCGGA ATACAGTGCT
    GCTCTTTATG CTACAACACC CCAAGAAAAG GCATCATATT TAGCTTACTA TGAAGAATAT
    TATAGGAAAC AAATTACAGA AGGTGAAAAC ATATCACTCC CTGTAAACAG TTCAAGCGGT
    CTTGCCACAG CCCAAGCTGC AGTTGCAGCA CACAAAAAGT CCAAAGATAG TAGTAGTAAG
    CTGTCACCAT TAACAGAAGC ACCAGATGGC TCTGGTGATA AGACTTATCC AGCTCCAGAT
    GTCACATCTT ACCAATATGA CAAATCGTCA GGATATTATT ACGATCCTCA TACCACACTT
    TATTATGATG CAAATTCACA ATACTACTAT AATAATAAAC TTGGTAAATT CCTCTATTGG
    GATGCCTCGA GGTGTACATA CTTGCCTTCA CCTACAGATA AGAGTCAGCC TCAAAACCAG
    TCAAATAATT CACCACAGGT TGATGCTGCA AACAAGGAAG AAGAGAAAAA GAATAAAGAA
    AAGGAGACTG AAAAAGACAA AGTTAAAGTA GCAAAGAGGA TTGCAAAAGA CATGGAAAGA
    TGGGCAAAAA CATTGAACCA AAAGAAAGAG AATGCAAAGC AGAACATTGT TCAAGCTCAG
    GCTGCCATAA CTAGCATGAA AGCAGCAGGT GCTGCAGACA TAGGTTATGC AGTACTTGAG
    AGAAAAGATT TGGCATTGCC CACACAGAAT GGGGCAGACC GTAGTTCCAA AAATGAAAGC
    TTAGTTGCAG CATACGGGCA AGGGAGTGAC AGTGAAGAAG AGGCAGCAGA AGAATCAGCA
    AATGAAGAGA AAATGCATAC AGATTGGATC AAGTTGGCTT GTTTGCTGTG CAAAAGGCAG
    TTTGCCAGCA AAGATGCTCT TGTCAAACAT CAGCAGTTAT CGGACCTACA CAAGCAAAAT
    CTTTCAGCTT GGTACAAGTC GAAGGGGTTG GACCCACATG ATGCCCAGAC AAGAAATACA
    CAATATCGAG ACAGGGCAAG AGAGCGAAGG ATGAAATACG GTGAGCCGGA TACACCACAG
    CCAAGCAAGC TGAAAGAGAC TTACATGAAA TCTAGGGAGG CAACAATCAA CTATGAAGAG
    CCCACAAGAG CGGGCATAGG GGCGGACAAC TTAGGTAATA AACTTTTACA AAAAATGGGG
    TGGCAAGAGG GCATGGGTTT AGGTAAATCA AATCAGGGAA GGACATGTAT TATTCAAGCA
    GAAAGGCGAT CTGCATGCGC TGGCCTTGGA ACCAAAAGTG TCGGGGTTAC TCCGGGTCCT
    GGGGAAACGT ATAAAGATTG TGTCAAAAAA ATGATGCAAA TTAGATATTC GGAAATCGAT
    GACCCATCGT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.