NLRX1 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

The following NLRX1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the NLRX1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs24223 XM_014259868.1
Latest version!
Pseudopodoces humilis NLR family member X1 (NLRX1), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs24223
    Clone ID Related Accession (Same CDS sequence) XM_014259868.1
    Accession Version XM_014259868.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2976bp)
    Protein sequence
    SNP
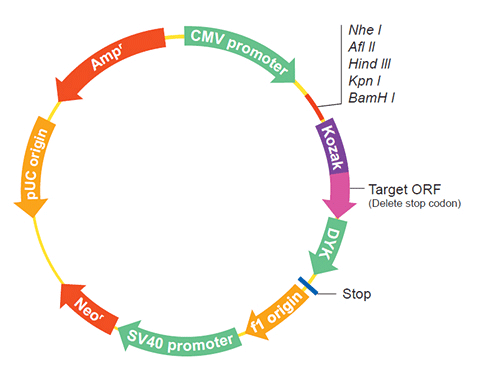
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product LOW QUALITY PROTEIN: NLR family member X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087643.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## frameshifts :: corrected 1 indel ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGTACAGCC CATGGCTTCC TGACCTGCCT TCACCTCCCA GCCGTGCCCC TACCCTAGCC 
    CGTGCTGTGG GGGAAGGAAG GGGTGAGCTG GCTCCTCTCA GCACTTCCCA CAGCCTCGCT
    TGTGATCTGC CCACGCTGCC CCAGGACGGG TTTGGAGCTG CTCCCCGTGA TTCTCCCTCC
    TCCTGCAGGG GCTGCGTTCG CTACCAGGGA GACTCCCGTG AGATCTCTGC TCAGCCCGGC
    TCCTCTTGCC ATGGTCAGTC CCAGCTGAGG AACGTGGCCT CTTCTGGTGC CATTAGGAAG
    CACCAGAAGA GCCTGTCTGC ATGGTTCAGC CACCAGCCCA ATGAAGAGAG GCAGTTTGGC
    CCTTCCTTCT CACTGGATGC CGTCCACGTG GACCCAGTGA TCCGGGAGAG CTCCCTGGAG
    GAGATTCTGA AGCCCTCCCC TGATTTAACC ATCCAGAACC AGCTCCAGCA GCCCTGTAGA
    AAGGTTATCA GCCTCCACAA CCTCTTTGAC GTGGACGCCT GTGGGCGGCA GGTGAAGAAC
    GTGGTGCTCT ATGGCACGGT GGGCACGGGC AAGAGCACCC TCATCAAGAA GATGGTGGTG
    GACTGGTGCC ACGGCCGCCT GCCCCACTTT GAGCTGGTCA TCCCCTTCTC CTGCGAGGAC
    CTGTCCCACA GCCACGCCCA CGTGTCCCTG CGGCGCCTCA TCACCAAGAA GTACCAGCAC
    CTCCGGGACG TGGTGCCGGT GCTGGAAGCT TCCAACCTCA GGGTGCTCTT CATCCTCAAC
    GGCCTGGAGC GCCTCAACCT GGACTTCCGC CTGGCTGGCA CGGAGCTGTG CTGTGACCCC
    AACGAGCCCG TGCCACCCTC TGCCATTGTG GTCAACCTGC TGCGGAAATA CCTCCTGCCC
    GAGGCCAGCA TCATCGTCAC CACGCGCCCT TCGGCCGTGC GCCGCATCCC CGGCAAGTAC
    GTGGGCCGCT ACGCCGAGAT CTGCGGCTTC TCCGACACCA ACCTGCAGAA GCTCTACTTC
    CAGATGCGCC TCAGCCAGCC GGGCTGCTCC GGAGAGGAGA GCCAGCACCG CAGCTCGGCG
    GAGCAGGAGA ACCTGGTGGA GATGTTGTCG AGGAACTTGG AGCGCCACAA CCAAATAACA
    GCTGCCTGCT TCTTGCCCTC CTACTGCTGG CTGGTGTGCA CCACCCTGCA CTTCCTCTAC
    TTCACCAGGA CGGTTCCTCC CAGCCAGACC CTGACTGGCA TCTACACCAG CTTCCTGCGG
    CTCAACTTCA GCGGGGAGGT GCTGGACAGC ACCGACCCCA CCCACATCTC CATGATGAAG
    TACGCGGCCA AGACAGTGGG CAAGCTGGCC TACGAGGGGG TGATGTCCCG CAAGACCTGC
    TTCTCAGAGG AGGACCTGCG GCAGTGCTTC GAGGTGGAGA TGAAGACCGA GAGCGAGCTC
    AACCTCCTGG AGGTTTTCCG CAGCGACGTC TTCCGCTTCT TCCTCAGCCC GTGCGTGCAG
    CCGGGCAAGG AGCACACCTT TGTCTTCACC ATCCCCGCCA TGCAGGAGTA CCTGGCAGCC
    CTGTACGTGG TGCTGGGCGA GAAGAAGACC CTGGCCCAGA GAGTGGGGAA GGAGCTGTCA
    GAGGTCATTG GGAAGGTGAG CGAAGATGTG GCTGTGGTTG TGAACATCAT TTCCAAAGTG
    CTGCCCCTGC GTTTCCTCCC CGTGCTCTTC AACCTGCTCA AGATCTTCCC TCGCTACTTC
    TCCCGGGTGA GCGGCAAGGA CAAGGATGCC ATTGCCCACA CCATGGCAGA GGAGCTGTTC
    AAAGAGGAGG ACTACTACAA CGACGATGTC TTGGACCAGA TCAACTCCAG CATCCTGGGC
    GTGGAAGGCC CCATGCGCCA CCCCGACGAG GCCCCGGATG ATGAGGTCTT TGAGCTCTTC
    CCTATTTTCA TGGGCGGAAT CCTGTCCCGC CGCAACCGCG CCATCCTGGA GCAGCTGGGC
    TGCTCCATCA AGAATCTGGC AGCCTTTGAG ATCGCCAAGG CCATGAAGAA GACGGTGATC
    AGGAAGGGCC GCAAGGGCCT GCCCCCCTCC GAGCTCATGG ACTACCTGTT CTTCCTGCAC
    GAGTTCCAGA ACGAGCGCTT TGCAGCCGAG GCCGTCCGCT CCCTCCGTGC TGTCAACCTC
    TCCTCTGTCA AGATGACCCC TCTCAAGTGC TCCGTGCTGG CATCTGTCAT GAGCACCACG
    TGTCACGAGG TGGAGGAGCT GAACCTGACC TCCTGCAACC TGGACAGCGG CAGCTTGAGG
    ACCCTCTTCC CTGTCCTGCT GCGATGCAAA GCTCTCCATT TGCAGCTCAA CAGCCTGGGC
    TCCAAAGCCT GCAAGGAAAT CCGTGACCTG CTCCTGCATG ACAAGTGTGT GGTGAGCAGC
    CTGCGGCTGG CCAATAACCC CGTGGGCGAG CAGGGCGCTC GCTACCTGGC CGAGGCGCTG
    GCCGGCAACC GCTCGCTGAC CCAGCTGTCC CTGCTGCACA CCTCACTGGG GGACCCCGGC
    GCCGAGGCCA TCGCCCAGCA CCTGGCCCAG AACCAGCATC TGCAGGAGCT CAACCTGGGC
    TACAACTCCC TGACGGACAC GGCGGCCCTG CGCGTGGTGG AGGTGGCCAA AAGGCACGAG
    ACGCTGGACA AAGTGCATCT CTACTTCAAC GACATCAGTG AGGATGGCAA GAGGGCACTC
    GACAGCCTGC GCATGGACCG GGACGGCGTC AGGGCTCTGG TTTTCCTCAC GGCGGGCACC
    GACGTTTCCG ATTACTGGTC CCACATCCTG AACGTGGTGC AGAGGAACCT GCCCTTCTGG
    GACCGAGAGC GGGTCCGGCA GCACCTCGCC CTCCTCCTGC AGGACCTGGA GAGCAGCCGC
    AGCCAGACTG CCAACCCCTG GAGGAAAGCC AAATTCCTGC GAGTCGAGAG CGAGGTCAAG
    AAAATGCTGG GGAAACTGCA GGATGGGAGC CTCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014115343.1
    CDS1..2976
    Translation

    Target ORF information:

    RefSeq Version XM_014259868.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis NLR family member X1 (NLRX1), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014259868.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGTACAGCC CATGGCTTCC TGACCTGCCT TCACCTCCCA GCCGTGCCCC TACCCTAGCC 
    CGTGCTGTGG GGGAAGGAAG GGGTGAGCTG GCTCCTCTCA GCACTTCCCA CAGCCTCGCT
    TGTGATCTGC CCACGCTGCC CCAGGACGGG TTTGGAGCTG CTCCCCGTGA TTCTCCCTCC
    TCCTGCAGGG GCTGCGTTCG CTACCAGGGA GACTCCCGTG AGATCTCTGC TCAGCCCGGC
    TCCTCTTGCC ATGGTCAGTC CCAGCTGAGG AACGTGGCCT CTTCTGGTGC CATTAGGAAG
    CACCAGAAGA GCCTGTCTGC ATGGTTCAGC CACCAGCCCA ATGAAGAGAG GCAGTTTGGC
    CCTTCCTTCT CACTGGATGC CGTCCACGTG GACCCAGTGA TCCGGGAGAG CTCCCTGGAG
    GAGATTCTGA AGCCCTCCCC TGATTTAACC ATCCAGAACC AGCTCCAGCA GCCCTGTAGA
    AAGGTTATCA GCCTCCACAA CCTCTTTGAC GTGGACGCCT GTGGGCGGCA GGTGAAGAAC
    GTGGTGCTCT ATGGCACGGT GGGCACGGGC AAGAGCACCC TCATCAAGAA GATGGTGGTG
    GACTGGTGCC ACGGCCGCCT GCCCCACTTT GAGCTGGTCA TCCCCTTCTC CTGCGAGGAC
    CTGTCCCACA GCCACGCCCA CGTGTCCCTG CGGCGCCTCA TCACCAAGAA GTACCAGCAC
    CTCCGGGACG TGGTGCCGGT GCTGGAAGCT TCCAACCTCA GGGTGCTCTT CATCCTCAAC
    GGCCTGGAGC GCCTCAACCT GGACTTCCGC CTGGCTGGCA CGGAGCTGTG CTGTGACCCC
    AACGAGCCCG TGCCACCCTC TGCCATTGTG GTCAACCTGC TGCGGAAATA CCTCCTGCCC
    GAGGCCAGCA TCATCGTCAC CACGCGCCCT TCGGCCGTGC GCCGCATCCC CGGCAAGTAC
    GTGGGCCGCT ACGCCGAGAT CTGCGGCTTC TCCGACACCA ACCTGCAGAA GCTCTACTTC
    CAGATGCGCC TCAGCCAGCC GGGCTGCTCC GGAGAGGAGA GCCAGCACCG CAGCTCGGCG
    GAGCAGGAGA ACCTGGTGGA GATGTTGTCG AGGAACTTGG AGCGCCACAA CCAAATAACA
    GCTGCCTGCT TCTTGCCCTC CTACTGCTGG CTGGTGTGCA CCACCCTGCA CTTCCTCTAC
    TTCACCAGGA CGGTTCCTCC CAGCCAGACC CTGACTGGCA TCTACACCAG CTTCCTGCGG
    CTCAACTTCA GCGGGGAGGT GCTGGACAGC ACCGACCCCA CCCACATCTC CATGATGAAG
    TACGCGGCCA AGACAGTGGG CAAGCTGGCC TACGAGGGGG TGATGTCCCG CAAGACCTGC
    TTCTCAGAGG AGGACCTGCG GCAGTGCTTC GAGGTGGAGA TGAAGACCGA GAGCGAGCTC
    AACCTCCTGG AGGTTTTCCG CAGCGACGTC TTCCGCTTCT TCCTCAGCCC GTGCGTGCAG
    CCGGGCAAGG AGCACACCTT TGTCTTCACC ATCCCCGCCA TGCAGGAGTA CCTGGCAGCC
    CTGTACGTGG TGCTGGGCGA GAAGAAGACC CTGGCCCAGA GAGTGGGGAA GGAGCTGTCA
    GAGGTCATTG GGAAGGTGAG CGAAGATGTG GCTGTGGTTG TGAACATCAT TTCCAAAGTG
    CTGCCCCTGC GTTTCCTCCC CGTGCTCTTC AACCTGCTCA AGATCTTCCC TCGCTACTTC
    TCCCGGGTGA GCGGCAAGGA CAAGGATGCC ATTGCCCACA CCATGGCAGA GGAGCTGTTC
    AAAGAGGAGG ACTACTACAA CGACGATGTC TTGGACCAGA TCAACTCCAG CATCCTGGGC
    GTGGAAGGCC CCATGCGCCA CCCCGACGAG GCCCCGGATG ATGAGGTCTT TGAGCTCTTC
    CCTATTTTCA TGGGCGGAAT CCTGTCCCGC CGCAACCGCG CCATCCTGGA GCAGCTGGGC
    TGCTCCATCA AGAATCTGGC AGCCTTTGAG ATCGCCAAGG CCATGAAGAA GACGGTGATC
    AGGAAGGGCC GCAAGGGCCT GCCCCCCTCC GAGCTCATGG ACTACCTGTT CTTCCTGCAC
    GAGTTCCAGA ACGAGCGCTT TGCAGCCGAG GCCGTCCGCT CCCTCCGTGC TGTCAACCTC
    TCCTCTGTCA AGATGACCCC TCTCAAGTGC TCCGTGCTGG CATCTGTCAT GAGCACCACG
    TGTCACGAGG TGGAGGAGCT GAACCTGACC TCCTGCAACC TGGACAGCGG CAGCTTGAGG
    ACCCTCTTCC CTGTCCTGCT GCGATGCAAA GCTCTCCATT TGCAGCTCAA CAGCCTGGGC
    TCCAAAGCCT GCAAGGAAAT CCGTGACCTG CTCCTGCATG ACAAGTGTGT GGTGAGCAGC
    CTGCGGCTGG CCAATAACCC CGTGGGCGAG CAGGGCGCTC GCTACCTGGC CGAGGCGCTG
    GCCGGCAACC GCTCGCTGAC CCAGCTGTCC CTGCTGCACA CCTCACTGGG GGACCCCGGC
    GCCGAGGCCA TCGCCCAGCA CCTGGCCCAG AACCAGCATC TGCAGGAGCT CAACCTGGGC
    TACAACTCCC TGACGGACAC GGCGGCCCTG CGCGTGGTGG AGGTGGCCAA AAGGCACGAG
    ACGCTGGACA AAGTGCATCT CTACTTCAAC GACATCAGTG AGGATGGCAA GAGGGCACTC
    GACAGCCTGC GCATGGACCG GGACGGCGTC AGGGCTCTGG TTTTCCTCAC GGCGGGCACC
    GACGTTTCCG ATTACTGGTC CCACATCCTG AACGTGGTGC AGAGGAACCT GCCCTTCTGG
    GACCGAGAGC GGGTCCGGCA GCACCTCGCC CTCCTCCTGC AGGACCTGGA GAGCAGCCGC
    AGCCAGACTG CCAACCCCTG GAGGAAAGCC AAATTCCTGC GAGTCGAGAG CGAGGTCAAG
    AAAATGCTGG GGAAACTGCA GGATGGGAGC CTCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.