LOC102100563 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

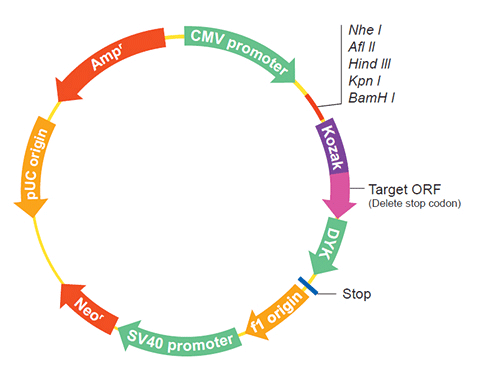
The following LOC102100563 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC102100563 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs23773 XM_014259533.1
Latest version!
Pseudopodoces humilis chromosome unknown open reading frame, human C8orf58 (LOC102100563), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $258.30
$369.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs23773
    Clone ID Related Accession (Same CDS sequence) XM_014259533.1
    Accession Version XM_014259533.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1215bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product uncharacterized protein C8orf58 homolog
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087636.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 35% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    ATGTGGGGTG GCTCCCGCGC CGTCTGGAAG AGGAGGTTCA GCTGCTATGG TCCCTGGGAG 
    TCGGCCGAGA GCTGCATCGT GCGCACCTCC GCCAGCGTCT ACCGCCGGCT GCAGGAGAGC
    CCGCGGCAGC CCCCGCGGGG CATGAGCACC CGGGGACCCC CCCCGCCGCC ACCGCAGCCC
    CCCAGCAGCC CCTCGGCCGG CAGGAGGTTC CTCAAGTTTG AGTCCGAGGA TTCCGGGGTG
    GAGATGGCCA GCAACGAGCA CTCGCCCTCC ACCCCGCTGG GCTCTGAGAG CAGCTTCTCC
    CTGGACGGTT TTCCGGCGGA GAAGCCCCCC GGAGAAGAGC CCCCCCGGAG CCGCTCGGCC
    AGCAGGAGGC TGCTGCAGGC AGCGCAGAGG AGCAGGAGGC AGCGCTGCCC TCGACAGCTC
    AGCAGGCGCA GCGCCAGCAT TGCCGACCTG GCAGAGCCAC CGCGGGACCC CGGGGAGCCC
    CAAGGGGCGG CAGGGGGGGC TCGGCAGTCC GGCAGCCCTC GGGACCCCCG GGCCCAGCCC
    GGGGCCGCGG TGTCGGGGCA GGGGCTGCGC TACCTGGAGC ACGTGTGCCA GATGCTGGAG
    CGCCTGGCGA GGCTGCAGCA GGACAACCAC GCCCTCCGGC AGCAGGCGGC CGGAGCCCGG
    AGTGCCCGCC CGGCCACCCT GCCCACCCGG CAGTCTCCGA GGCAGGATTT GGGCACGTGG
    AGGGGTGAGG AGTTCCGGCC GCGCTCCTGC TCGGACAGCC AGGCACCAGC CGAGCCCGGG
    CCGTGCCGGA GGATGTGGGG ACACTCGCTC AGCTCCCCCA GCCTGCTGGA CCCCTCCGAG
    GGCGGGGCGC GAGTCCCGGC ACCGGACAAG GACGGGCGCT CGCACTGGGG CCGGGTGAAG
    GTGCTGCTCA CCCGCCTGAC CCGCCGCTCC CTGCGGGGCG GCCGCTGCAG TTTGGGGGAT
    AGAGGAGGGG TGGATGCCAT TTTGGTGCTG CTGGAGCTCT GCGCGGGACG GGCCGGTGCC
    GCAGCGGTGA ATCCCGCAGC GCCTCCCGAG CCCTCCCGGC ACCGCTCCCA GCCCGACGCC
    CCGGAGGCAT CCTCGGAGCT GCAGCATCCT GCATCCCACC GCTCCTTCCC GGGAAACGTG
    ACACCCAAGA CCCTCCGCGT CGCCCCTGCA GTGGCGGCCG GGCGGCGGCA GAGGGCGACA
    GCGGCCCGGC GGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014115008.1
    CDS137..1351
    Translation

    Target ORF information:

    RefSeq Version XM_014259533.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis chromosome unknown open reading frame, human C8orf58 (LOC102100563), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014259533.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    ATGTGGGGTG GCTCCCGCGC CGTCTGGAAG AGGAGGTTCA GCTGCTATGG TCCCTGGGAG 
    TCGGCCGAGA GCTGCATCGT GCGCACCTCC GCCAGCGTCT ACCGCCGGCT GCAGGAGAGC
    CCGCGGCAGC CCCCGCGGGG CATGAGCACC CGGGGACCCC CCCCGCCGCC ACCGCAGCCC
    CCCAGCAGCC CCTCGGCCGG CAGGAGGTTC CTCAAGTTTG AGTCCGAGGA TTCCGGGGTG
    GAGATGGCCA GCAACGAGCA CTCGCCCTCC ACCCCGCTGG GCTCTGAGAG CAGCTTCTCC
    CTGGACGGTT TTCCGGCGGA GAAGCCCCCC GGAGAAGAGC CCCCCCGGAG CCGCTCGGCC
    AGCAGGAGGC TGCTGCAGGC AGCGCAGAGG AGCAGGAGGC AGCGCTGCCC TCGACAGCTC
    AGCAGGCGCA GCGCCAGCAT TGCCGACCTG GCAGAGCCAC CGCGGGACCC CGGGGAGCCC
    CAAGGGGCGG CAGGGGGGGC TCGGCAGTCC GGCAGCCCTC GGGACCCCCG GGCCCAGCCC
    GGGGCCGCGG TGTCGGGGCA GGGGCTGCGC TACCTGGAGC ACGTGTGCCA GATGCTGGAG
    CGCCTGGCGA GGCTGCAGCA GGACAACCAC GCCCTCCGGC AGCAGGCGGC CGGAGCCCGG
    AGTGCCCGCC CGGCCACCCT GCCCACCCGG CAGTCTCCGA GGCAGGATTT GGGCACGTGG
    AGGGGTGAGG AGTTCCGGCC GCGCTCCTGC TCGGACAGCC AGGCACCAGC CGAGCCCGGG
    CCGTGCCGGA GGATGTGGGG ACACTCGCTC AGCTCCCCCA GCCTGCTGGA CCCCTCCGAG
    GGCGGGGCGC GAGTCCCGGC ACCGGACAAG GACGGGCGCT CGCACTGGGG CCGGGTGAAG
    GTGCTGCTCA CCCGCCTGAC CCGCCGCTCC CTGCGGGGCG GCCGCTGCAG TTTGGGGGAT
    AGAGGAGGGG TGGATGCCAT TTTGGTGCTG CTGGAGCTCT GCGCGGGACG GGCCGGTGCC
    GCAGCGGTGA ATCCCGCAGC GCCTCCCGAG CCCTCCCGGC ACCGCTCCCA GCCCGACGCC
    CCGGAGGCAT CCTCGGAGCT GCAGCATCCT GCATCCCACC GCTCCTTCCC GGGAAACGTG
    ACACCCAAGA CCCTCCGCGT CGCCCCTGCA GTGGCGGCCG GGCGGCGGCA GAGGGCGACA
    GCGGCCCGGC GGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.