LOC108656733 cDNA ORF clone, Drosophila navojoa

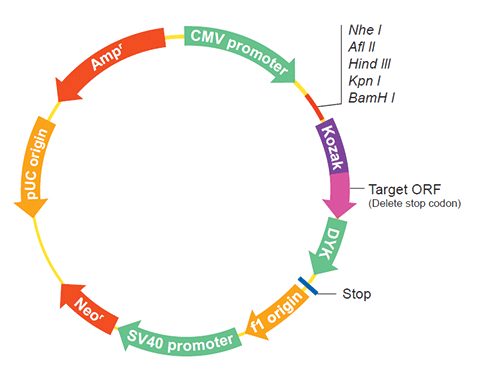
The following LOC108656733 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC108656733 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ODr338032 XM_030388651.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
ODr338032 XM_030388650.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
ODr338033 XM_030388652.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
ODr338034 XM_030388653.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
ODr338035 XM_030388654.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $643.30
$919.00
ODr338036 XM_030388655.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $559.30
$799.00
ODr253056 XM_018108978.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
ODr253057 XM_018108979.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
ODr253058 XM_018108980.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00
ODr253059 XM_018108981.1
Latest version!
Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ODr338032
    Clone ID Related Accession (Same CDS sequence) XM_030388651.1 , XM_030388650.1
    Accession Version XM_030388651.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3945bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046205.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AGCAGCTCCT GCAGCAGGAG
    CAGCAACAGC AGGAGCAGCA GCAACAGCAG CAGCAGGAGC AGCAACAACA GCAGAAGCAA
    ACGGTGCAAG CCAATGAGGT GGAGGAGAAG GAGAATGTGG AGAACGTCGT AATGCGCACC
    CATGACATAC CCAAGTCGCC GCATTTGGGC AAGGATTTCT CGCCGAGTGG CGAACGGCTG
    CGCGACAGCA TGCGGGCGCG TCGCCGGCAG CGTTTCCTGG GCGCCCAGCC GCAGCTGCGT
    GGCTTGACGC CGGAGACGAC ATCCACGGAG CGGGCGCTGA AGCAGGCGCT GAAGAAATGC
    CGTCCATTTG GCGAGAAGGG CTACCTGGTG GACCTGCGTC CCGGTGCGGA GCTGCAGCTG
    AACGATGTGC GGGACTTGAA TAACTATTCC GACGTCGACT CCAGCTGCGA TACGAGTCTC
    AACTACCACG AGGTGAATGT GACGCCAACG CCGACACCGA CGCCGCCGCC GCCGCCAGTG
    GCGCCAATGG CGCCGCCCAC ACCGCCGCCG CTGCCCGCCA CGCTCGTGCA TCAGTTGGCC
    TTCGAGGATA TGCGCACGCG TCTGCATCAG TGCCGCAGCA AGTTCGAGCA CCTGGAGGAG
    GCGAATCGCC GCAACTTCAG CCAGTCGCAG CACTCGATGC GCCACTTCTT CAAGACGCCG
    CCGGTGGCAT TGAAAATGTT CCAGCGGCTC GAGCACGAGG CATCGCTGAA TGGCAGCAGC
    AGCAGCAGCA GCTCAACGAC AGCTGCAGCC GCAGCAGCAG CGAAGCAACG CAGCACTCAG
    CGCATCAATC AGACGCCCAT CTTTGGGCGG CGCCAGCTGC CGGCAGAGCA GCCACGGCTG
    CAGCACGCCG GCTCCTTCGA GCAGCTGGTG ACGGCAGCGA AGCCAGCAAC TGTTGCCAAG
    CGCAGCAAAG CAGCCGAACA GCCGGCCACA GCAGGAGCAG CAGCAGGAGT AGCAGGAGCA
    GCACCGTCAA CACCAACAGC AGCAGCAGCA ACAACAACAA CAACGACAAC TGCAGCAACC
    TCAGCGGATT GCCTGGCCAA GAAGCACAAG CTGACGCTGC CGCTCTCAGC CACTTGGCAG
    CGCCGCGCCG CTCAGCCCAT CAGCAAAGCC ACAAAGCCAC CAAAATCAAC AACAGCCATA
    AACAGCCACA ACAACAGCAA CACCAACAAC AACAACAACA ACAGCAGCAA CAACAGCAAT
    GGCGCCTCGC CCACTCGCCA CCGACCGGGC TCACCGGGCA AACATCTCGC CCAGCGTCAC
    ACAGCAGCGA CGGCACAGCG CCAGAGCCAC AATCACGTCT CGTCTGCTCC CCAGCAGCTG
    TCGAAGAGCA CCCGCCTCAG CATTCTCAGT CCGGAGAAGG TGCATCGCCT GGGCGCTCGA
    CTCACTGACC AGAAGCAGAA GCTGCGCGAG GAGGCGGCAG CAGCAGCAGC TGCAGCGCTA
    ACGGGCAACA GCAATGGCCA CGCCCACGGC CACGGCCATG GACATGGACA CGGTCGAGCG
    GTGGTTGGTG GAACGGCGGC GGCGGGCAAC AGCGTGAATG TGGATCGTCG ACGTCGAGCA
    CCGCCGCCGC CGCCAGTGCG AACGCACTTT AATACGCGCT GTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030244511.1
    CDS1..3945
    Translation

    Target ORF information:

    RefSeq Version XM_030388651.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030388651.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AGCAGCTCCT GCAGCAGGAG
    CAGCAACAGC AGGAGCAGCA GCAACAGCAG CAGCAGGAGC AGCAACAACA GCAGAAGCAA
    ACGGTGCAAG CCAATGAGGT GGAGGAGAAG GAGAATGTGG AGAACGTCGT AATGCGCACC
    CATGACATAC CCAAGTCGCC GCATTTGGGC AAGGATTTCT CGCCGAGTGG CGAACGGCTG
    CGCGACAGCA TGCGGGCGCG TCGCCGGCAG CGTTTCCTGG GCGCCCAGCC GCAGCTGCGT
    GGCTTGACGC CGGAGACGAC ATCCACGGAG CGGGCGCTGA AGCAGGCGCT GAAGAAATGC
    CGTCCATTTG GCGAGAAGGG CTACCTGGTG GACCTGCGTC CCGGTGCGGA GCTGCAGCTG
    AACGATGTGC GGGACTTGAA TAACTATTCC GACGTCGACT CCAGCTGCGA TACGAGTCTC
    AACTACCACG AGGTGAATGT GACGCCAACG CCGACACCGA CGCCGCCGCC GCCGCCAGTG
    GCGCCAATGG CGCCGCCCAC ACCGCCGCCG CTGCCCGCCA CGCTCGTGCA TCAGTTGGCC
    TTCGAGGATA TGCGCACGCG TCTGCATCAG TGCCGCAGCA AGTTCGAGCA CCTGGAGGAG
    GCGAATCGCC GCAACTTCAG CCAGTCGCAG CACTCGATGC GCCACTTCTT CAAGACGCCG
    CCGGTGGCAT TGAAAATGTT CCAGCGGCTC GAGCACGAGG CATCGCTGAA TGGCAGCAGC
    AGCAGCAGCA GCTCAACGAC AGCTGCAGCC GCAGCAGCAG CGAAGCAACG CAGCACTCAG
    CGCATCAATC AGACGCCCAT CTTTGGGCGG CGCCAGCTGC CGGCAGAGCA GCCACGGCTG
    CAGCACGCCG GCTCCTTCGA GCAGCTGGTG ACGGCAGCGA AGCCAGCAAC TGTTGCCAAG
    CGCAGCAAAG CAGCCGAACA GCCGGCCACA GCAGGAGCAG CAGCAGGAGT AGCAGGAGCA
    GCACCGTCAA CACCAACAGC AGCAGCAGCA ACAACAACAA CAACGACAAC TGCAGCAACC
    TCAGCGGATT GCCTGGCCAA GAAGCACAAG CTGACGCTGC CGCTCTCAGC CACTTGGCAG
    CGCCGCGCCG CTCAGCCCAT CAGCAAAGCC ACAAAGCCAC CAAAATCAAC AACAGCCATA
    AACAGCCACA ACAACAGCAA CACCAACAAC AACAACAACA ACAGCAGCAA CAACAGCAAT
    GGCGCCTCGC CCACTCGCCA CCGACCGGGC TCACCGGGCA AACATCTCGC CCAGCGTCAC
    ACAGCAGCGA CGGCACAGCG CCAGAGCCAC AATCACGTCT CGTCTGCTCC CCAGCAGCTG
    TCGAAGAGCA CCCGCCTCAG CATTCTCAGT CCGGAGAAGG TGCATCGCCT GGGCGCTCGA
    CTCACTGACC AGAAGCAGAA GCTGCGCGAG GAGGCGGCAG CAGCAGCAGC TGCAGCGCTA
    ACGGGCAACA GCAATGGCCA CGCCCACGGC CACGGCCATG GACATGGACA CGGTCGAGCG
    GTGGTTGGTG GAACGGCGGC GGCGGGCAAC AGCGTGAATG TGGATCGTCG ACGTCGAGCA
    CCGCCGCCGC CGCCAGTGCG AACGCACTTT AATACGCGCT GTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr338032
    Clone ID Related Accession (Same CDS sequence) XM_030388651.1 , XM_030388650.1
    Accession Version XM_030388650.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3945bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046205.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AGCAGCTCCT GCAGCAGGAG
    CAGCAACAGC AGGAGCAGCA GCAACAGCAG CAGCAGGAGC AGCAACAACA GCAGAAGCAA
    ACGGTGCAAG CCAATGAGGT GGAGGAGAAG GAGAATGTGG AGAACGTCGT AATGCGCACC
    CATGACATAC CCAAGTCGCC GCATTTGGGC AAGGATTTCT CGCCGAGTGG CGAACGGCTG
    CGCGACAGCA TGCGGGCGCG TCGCCGGCAG CGTTTCCTGG GCGCCCAGCC GCAGCTGCGT
    GGCTTGACGC CGGAGACGAC ATCCACGGAG CGGGCGCTGA AGCAGGCGCT GAAGAAATGC
    CGTCCATTTG GCGAGAAGGG CTACCTGGTG GACCTGCGTC CCGGTGCGGA GCTGCAGCTG
    AACGATGTGC GGGACTTGAA TAACTATTCC GACGTCGACT CCAGCTGCGA TACGAGTCTC
    AACTACCACG AGGTGAATGT GACGCCAACG CCGACACCGA CGCCGCCGCC GCCGCCAGTG
    GCGCCAATGG CGCCGCCCAC ACCGCCGCCG CTGCCCGCCA CGCTCGTGCA TCAGTTGGCC
    TTCGAGGATA TGCGCACGCG TCTGCATCAG TGCCGCAGCA AGTTCGAGCA CCTGGAGGAG
    GCGAATCGCC GCAACTTCAG CCAGTCGCAG CACTCGATGC GCCACTTCTT CAAGACGCCG
    CCGGTGGCAT TGAAAATGTT CCAGCGGCTC GAGCACGAGG CATCGCTGAA TGGCAGCAGC
    AGCAGCAGCA GCTCAACGAC AGCTGCAGCC GCAGCAGCAG CGAAGCAACG CAGCACTCAG
    CGCATCAATC AGACGCCCAT CTTTGGGCGG CGCCAGCTGC CGGCAGAGCA GCCACGGCTG
    CAGCACGCCG GCTCCTTCGA GCAGCTGGTG ACGGCAGCGA AGCCAGCAAC TGTTGCCAAG
    CGCAGCAAAG CAGCCGAACA GCCGGCCACA GCAGGAGCAG CAGCAGGAGT AGCAGGAGCA
    GCACCGTCAA CACCAACAGC AGCAGCAGCA ACAACAACAA CAACGACAAC TGCAGCAACC
    TCAGCGGATT GCCTGGCCAA GAAGCACAAG CTGACGCTGC CGCTCTCAGC CACTTGGCAG
    CGCCGCGCCG CTCAGCCCAT CAGCAAAGCC ACAAAGCCAC CAAAATCAAC AACAGCCATA
    AACAGCCACA ACAACAGCAA CACCAACAAC AACAACAACA ACAGCAGCAA CAACAGCAAT
    GGCGCCTCGC CCACTCGCCA CCGACCGGGC TCACCGGGCA AACATCTCGC CCAGCGTCAC
    ACAGCAGCGA CGGCACAGCG CCAGAGCCAC AATCACGTCT CGTCTGCTCC CCAGCAGCTG
    TCGAAGAGCA CCCGCCTCAG CATTCTCAGT CCGGAGAAGG TGCATCGCCT GGGCGCTCGA
    CTCACTGACC AGAAGCAGAA GCTGCGCGAG GAGGCGGCAG CAGCAGCAGC TGCAGCGCTA
    ACGGGCAACA GCAATGGCCA CGCCCACGGC CACGGCCATG GACATGGACA CGGTCGAGCG
    GTGGTTGGTG GAACGGCGGC GGCGGGCAAC AGCGTGAATG TGGATCGTCG ACGTCGAGCA
    CCGCCGCCGC CGCCAGTGCG AACGCACTTT AATACGCGCT GTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030244510.1
    CDS350..4294
    Translation

    Target ORF information:

    RefSeq Version XM_030388650.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030388650.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AGCAGCTCCT GCAGCAGGAG
    CAGCAACAGC AGGAGCAGCA GCAACAGCAG CAGCAGGAGC AGCAACAACA GCAGAAGCAA
    ACGGTGCAAG CCAATGAGGT GGAGGAGAAG GAGAATGTGG AGAACGTCGT AATGCGCACC
    CATGACATAC CCAAGTCGCC GCATTTGGGC AAGGATTTCT CGCCGAGTGG CGAACGGCTG
    CGCGACAGCA TGCGGGCGCG TCGCCGGCAG CGTTTCCTGG GCGCCCAGCC GCAGCTGCGT
    GGCTTGACGC CGGAGACGAC ATCCACGGAG CGGGCGCTGA AGCAGGCGCT GAAGAAATGC
    CGTCCATTTG GCGAGAAGGG CTACCTGGTG GACCTGCGTC CCGGTGCGGA GCTGCAGCTG
    AACGATGTGC GGGACTTGAA TAACTATTCC GACGTCGACT CCAGCTGCGA TACGAGTCTC
    AACTACCACG AGGTGAATGT GACGCCAACG CCGACACCGA CGCCGCCGCC GCCGCCAGTG
    GCGCCAATGG CGCCGCCCAC ACCGCCGCCG CTGCCCGCCA CGCTCGTGCA TCAGTTGGCC
    TTCGAGGATA TGCGCACGCG TCTGCATCAG TGCCGCAGCA AGTTCGAGCA CCTGGAGGAG
    GCGAATCGCC GCAACTTCAG CCAGTCGCAG CACTCGATGC GCCACTTCTT CAAGACGCCG
    CCGGTGGCAT TGAAAATGTT CCAGCGGCTC GAGCACGAGG CATCGCTGAA TGGCAGCAGC
    AGCAGCAGCA GCTCAACGAC AGCTGCAGCC GCAGCAGCAG CGAAGCAACG CAGCACTCAG
    CGCATCAATC AGACGCCCAT CTTTGGGCGG CGCCAGCTGC CGGCAGAGCA GCCACGGCTG
    CAGCACGCCG GCTCCTTCGA GCAGCTGGTG ACGGCAGCGA AGCCAGCAAC TGTTGCCAAG
    CGCAGCAAAG CAGCCGAACA GCCGGCCACA GCAGGAGCAG CAGCAGGAGT AGCAGGAGCA
    GCACCGTCAA CACCAACAGC AGCAGCAGCA ACAACAACAA CAACGACAAC TGCAGCAACC
    TCAGCGGATT GCCTGGCCAA GAAGCACAAG CTGACGCTGC CGCTCTCAGC CACTTGGCAG
    CGCCGCGCCG CTCAGCCCAT CAGCAAAGCC ACAAAGCCAC CAAAATCAAC AACAGCCATA
    AACAGCCACA ACAACAGCAA CACCAACAAC AACAACAACA ACAGCAGCAA CAACAGCAAT
    GGCGCCTCGC CCACTCGCCA CCGACCGGGC TCACCGGGCA AACATCTCGC CCAGCGTCAC
    ACAGCAGCGA CGGCACAGCG CCAGAGCCAC AATCACGTCT CGTCTGCTCC CCAGCAGCTG
    TCGAAGAGCA CCCGCCTCAG CATTCTCAGT CCGGAGAAGG TGCATCGCCT GGGCGCTCGA
    CTCACTGACC AGAAGCAGAA GCTGCGCGAG GAGGCGGCAG CAGCAGCAGC TGCAGCGCTA
    ACGGGCAACA GCAATGGCCA CGCCCACGGC CACGGCCATG GACATGGACA CGGTCGAGCG
    GTGGTTGGTG GAACGGCGGC GGCGGGCAAC AGCGTGAATG TGGATCGTCG ACGTCGAGCA
    CCGCCGCCGC CGCCAGTGCG AACGCACTTT AATACGCGCT GTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr338033
    Clone ID Related Accession (Same CDS sequence) XM_030388652.1
    Accession Version XM_030388652.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3903bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046205.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CCAGCTCCAA TTCGGGCTCC
    ATCGATGCCA GTGCCATGTC GCCCAGCGGC ACGCTGCGGC GCAGCAAGAG CCGACAGCGC
    CGGCAGCGCT ACACAGTGGT GGGCAATCCC TATTGGATGG CGCCCGAAAT GATGAAGGGC
    CTCAAGTACG ATGAGAAAGT CGATGTCTTC TCCTTTGGCA TCATGCTCTG CGAGATAATT
    GGCCGTGTGG AAGCCGATCC GGATTATATG CCACGCAACT CGGATTTCAG TCTGAACCAG
    CAGGAGTTTC GCGAAAAGTT CTGCGCCCAG TGCCCGGAGG CGTTCGTCAA GGTGGCCTTT
    GTCTGCTGTG ATCTGAATCC GGATATGCGT CCATGCTTTG AGACGTTGTA CGTGTGGCTG
    GAGCAGCTGC GACAGCACCT GGACGCACAG CAACAGCCGC CGGCGCGTCT GCTGCACGAA
    ATCGAGAACT TTCAGGATAG CTACATCAGT TCGGAGGATG CGCTGTCGCC GACATCGCAG
    CGCAGCCTCG ACAATCTAAC GATGGCCGAG ACAGACAGAC CACAGCAGCA GCAGCAGCAG
    CAGCTCCTGC AGCAGGAGCA GCAACAGCAG GAGCAGCAGC AACAGCAGCA GCAGGAGCAG
    CAACAACAGC AGAAGCAAAC GGTGCAAGCC AATGAGGTGG AGGAGAAGGA GAATGTGGAG
    AACGTCGTAA TGCGCACCCA TGACATACCC AAGTCGCCGC ATTTGGGCAA GGATTTCTCG
    CCGAGTGGCG AACGGCTGCG CGACAGCATG CGGGCGCGTC GCCGGCAGCG TTTCCTGGGC
    GCCCAGCCGC AGCTGCGTGG CTTGACGCCG GAGACGACAT CCACGGAGCG GGCGCTGAAG
    CAGGCGCTGA AGAAATGCCG TCCATTTGGC GAGAAGGGCT ACCTGGTGGA CCTGCGTCCC
    GGTGCGGAGC TGCAGCTGAA CGATGTGCGG GACTTGAATA ACTATTCCGA CGTCGACTCC
    AGCTGCGATA CGAGTCTCAA CTACCACGAG GTGAATGTGA CGCCAACGCC GACACCGACG
    CCGCCGCCGC CGCCAGTGGC GCCAATGGCG CCGCCCACAC CGCCGCCGCT GCCCGCCACG
    CTCGTGCATC AGTTGGCCTT CGAGGATATG CGCACGCGTC TGCATCAGTG CCGCAGCAAG
    TTCGAGCACC TGGAGGAGGC GAATCGCCGC AACTTCAGCC AGTCGCAGCA CTCGATGCGC
    CACTTCTTCA AGACGCCGCC GGTGGCATTG AAAATGTTCC AGCGGCTCGA GCACGAGGCA
    TCGCTGAATG GCAGCAGCAG CAGCAGCAGC TCAACGACAG CTGCAGCCGC AGCAGCAGCG
    AAGCAACGCA GCACTCAGCG CATCAATCAG ACGCCCATCT TTGGGCGGCG CCAGCTGCCG
    GCAGAGCAGC CACGGCTGCA GCACGCCGGC TCCTTCGAGC AGCTGGTGAC GGCAGCGAAG
    CCAGCAACTG TTGCCAAGCG CAGCAAAGCA GCCGAACAGC CGGCCACAGC AGGAGCAGCA
    GCAGGAGTAG CAGGAGCAGC ACCGTCAACA CCAACAGCAG CAGCAGCAAC AACAACAACA
    ACGACAACTG CAGCAACCTC AGCGGATTGC CTGGCCAAGA AGCACAAGCT GACGCTGCCG
    CTCTCAGCCA CTTGGCAGCG CCGCGCCGCT CAGCCCATCA GCAAAGCCAC AAAGCCACCA
    AAATCAACAA CAGCCATAAA CAGCCACAAC AACAGCAACA CCAACAACAA CAACAACAAC
    AGCAGCAACA ACAGCAATGG CGCCTCGCCC ACTCGCCACC GACCGGGCTC ACCGGGCAAA
    CATCTCGCCC AGCGTCACAC AGCAGCGACG GCACAGCGCC AGAGCCACAA TCACGTCTCG
    TCTGCTCCCC AGCAGCTGTC GAAGAGCACC CGCCTCAGCA TTCTCAGTCC GGAGAAGGTG
    CATCGCCTGG GCGCTCGACT CACTGACCAG AAGCAGAAGC TGCGCGAGGA GGCGGCAGCA
    GCAGCAGCTG CAGCGCTAAC GGGCAACAGC AATGGCCACG CCCACGGCCA CGGCCATGGA
    CATGGACACG GTCGAGCGGT GGTTGGTGGA ACGGCGGCGG CGGGCAACAG CGTGAATGTG
    GATCGTCGAC GTCGAGCACC GCCGCCGCCG CCAGTGCGAA CGCACTTTAA TACGCGCTGT
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_030244512.1
    CDS349..4251
    Translation

    Target ORF information:

    RefSeq Version XM_030388652.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030388652.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CCAGCTCCAA TTCGGGCTCC
    ATCGATGCCA GTGCCATGTC GCCCAGCGGC ACGCTGCGGC GCAGCAAGAG CCGACAGCGC
    CGGCAGCGCT ACACAGTGGT GGGCAATCCC TATTGGATGG CGCCCGAAAT GATGAAGGGC
    CTCAAGTACG ATGAGAAAGT CGATGTCTTC TCCTTTGGCA TCATGCTCTG CGAGATAATT
    GGCCGTGTGG AAGCCGATCC GGATTATATG CCACGCAACT CGGATTTCAG TCTGAACCAG
    CAGGAGTTTC GCGAAAAGTT CTGCGCCCAG TGCCCGGAGG CGTTCGTCAA GGTGGCCTTT
    GTCTGCTGTG ATCTGAATCC GGATATGCGT CCATGCTTTG AGACGTTGTA CGTGTGGCTG
    GAGCAGCTGC GACAGCACCT GGACGCACAG CAACAGCCGC CGGCGCGTCT GCTGCACGAA
    ATCGAGAACT TTCAGGATAG CTACATCAGT TCGGAGGATG CGCTGTCGCC GACATCGCAG
    CGCAGCCTCG ACAATCTAAC GATGGCCGAG ACAGACAGAC CACAGCAGCA GCAGCAGCAG
    CAGCTCCTGC AGCAGGAGCA GCAACAGCAG GAGCAGCAGC AACAGCAGCA GCAGGAGCAG
    CAACAACAGC AGAAGCAAAC GGTGCAAGCC AATGAGGTGG AGGAGAAGGA GAATGTGGAG
    AACGTCGTAA TGCGCACCCA TGACATACCC AAGTCGCCGC ATTTGGGCAA GGATTTCTCG
    CCGAGTGGCG AACGGCTGCG CGACAGCATG CGGGCGCGTC GCCGGCAGCG TTTCCTGGGC
    GCCCAGCCGC AGCTGCGTGG CTTGACGCCG GAGACGACAT CCACGGAGCG GGCGCTGAAG
    CAGGCGCTGA AGAAATGCCG TCCATTTGGC GAGAAGGGCT ACCTGGTGGA CCTGCGTCCC
    GGTGCGGAGC TGCAGCTGAA CGATGTGCGG GACTTGAATA ACTATTCCGA CGTCGACTCC
    AGCTGCGATA CGAGTCTCAA CTACCACGAG GTGAATGTGA CGCCAACGCC GACACCGACG
    CCGCCGCCGC CGCCAGTGGC GCCAATGGCG CCGCCCACAC CGCCGCCGCT GCCCGCCACG
    CTCGTGCATC AGTTGGCCTT CGAGGATATG CGCACGCGTC TGCATCAGTG CCGCAGCAAG
    TTCGAGCACC TGGAGGAGGC GAATCGCCGC AACTTCAGCC AGTCGCAGCA CTCGATGCGC
    CACTTCTTCA AGACGCCGCC GGTGGCATTG AAAATGTTCC AGCGGCTCGA GCACGAGGCA
    TCGCTGAATG GCAGCAGCAG CAGCAGCAGC TCAACGACAG CTGCAGCCGC AGCAGCAGCG
    AAGCAACGCA GCACTCAGCG CATCAATCAG ACGCCCATCT TTGGGCGGCG CCAGCTGCCG
    GCAGAGCAGC CACGGCTGCA GCACGCCGGC TCCTTCGAGC AGCTGGTGAC GGCAGCGAAG
    CCAGCAACTG TTGCCAAGCG CAGCAAAGCA GCCGAACAGC CGGCCACAGC AGGAGCAGCA
    GCAGGAGTAG CAGGAGCAGC ACCGTCAACA CCAACAGCAG CAGCAGCAAC AACAACAACA
    ACGACAACTG CAGCAACCTC AGCGGATTGC CTGGCCAAGA AGCACAAGCT GACGCTGCCG
    CTCTCAGCCA CTTGGCAGCG CCGCGCCGCT CAGCCCATCA GCAAAGCCAC AAAGCCACCA
    AAATCAACAA CAGCCATAAA CAGCCACAAC AACAGCAACA CCAACAACAA CAACAACAAC
    AGCAGCAACA ACAGCAATGG CGCCTCGCCC ACTCGCCACC GACCGGGCTC ACCGGGCAAA
    CATCTCGCCC AGCGTCACAC AGCAGCGACG GCACAGCGCC AGAGCCACAA TCACGTCTCG
    TCTGCTCCCC AGCAGCTGTC GAAGAGCACC CGCCTCAGCA TTCTCAGTCC GGAGAAGGTG
    CATCGCCTGG GCGCTCGACT CACTGACCAG AAGCAGAAGC TGCGCGAGGA GGCGGCAGCA
    GCAGCAGCTG CAGCGCTAAC GGGCAACAGC AATGGCCACG CCCACGGCCA CGGCCATGGA
    CATGGACACG GTCGAGCGGT GGTTGGTGGA ACGGCGGCGG CGGGCAACAG CGTGAATGTG
    GATCGTCGAC GTCGAGCACC GCCGCCGCCG CCAGTGCGAA CGCACTTTAA TACGCGCTGT
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr338034
    Clone ID Related Accession (Same CDS sequence) XM_030388653.1
    Accession Version XM_030388653.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3858bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046205.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGAGAT CGATGTGAAT
    CTCACGAATT TGCATATCGG CGATCGGATT CTGGAGGTGA ATGGCACGCC CGTCAGCAAC
    TCGTCTGTGG ATCAGATCGA CAAGCTGATA CGCAGCAATG AGAAGATGCT GCAGCTAACG
    GTGGAGCACG ATCCGGTGCA GGTGTGTCGC AGCTGCAGCC AGGCGGACAT TCAGCGCGCC
    AGCTCCGCCT CGACTCTGAT CCTGCCGCTG AGCACGTCTG CGTCCAGTGT TGAGGTCGGT
    GGGCGTGGCC GTGAGCGACT GTACAAGGCA GCGGCCACCG AGCCCAGCGG CAAGATGCGC
    AAGATGCGAC AGCAAACGTT GCAAACCAGC AAATCAGTGC AGCAAACGAC GGGGCAGCAG
    CAGCAGCAGC AGCAGCAGCA ACATCCAGCG GAGCAACTGT CGTCGCAGCT GAAGGAGAAG
    GAGCGCTGCT CGAGCCTCTC GAAACTGCTG GACGAACAGC ACACGGCACA GCAGCACTCG
    GCGCATCCGC AGCTATACGA TTTGTCGCGC ACGCAGAGCT GTCGCGTCGT CCAGAAGCCG
    CAGCGCATCT TTCGCGCCTC CGATCTGGTG ATGGGCGAGA AGCTGGGCGA GGGCTTCTTT
    GGCAAGGTGT TTAAGGTAAC GCATCGGCTC ACCGGCGAGC TGATGGTCCT CAAGGAGCTG
    CATCGCGCCG ACGAGGAGGC GCAGCGCAAT TTCATCAAGG AGGTAGCCGT GCTGCGGCTG
    CTCGACCATC GGCATGTGCT CAAGTTCATC GGCGTGCTCT ACAAGGACAA GAAGCTGCAC
    ATGGTCACGG AGTATGTGGC CGGCGGCTGC CTCAAGGAGC TGATCCACGA CTCGAGTCGC
    GTGCTCAGCT GGTCGCAGCG CGTCTGCCTG GCCAGAGACA TCGCCTGCGG CATGAGCTAT
    CTGCATTCGA TGAACATCAT CCATCGTGAT CTCAATTCAA TGAATTGTCT CGTGCGCGAG
    GATCAATCGG TGATCGTTGC CGACTTTGGT CTGGCGCGCA GTGTCGATGC ACCGCGCCTG
    CCCGGCGCTG GCGCTGCCAC CGGTGCCGGT GCCGGTGTCG GTGCCGGCTC TGCCGCCAGC
    TCCAATTCGG GCTCCATCGA TGCCAGTGCC ATGTCGCCCA GCGGCACGCT GCGGCGCAGC
    AAGAGCCGAC AGCGCCGGCA GCGCTACACA GTGGTGGGCA ATCCCTATTG GATGGCGCCC
    GAAATGATGA AGGGCCTCAA GTACGATGAG AAAGTCGATG TCTTCTCCTT TGGCATCATG
    CTCTGCGAGA TAATTGGCCG TGTGGAAGCC GATCCGGATT ATATGCCACG CAACTCGGAT
    TTCAGTCTGA ACCAGCAGGA GTTTCGCGAA AAGTTCTGCG CCCAGTGCCC GGAGGCGTTC
    GTCAAGGTGG CCTTTGTCTG CTGTGATCTG AATCCGGATA TGCGTCCATG CTTTGAGACG
    TTGTACGTGT GGCTGGAGCA GCTGCGACAG CACCTGGACG CACAGCAACA GCCGCCGGCG
    CGTCTGCTGC ACGAAATCGA GAACTTTCAG GATAGCTACA TCAGTTCGGA GGATGCGCTG
    TCGCCGACAT CGCAGCGCAG CCTCGACAAT CTAACGATGG CCGAGACAGA CAGACCACAG
    CAGCAGCAGC AGCAGCAGCT CCTGCAGCAG GAGCAGCAAC AGCAGGAGCA GCAGCAACAG
    CAGCAGCAGG AGCAGCAACA ACAGCAGAAG CAAACGGTGC AAGCCAATGA GGTGGAGGAG
    AAGGAGAATG TGGAGAACGT CGTAATGCGC ACCCATGACA TACCCAAGTC GCCGCATTTG
    GGCAAGGATT TCTCGCCGAG TGGCGAACGG CTGCGCGACA GCATGCGGGC GCGTCGCCGG
    CAGCGTTTCC TGGGCGCCCA GCCGCAGCTG CGTGGCTTGA CGCCGGAGAC GACATCCACG
    GAGCGGGCGC TGAAGCAGGC GCTGAAGAAA TGCCGTCCAT TTGGCGAGAA GGGCTACCTG
    GTGGACCTGC GTCCCGGTGC GGAGCTGCAG CTGAACGATG TGCGGGACTT GAATAACTAT
    TCCGACGTCG ACTCCAGCTG CGATACGAGT CTCAACTACC ACGAGGTGAA TGTGACGCCA
    ACGCCGACAC CGACGCCGCC GCCGCCGCCA GTGGCGCCAA TGGCGCCGCC CACACCGCCG
    CCGCTGCCCG CCACGCTCGT GCATCAGTTG GCCTTCGAGG ATATGCGCAC GCGTCTGCAT
    CAGTGCCGCA GCAAGTTCGA GCACCTGGAG GAGGCGAATC GCCGCAACTT CAGCCAGTCG
    CAGCACTCGA TGCGCCACTT CTTCAAGACG CCGCCGGTGG CATTGAAAAT GTTCCAGCGG
    CTCGAGCACG AGGCATCGCT GAATGGCAGC AGCAGCAGCA GCAGCTCAAC GACAGCTGCA
    GCCGCAGCAG CAGCGAAGCA ACGCAGCACT CAGCGCATCA ATCAGACGCC CATCTTTGGG
    CGGCGCCAGC TGCCGGCAGA GCAGCCACGG CTGCAGCACG CCGGCTCCTT CGAGCAGCTG
    GTGACGGCAG CGAAGCCAGC AACTGTTGCC AAGCGCAGCA AAGCAGCCGA ACAGCCGGCC
    ACAGCAGGAG CAGCAGCAGG AGTAGCAGGA GCAGCACCGT CAACACCAAC AGCAGCAGCA
    GCAACAACAA CAACAACGAC AACTGCAGCA ACCTCAGCGG ATTGCCTGGC CAAGAAGCAC
    AAGCTGACGC TGCCGCTCTC AGCCACTTGG CAGCGCCGCG CCGCTCAGCC CATCAGCAAA
    GCCACAAAGC CACCAAAATC AACAACAGCC ATAAACAGCC ACAACAACAG CAACACCAAC
    AACAACAACA ACAACAGCAG CAACAACAGC AATGGCGCCT CGCCCACTCG CCACCGACCG
    GGCTCACCGG GCAAACATCT CGCCCAGCGT CACACAGCAG CGACGGCACA GCGCCAGAGC
    CACAATCACG TCTCGTCTGC TCCCCAGCAG CTGTCGAAGA GCACCCGCCT CAGCATTCTC
    AGTCCGGAGA AGGTGCATCG CCTGGGCGCT CGACTCACTG ACCAGAAGCA GAAGCTGCGC
    GAGGAGGCGG CAGCAGCAGC AGCTGCAGCG CTAACGGGCA ACAGCAATGG CCACGCCCAC
    GGCCACGGCC ATGGACATGG ACACGGTCGA GCGGTGGTTG GTGGAACGGC GGCGGCGGGC
    AACAGCGTGA ATGTGGATCG TCGACGTCGA GCACCGCCGC CGCCGCCAGT GCGAACGCAC
    TTTAATACGC GCTGTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030244513.1
    CDS346..4203
    Translation

    Target ORF information:

    RefSeq Version XM_030388653.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030388653.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGAGAT CGATGTGAAT
    CTCACGAATT TGCATATCGG CGATCGGATT CTGGAGGTGA ATGGCACGCC CGTCAGCAAC
    TCGTCTGTGG ATCAGATCGA CAAGCTGATA CGCAGCAATG AGAAGATGCT GCAGCTAACG
    GTGGAGCACG ATCCGGTGCA GGTGTGTCGC AGCTGCAGCC AGGCGGACAT TCAGCGCGCC
    AGCTCCGCCT CGACTCTGAT CCTGCCGCTG AGCACGTCTG CGTCCAGTGT TGAGGTCGGT
    GGGCGTGGCC GTGAGCGACT GTACAAGGCA GCGGCCACCG AGCCCAGCGG CAAGATGCGC
    AAGATGCGAC AGCAAACGTT GCAAACCAGC AAATCAGTGC AGCAAACGAC GGGGCAGCAG
    CAGCAGCAGC AGCAGCAGCA ACATCCAGCG GAGCAACTGT CGTCGCAGCT GAAGGAGAAG
    GAGCGCTGCT CGAGCCTCTC GAAACTGCTG GACGAACAGC ACACGGCACA GCAGCACTCG
    GCGCATCCGC AGCTATACGA TTTGTCGCGC ACGCAGAGCT GTCGCGTCGT CCAGAAGCCG
    CAGCGCATCT TTCGCGCCTC CGATCTGGTG ATGGGCGAGA AGCTGGGCGA GGGCTTCTTT
    GGCAAGGTGT TTAAGGTAAC GCATCGGCTC ACCGGCGAGC TGATGGTCCT CAAGGAGCTG
    CATCGCGCCG ACGAGGAGGC GCAGCGCAAT TTCATCAAGG AGGTAGCCGT GCTGCGGCTG
    CTCGACCATC GGCATGTGCT CAAGTTCATC GGCGTGCTCT ACAAGGACAA GAAGCTGCAC
    ATGGTCACGG AGTATGTGGC CGGCGGCTGC CTCAAGGAGC TGATCCACGA CTCGAGTCGC
    GTGCTCAGCT GGTCGCAGCG CGTCTGCCTG GCCAGAGACA TCGCCTGCGG CATGAGCTAT
    CTGCATTCGA TGAACATCAT CCATCGTGAT CTCAATTCAA TGAATTGTCT CGTGCGCGAG
    GATCAATCGG TGATCGTTGC CGACTTTGGT CTGGCGCGCA GTGTCGATGC ACCGCGCCTG
    CCCGGCGCTG GCGCTGCCAC CGGTGCCGGT GCCGGTGTCG GTGCCGGCTC TGCCGCCAGC
    TCCAATTCGG GCTCCATCGA TGCCAGTGCC ATGTCGCCCA GCGGCACGCT GCGGCGCAGC
    AAGAGCCGAC AGCGCCGGCA GCGCTACACA GTGGTGGGCA ATCCCTATTG GATGGCGCCC
    GAAATGATGA AGGGCCTCAA GTACGATGAG AAAGTCGATG TCTTCTCCTT TGGCATCATG
    CTCTGCGAGA TAATTGGCCG TGTGGAAGCC GATCCGGATT ATATGCCACG CAACTCGGAT
    TTCAGTCTGA ACCAGCAGGA GTTTCGCGAA AAGTTCTGCG CCCAGTGCCC GGAGGCGTTC
    GTCAAGGTGG CCTTTGTCTG CTGTGATCTG AATCCGGATA TGCGTCCATG CTTTGAGACG
    TTGTACGTGT GGCTGGAGCA GCTGCGACAG CACCTGGACG CACAGCAACA GCCGCCGGCG
    CGTCTGCTGC ACGAAATCGA GAACTTTCAG GATAGCTACA TCAGTTCGGA GGATGCGCTG
    TCGCCGACAT CGCAGCGCAG CCTCGACAAT CTAACGATGG CCGAGACAGA CAGACCACAG
    CAGCAGCAGC AGCAGCAGCT CCTGCAGCAG GAGCAGCAAC AGCAGGAGCA GCAGCAACAG
    CAGCAGCAGG AGCAGCAACA ACAGCAGAAG CAAACGGTGC AAGCCAATGA GGTGGAGGAG
    AAGGAGAATG TGGAGAACGT CGTAATGCGC ACCCATGACA TACCCAAGTC GCCGCATTTG
    GGCAAGGATT TCTCGCCGAG TGGCGAACGG CTGCGCGACA GCATGCGGGC GCGTCGCCGG
    CAGCGTTTCC TGGGCGCCCA GCCGCAGCTG CGTGGCTTGA CGCCGGAGAC GACATCCACG
    GAGCGGGCGC TGAAGCAGGC GCTGAAGAAA TGCCGTCCAT TTGGCGAGAA GGGCTACCTG
    GTGGACCTGC GTCCCGGTGC GGAGCTGCAG CTGAACGATG TGCGGGACTT GAATAACTAT
    TCCGACGTCG ACTCCAGCTG CGATACGAGT CTCAACTACC ACGAGGTGAA TGTGACGCCA
    ACGCCGACAC CGACGCCGCC GCCGCCGCCA GTGGCGCCAA TGGCGCCGCC CACACCGCCG
    CCGCTGCCCG CCACGCTCGT GCATCAGTTG GCCTTCGAGG ATATGCGCAC GCGTCTGCAT
    CAGTGCCGCA GCAAGTTCGA GCACCTGGAG GAGGCGAATC GCCGCAACTT CAGCCAGTCG
    CAGCACTCGA TGCGCCACTT CTTCAAGACG CCGCCGGTGG CATTGAAAAT GTTCCAGCGG
    CTCGAGCACG AGGCATCGCT GAATGGCAGC AGCAGCAGCA GCAGCTCAAC GACAGCTGCA
    GCCGCAGCAG CAGCGAAGCA ACGCAGCACT CAGCGCATCA ATCAGACGCC CATCTTTGGG
    CGGCGCCAGC TGCCGGCAGA GCAGCCACGG CTGCAGCACG CCGGCTCCTT CGAGCAGCTG
    GTGACGGCAG CGAAGCCAGC AACTGTTGCC AAGCGCAGCA AAGCAGCCGA ACAGCCGGCC
    ACAGCAGGAG CAGCAGCAGG AGTAGCAGGA GCAGCACCGT CAACACCAAC AGCAGCAGCA
    GCAACAACAA CAACAACGAC AACTGCAGCA ACCTCAGCGG ATTGCCTGGC CAAGAAGCAC
    AAGCTGACGC TGCCGCTCTC AGCCACTTGG CAGCGCCGCG CCGCTCAGCC CATCAGCAAA
    GCCACAAAGC CACCAAAATC AACAACAGCC ATAAACAGCC ACAACAACAG CAACACCAAC
    AACAACAACA ACAACAGCAG CAACAACAGC AATGGCGCCT CGCCCACTCG CCACCGACCG
    GGCTCACCGG GCAAACATCT CGCCCAGCGT CACACAGCAG CGACGGCACA GCGCCAGAGC
    CACAATCACG TCTCGTCTGC TCCCCAGCAG CTGTCGAAGA GCACCCGCCT CAGCATTCTC
    AGTCCGGAGA AGGTGCATCG CCTGGGCGCT CGACTCACTG ACCAGAAGCA GAAGCTGCGC
    GAGGAGGCGG CAGCAGCAGC AGCTGCAGCG CTAACGGGCA ACAGCAATGG CCACGCCCAC
    GGCCACGGCC ATGGACATGG ACACGGTCGA GCGGTGGTTG GTGGAACGGC GGCGGCGGGC
    AACAGCGTGA ATGTGGATCG TCGACGTCGA GCACCGCCGC CGCCGCCAGT GCGAACGCAC
    TTTAATACGC GCTGTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr338035
    Clone ID Related Accession (Same CDS sequence) XM_030388654.1
    Accession Version XM_030388654.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3783bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046205.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AGCAGCTCCT GCAGCAGGAG
    CAGCAACAGC AGGAGCAGCA GCAACAGCAG CAGCAGGAGC AGCAACAACA GCAGAAGCAA
    ACGGTGCAAG CCAATGAGGT GGAGGAGAAG GAGAATGTGG AGAACGTCGT AATGCGCACC
    CATGACATAC CCAAGTCGCC GCATTTGGGC AAGGATTTCT CGCCGAGTGG CGAACGGCTG
    CGCGACAGCA TGCGGGCGCG TCGCCGGCAG CGTTTCCTGG GCGCCCAGCC GCAGCTGCGT
    GGCTTGACGC CGGAGACGAC ATCCACGGAG CGGGCGCTGA AGCAGGCGCT GAAGAAATGC
    CGTCCATTTG GCGAGAAGGG CTACCTGGTG GACCTGCGTC CCGGTGCGGA GCTGCAGCTG
    AACGATGTGC GGGACTTGAA TAACTATTCC GACGTCGACT CCAGCTGCGA TACGAGTCTC
    AACTACCACG AGGTGAATGT GACGCCAACG CCGACACCGA CGCCGCCGCC GCCGCCAGTG
    GCGCCAATGG CGCCGCCCAC ACCGCCGCCG CTGCCCGCCA CGCTCGTGCA TCAGTTGGCC
    TTCGAGGATA TGCGCACGCG TCTGCATCAG TGCCGCAGCA AGTTCGAGCA CCTGGAGGAG
    GCGAATCGCC GCAACTTCAG CCAGTCGCAG CACTCGATGC GCCACTTCTT CAAGACGCCG
    CCGGTGGCAT TGAAAATGTT CCAGCGGCTC GAGCACGAGG CATCGCTGAA TGGCAGCAGC
    AGCAGCAGCA GCTCAACGAC AGCTGCAGCC GCAGCAGCAG CGAAGCAACG CAGCACTCAG
    CGCATCAATC AGACGCCCAT CTTTGGGCGG CGCCAGCTGC CGGCAGAGCA GCCACGGCTG
    CAGCACGCCG GCTCCTTCGA GCAGCTGGTG ACGGCAGCGA AGCCAGCAAC TGTTGCCAAG
    CGCAGCAAAG CAGCCGAACA GCCGGCCACA GCAGGAGCAG CAGCAGGAGT AGCAGGAGCA
    GCACCGTCAA CACCAACAGC AGCAGCAGCA ACAACAACAA CAACGACAAC TGCAGCAACC
    TCAGCGGATT GCCTGGCCAA GAAGCACAAG CTGACGCTGC CGCTCTCAGC CACTTGGCAG
    CGCCGCGCCG CTCAGCCCAT CAGCAAAGCC ACAAAGCCAC CAAAATCAAC AACAGCCATA
    AACAGCCACA ACAACAGCAA CACCAACAAC AACAACAACA ACAGCAGCAA CAACAGCAAT
    GGCGCCTCGC CCACTCGCCA CCGACCGGGC TCACCGGGCA AACATCTCGC CCAGCGTCAC
    ACAGCAGCGA CGGCACAGCG CCAGAGCCAC AATCACGTTT CTCGTCTGCT CCCCAGCAGC
    TGTCGAAGAG CACCCGCCTC AGCATTCTCA GTCCGGAGAA GGTGCATCGC CTGGGCGCTC
    GACTCACTGA CCAGAAGCAG AAGCTGCGCG AGGAGGCGGC AGCAGCAGCA GCTGCAGCGC
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030244514.1
    CDS349..4131
    Translation

    Target ORF information:

    RefSeq Version XM_030388654.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030388654.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AGCAGCTCCT GCAGCAGGAG
    CAGCAACAGC AGGAGCAGCA GCAACAGCAG CAGCAGGAGC AGCAACAACA GCAGAAGCAA
    ACGGTGCAAG CCAATGAGGT GGAGGAGAAG GAGAATGTGG AGAACGTCGT AATGCGCACC
    CATGACATAC CCAAGTCGCC GCATTTGGGC AAGGATTTCT CGCCGAGTGG CGAACGGCTG
    CGCGACAGCA TGCGGGCGCG TCGCCGGCAG CGTTTCCTGG GCGCCCAGCC GCAGCTGCGT
    GGCTTGACGC CGGAGACGAC ATCCACGGAG CGGGCGCTGA AGCAGGCGCT GAAGAAATGC
    CGTCCATTTG GCGAGAAGGG CTACCTGGTG GACCTGCGTC CCGGTGCGGA GCTGCAGCTG
    AACGATGTGC GGGACTTGAA TAACTATTCC GACGTCGACT CCAGCTGCGA TACGAGTCTC
    AACTACCACG AGGTGAATGT GACGCCAACG CCGACACCGA CGCCGCCGCC GCCGCCAGTG
    GCGCCAATGG CGCCGCCCAC ACCGCCGCCG CTGCCCGCCA CGCTCGTGCA TCAGTTGGCC
    TTCGAGGATA TGCGCACGCG TCTGCATCAG TGCCGCAGCA AGTTCGAGCA CCTGGAGGAG
    GCGAATCGCC GCAACTTCAG CCAGTCGCAG CACTCGATGC GCCACTTCTT CAAGACGCCG
    CCGGTGGCAT TGAAAATGTT CCAGCGGCTC GAGCACGAGG CATCGCTGAA TGGCAGCAGC
    AGCAGCAGCA GCTCAACGAC AGCTGCAGCC GCAGCAGCAG CGAAGCAACG CAGCACTCAG
    CGCATCAATC AGACGCCCAT CTTTGGGCGG CGCCAGCTGC CGGCAGAGCA GCCACGGCTG
    CAGCACGCCG GCTCCTTCGA GCAGCTGGTG ACGGCAGCGA AGCCAGCAAC TGTTGCCAAG
    CGCAGCAAAG CAGCCGAACA GCCGGCCACA GCAGGAGCAG CAGCAGGAGT AGCAGGAGCA
    GCACCGTCAA CACCAACAGC AGCAGCAGCA ACAACAACAA CAACGACAAC TGCAGCAACC
    TCAGCGGATT GCCTGGCCAA GAAGCACAAG CTGACGCTGC CGCTCTCAGC CACTTGGCAG
    CGCCGCGCCG CTCAGCCCAT CAGCAAAGCC ACAAAGCCAC CAAAATCAAC AACAGCCATA
    AACAGCCACA ACAACAGCAA CACCAACAAC AACAACAACA ACAGCAGCAA CAACAGCAAT
    GGCGCCTCGC CCACTCGCCA CCGACCGGGC TCACCGGGCA AACATCTCGC CCAGCGTCAC
    ACAGCAGCGA CGGCACAGCG CCAGAGCCAC AATCACGTTT CTCGTCTGCT CCCCAGCAGC
    TGTCGAAGAG CACCCGCCTC AGCATTCTCA GTCCGGAGAA GGTGCATCGC CTGGGCGCTC
    GACTCACTGA CCAGAAGCAG AAGCTGCGCG AGGAGGCGGC AGCAGCAGCA GCTGCAGCGC
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr338036
    Clone ID Related Accession (Same CDS sequence) XM_030388655.1
    Accession Version XM_030388655.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3273bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022046205.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGATCGATG TGAATCTCAC GAATTTGCAT ATCGGCGATC GGATTCTGGA GGTGAATGGC 
    ACGCCCGTCA GCAACTCGTC TGTGGATCAG ATCGACAAGC TGATACGCAG CAATGAGAAG
    ATGCTGCAGC TAACGGTGGA GCACGATCCG GTGCAGGTGT GTCGCAGCTG CAGCCAGGCG
    GACATTCAGC GCGCCAGCTC CGCCTCGACT CTGATCCTGC CGCTGAGCAC GTCTGCGTCC
    AGTGTTGAGG TCGGTGGGCG TGGCCGTGAG CGACTGTACA AGGCAGCGGC CACCGAGCCC
    AGCGGCAAGA TGCGCAAGAT GCGACAGCAA ACGTTGCAAA CCAGCAAATC AGTGCAGCAA
    ACGACGGGGC AGCAGCAGCA GCAGCAGCAG CAGCAACATC CAGCGGAGCA ACTGTCGTCG
    CAGCTGAAGG AGAAGGAGCG CTGCTCGAGC CTCTCGAAAC TGCTGGACGA ACAGCACACG
    GCACAGCAGC ACTCGGCGCA TCCGCAGCTA TACGATTTGT CGCGCACGCA GAGCTGTCGC
    GTCGTCCAGA AGCCGCAGCG CATCTTTCGC GCCTCCGATC TGGTGATGGG CGAGAAGCTG
    GGCGAGGGCT TCTTTGGCAA GGTGTTTAAG GTAACGCATC GGCTCACCGG CGAGCTGATG
    GTCCTCAAGG AGCTGCATCG CGCCGACGAG GAGGCGCAGC GCAATTTCAT CAAGGAGGTA
    GCCGTGCTGC GGCTGCTCGA CCATCGGCAT GTGCTCAAGT TCATCGGCGT GCTCTACAAG
    GACAAGAAGC TGCACATGGT CACGGAGTAT GTGGCCGGCG GCTGCCTCAA GGAGCTGATC
    CACGACTCGA GTCGCGTGCT CAGCTGGTCG CAGCGCGTCT GCCTGGCCAG AGACATCGCC
    TGCGGCATGA GCTATCTGCA TTCGATGAAC ATCATCCATC GTGATCTCAA TTCAATGAAT
    TGTCTCGTGC GCGAGGATCA ATCGGTGATC GTTGCCGACT TTGGTCTGGC GCGCAGTGTC
    GATGCACCGC GCCTGCCCGG CGCTGGCGCT GCCACCGGTG CCGGTGCCGG TGTCGGTGCC
    GGCTCTGCCG CCAGCTCCAA TTCGGGCTCC ATCGATGCCA GTGCCATGTC GCCCAGCGGC
    ACGCTGCGGC GCAGCAAGAG CCGACAGCGC CGGCAGCGCT ACACAGTGGT GGGCAATCCC
    TATTGGATGG CGCCCGAAAT GATGAAGGGC CTCAAGTACG ATGAGAAAGT CGATGTCTTC
    TCCTTTGGCA TCATGCTCTG CGAGATAATT GGCCGTGTGG AAGCCGATCC GGATTATATG
    CCACGCAACT CGGATTTCAG TCTGAACCAG CAGGAGTTTC GCGAAAAGTT CTGCGCCCAG
    TGCCCGGAGG CGTTCGTCAA GGTGGCCTTT GTCTGCTGTG ATCTGAATCC GGATATGCGT
    CCATGCTTTG AGACGTTGTA CGTGTGGCTG GAGCAGCTGC GACAGCACCT GGACGCACAG
    CAACAGCCGC CGGCGCGTCT GCTGCACGAA ATCGAGAACT TTCAGGATAG CTACATCAGT
    TCGGAGGATG CGCTGTCGCC GACATCGCAG CGCAGCCTCG ACAATCTAAC GATGGCCGAG
    ACAGACAGAC CACAGCAGCA GCAGCAGCAG CAGCTCCTGC AGCAGGAGCA GCAACAGCAG
    GAGCAGCAGC AACAGCAGCA GCAGGAGCAG CAACAACAGC AGAAGCAAAC GGTGCAAGCC
    AATGAGGTGG AGGAGAAGGA GAATGTGGAG AACGTCGTAA TGCGCACCCA TGACATACCC
    AAGTCGCCGC ATTTGGGCAA GGATTTCTCG CCGAGTGGCG AACGGCTGCG CGACAGCATG
    CGGGCGCGTC GCCGGCAGCG TTTCCTGGGC GCCCAGCCGC AGCTGCGTGG CTTGACGCCG
    GAGACGACAT CCACGGAGCG GGCGCTGAAG CAGGCGCTGA AGAAATGCCG TCCATTTGGC
    GAGAAGGGCT ACCTGGTGGA CCTGCGTCCC GGTGCGGAGC TGCAGCTGAA CGATGTGCGG
    GACTTGAATA ACTATTCCGA CGTCGACTCC AGCTGCGATA CGAGTCTCAA CTACCACGAG
    GTGAATGTGA CGCCAACGCC GACACCGACG CCGCCGCCGC CGCCAGTGGC GCCAATGGCG
    CCGCCCACAC CGCCGCCGCT GCCCGCCACG CTCGTGCATC AGTTGGCCTT CGAGGATATG
    CGCACGCGTC TGCATCAGTG CCGCAGCAAG TTCGAGCACC TGGAGGAGGC GAATCGCCGC
    AACTTCAGCC AGTCGCAGCA CTCGATGCGC CACTTCTTCA AGACGCCGCC GGTGGCATTG
    AAAATGTTCC AGCGGCTCGA GCACGAGGCA TCGCTGAATG GCAGCAGCAG CAGCAGCAGC
    TCAACGACAG CTGCAGCCGC AGCAGCAGCG AAGCAACGCA GCACTCAGCG CATCAATCAG
    ACGCCCATCT TTGGGCGGCG CCAGCTGCCG GCAGAGCAGC CACGGCTGCA GCACGCCGGC
    TCCTTCGAGC AGCTGGTGAC GGCAGCGAAG CCAGCAACTG TTGCCAAGCG CAGCAAAGCA
    GCCGAACAGC CGGCCACAGC AGGAGCAGCA GCAGGAGTAG CAGGAGCAGC ACCGTCAACA
    CCAACAGCAG CAGCAGCAAC AACAACAACA ACGACAACTG CAGCAACCTC AGCGGATTGC
    CTGGCCAAGA AGCACAAGCT GACGCTGCCG CTCTCAGCCA CTTGGCAGCG CCGCGCCGCT
    CAGCCCATCA GCAAAGCCAC AAAGCCACCA AAATCAACAA CAGCCATAAA CAGCCACAAC
    AACAGCAACA CCAACAACAA CAACAACAAC AGCAGCAACA ACAGCAATGG CGCCTCGCCC
    ACTCGCCACC GACCGGGCTC ACCGGGCAAA CATCTCGCCC AGCGTCACAC AGCAGCGACG
    GCACAGCGCC AGAGCCACAA TCACGTCTCG TCTGCTCCCC AGCAGCTGTC GAAGAGCACC
    CGCCTCAGCA TTCTCAGTCC GGAGAAGGTG CATCGCCTGG GCGCTCGACT CACTGACCAG
    AAGCAGAAGC TGCGCGAGGA GGCGGCAGCA GCAGCAGCTG CAGCGCTAAC GGGCAACAGC
    AATGGCCACG CCCACGGCCA CGGCCATGGA CATGGACACG GTCGAGCGGT GGTTGGTGGA
    ACGGCGGCGG CGGGCAACAG CGTGAATGTG GATCGTCGAC GTCGAGCACC GCCGCCGCCG
    CCAGTGCGAA CGCACTTTAA TACGCGCTGT TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030244515.1
    CDS294..3566
    Translation

    Target ORF information:

    RefSeq Version XM_030388655.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030388655.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGATCGATG TGAATCTCAC GAATTTGCAT ATCGGCGATC GGATTCTGGA GGTGAATGGC 
    ACGCCCGTCA GCAACTCGTC TGTGGATCAG ATCGACAAGC TGATACGCAG CAATGAGAAG
    ATGCTGCAGC TAACGGTGGA GCACGATCCG GTGCAGGTGT GTCGCAGCTG CAGCCAGGCG
    GACATTCAGC GCGCCAGCTC CGCCTCGACT CTGATCCTGC CGCTGAGCAC GTCTGCGTCC
    AGTGTTGAGG TCGGTGGGCG TGGCCGTGAG CGACTGTACA AGGCAGCGGC CACCGAGCCC
    AGCGGCAAGA TGCGCAAGAT GCGACAGCAA ACGTTGCAAA CCAGCAAATC AGTGCAGCAA
    ACGACGGGGC AGCAGCAGCA GCAGCAGCAG CAGCAACATC CAGCGGAGCA ACTGTCGTCG
    CAGCTGAAGG AGAAGGAGCG CTGCTCGAGC CTCTCGAAAC TGCTGGACGA ACAGCACACG
    GCACAGCAGC ACTCGGCGCA TCCGCAGCTA TACGATTTGT CGCGCACGCA GAGCTGTCGC
    GTCGTCCAGA AGCCGCAGCG CATCTTTCGC GCCTCCGATC TGGTGATGGG CGAGAAGCTG
    GGCGAGGGCT TCTTTGGCAA GGTGTTTAAG GTAACGCATC GGCTCACCGG CGAGCTGATG
    GTCCTCAAGG AGCTGCATCG CGCCGACGAG GAGGCGCAGC GCAATTTCAT CAAGGAGGTA
    GCCGTGCTGC GGCTGCTCGA CCATCGGCAT GTGCTCAAGT TCATCGGCGT GCTCTACAAG
    GACAAGAAGC TGCACATGGT CACGGAGTAT GTGGCCGGCG GCTGCCTCAA GGAGCTGATC
    CACGACTCGA GTCGCGTGCT CAGCTGGTCG CAGCGCGTCT GCCTGGCCAG AGACATCGCC
    TGCGGCATGA GCTATCTGCA TTCGATGAAC ATCATCCATC GTGATCTCAA TTCAATGAAT
    TGTCTCGTGC GCGAGGATCA ATCGGTGATC GTTGCCGACT TTGGTCTGGC GCGCAGTGTC
    GATGCACCGC GCCTGCCCGG CGCTGGCGCT GCCACCGGTG CCGGTGCCGG TGTCGGTGCC
    GGCTCTGCCG CCAGCTCCAA TTCGGGCTCC ATCGATGCCA GTGCCATGTC GCCCAGCGGC
    ACGCTGCGGC GCAGCAAGAG CCGACAGCGC CGGCAGCGCT ACACAGTGGT GGGCAATCCC
    TATTGGATGG CGCCCGAAAT GATGAAGGGC CTCAAGTACG ATGAGAAAGT CGATGTCTTC
    TCCTTTGGCA TCATGCTCTG CGAGATAATT GGCCGTGTGG AAGCCGATCC GGATTATATG
    CCACGCAACT CGGATTTCAG TCTGAACCAG CAGGAGTTTC GCGAAAAGTT CTGCGCCCAG
    TGCCCGGAGG CGTTCGTCAA GGTGGCCTTT GTCTGCTGTG ATCTGAATCC GGATATGCGT
    CCATGCTTTG AGACGTTGTA CGTGTGGCTG GAGCAGCTGC GACAGCACCT GGACGCACAG
    CAACAGCCGC CGGCGCGTCT GCTGCACGAA ATCGAGAACT TTCAGGATAG CTACATCAGT
    TCGGAGGATG CGCTGTCGCC GACATCGCAG CGCAGCCTCG ACAATCTAAC GATGGCCGAG
    ACAGACAGAC CACAGCAGCA GCAGCAGCAG CAGCTCCTGC AGCAGGAGCA GCAACAGCAG
    GAGCAGCAGC AACAGCAGCA GCAGGAGCAG CAACAACAGC AGAAGCAAAC GGTGCAAGCC
    AATGAGGTGG AGGAGAAGGA GAATGTGGAG AACGTCGTAA TGCGCACCCA TGACATACCC
    AAGTCGCCGC ATTTGGGCAA GGATTTCTCG CCGAGTGGCG AACGGCTGCG CGACAGCATG
    CGGGCGCGTC GCCGGCAGCG TTTCCTGGGC GCCCAGCCGC AGCTGCGTGG CTTGACGCCG
    GAGACGACAT CCACGGAGCG GGCGCTGAAG CAGGCGCTGA AGAAATGCCG TCCATTTGGC
    GAGAAGGGCT ACCTGGTGGA CCTGCGTCCC GGTGCGGAGC TGCAGCTGAA CGATGTGCGG
    GACTTGAATA ACTATTCCGA CGTCGACTCC AGCTGCGATA CGAGTCTCAA CTACCACGAG
    GTGAATGTGA CGCCAACGCC GACACCGACG CCGCCGCCGC CGCCAGTGGC GCCAATGGCG
    CCGCCCACAC CGCCGCCGCT GCCCGCCACG CTCGTGCATC AGTTGGCCTT CGAGGATATG
    CGCACGCGTC TGCATCAGTG CCGCAGCAAG TTCGAGCACC TGGAGGAGGC GAATCGCCGC
    AACTTCAGCC AGTCGCAGCA CTCGATGCGC CACTTCTTCA AGACGCCGCC GGTGGCATTG
    AAAATGTTCC AGCGGCTCGA GCACGAGGCA TCGCTGAATG GCAGCAGCAG CAGCAGCAGC
    TCAACGACAG CTGCAGCCGC AGCAGCAGCG AAGCAACGCA GCACTCAGCG CATCAATCAG
    ACGCCCATCT TTGGGCGGCG CCAGCTGCCG GCAGAGCAGC CACGGCTGCA GCACGCCGGC
    TCCTTCGAGC AGCTGGTGAC GGCAGCGAAG CCAGCAACTG TTGCCAAGCG CAGCAAAGCA
    GCCGAACAGC CGGCCACAGC AGGAGCAGCA GCAGGAGTAG CAGGAGCAGC ACCGTCAACA
    CCAACAGCAG CAGCAGCAAC AACAACAACA ACGACAACTG CAGCAACCTC AGCGGATTGC
    CTGGCCAAGA AGCACAAGCT GACGCTGCCG CTCTCAGCCA CTTGGCAGCG CCGCGCCGCT
    CAGCCCATCA GCAAAGCCAC AAAGCCACCA AAATCAACAA CAGCCATAAA CAGCCACAAC
    AACAGCAACA CCAACAACAA CAACAACAAC AGCAGCAACA ACAGCAATGG CGCCTCGCCC
    ACTCGCCACC GACCGGGCTC ACCGGGCAAA CATCTCGCCC AGCGTCACAC AGCAGCGACG
    GCACAGCGCC AGAGCCACAA TCACGTCTCG TCTGCTCCCC AGCAGCTGTC GAAGAGCACC
    CGCCTCAGCA TTCTCAGTCC GGAGAAGGTG CATCGCCTGG GCGCTCGACT CACTGACCAG
    AAGCAGAAGC TGCGCGAGGA GGCGGCAGCA GCAGCAGCTG CAGCGCTAAC GGGCAACAGC
    AATGGCCACG CCCACGGCCA CGGCCATGGA CATGGACACG GTCGAGCGGT GGTTGGTGGA
    ACGGCGGCGG CGGGCAACAG CGTGAATGTG GATCGTCGAC GTCGAGCACC GCCGCCGCCG
    CCAGTGCGAA CGCACTTTAA TACGCGCTGT TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253056
    Clone ID Related Accession (Same CDS sequence) XM_018108978.1
    Accession Version XM_018108978.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3903bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AACAGCAGCA GCAGGAGCAG
    CAACAACAGC AGAAGCAAAC GGTGCAAGCC AATGAGGTGG AGGAGAAGGA GAATGTGGAG
    AACGTCGTAA TGCGCACCCA TGACATACCC AAGTCGCCGC ATTTGGGCAA GGATTTCTCG
    CCGAGTGGCG AACGGCTGCG CGACAGCATG CGGGCGCGTC GCCGGCAGCG TTTCCTGGGC
    GCCCAGCCGC AGCTGCGTGG CTTGACGCCG GAGACGACAT CCACGGAGCG GGCGCTGAAG
    CAGGCGCTGA AGAAATGCCG TCCATTTGGC GAGAAGGGCT ACCTGGTGGA CCTGCGTCCC
    GGTGCGGAGC TGCAGCTGAA CGATGTGCGG GACTTGAATA ACTATTCCGA CGTCGACTCC
    AGCTGCGATA CGAGTCTCAA CTACCACGAG GTGAATGTGA CGCCAACGCC GACACCGACG
    CCGCCGCCGC CGCCAGTGGC GCCAATGGCG CCGCCCACAC CGCCGCCGCT GCCCGCCACG
    CTCGTGCATC AGTTGGCCTT CGAGGATATG CGCACGCGTC TGCATCAGTG CCGCAGCAAG
    TTCGAGCACC TGGAGGAGGC GAATCGCCGC AACTTCAGCC AGTCGCAGCA CTCGATGCGC
    CACTTCTTCA AGACGCCGCC GGTGGCATTG AAAATGTTCC AGCGGCTCGA GCACGAGGCA
    TCGCTGAATG GCAGCAGCAG CAGCAGCAGC TCAACGACAG CTGCAGCCGC AGCAGCAGCG
    AAGCAACGCA GCACTCAGCG CATCAATCAG ACGCCCATCT TTGGGCGGCG CCAGCTGCCG
    GCAGAGCAGC CACGGCTGCA GCACGCCGGC TCCTTCGAGC AGCTGGTGAC GGCAGCGAAG
    CCAGCAACTG TTGCCAAGCG CAGCAAAGCA GCCGAACAGC CGGCCACAGC AGGAGCAGCA
    GCAGGAGTAG CAGGAGCAGC ACCGTCAACA CCAACAGCAG CAGCAGCAAC AACAACAACA
    ACGACAACTG CAGCAACCTC AGCGGATTGC CTGGCCAAGA AGCACAAGCT GACGCTGCCG
    CTCTCAGCCA CTTGGCAGCG CCGCGCCGCT CAGCCCATCA GCAAAGCCAC AAAGCCACCA
    AAATCAACAA CAGCCATAAA CAGCCACAAC AACAGCAACA CCAACAACAA CAACAACAAC
    AGCAGCAACA ACAGCAATGG CGCCTCGCCC ACTCGCCACC GACCGGGCTC ACCGGGCAAA
    CATCTCGCCC AGCGTCACAC AGCAGCGACG GCACAGCGCC AGAGCCACAA TCACGTCTCG
    TCTGCTCCCC AGCAGCTGTC GAAGAGCACC CGCCTCAGCA TTCTCAGTCC GGAGAAGGTG
    CATCGCCTGG GCGCTCGACT CACTGACCAG AAGCAGAAGC TGCGCGAGGA GGCGGCAGCA
    GCAGCAGCTG CAGCGCTAAC GGGCAACAGC AATGGCCACG CCCACGGCCA CGGCCATGGA
    CATGGACACG GTCGAGCGGT GGTTGGTGGA ACGGCGGCGG CGGGCAACAG CGTGAATGTG
    GATCGTCGAC GTCGAGCACC GCCGCCGCCG CCAGTGCGAA CGCACTTTAA TACGCGCTGT
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017964467.1
    CDS881..4783
    Translation

    Target ORF information:

    RefSeq Version XM_018108978.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018108978.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AACAGCAGCA GCAGGAGCAG
    CAACAACAGC AGAAGCAAAC GGTGCAAGCC AATGAGGTGG AGGAGAAGGA GAATGTGGAG
    AACGTCGTAA TGCGCACCCA TGACATACCC AAGTCGCCGC ATTTGGGCAA GGATTTCTCG
    CCGAGTGGCG AACGGCTGCG CGACAGCATG CGGGCGCGTC GCCGGCAGCG TTTCCTGGGC
    GCCCAGCCGC AGCTGCGTGG CTTGACGCCG GAGACGACAT CCACGGAGCG GGCGCTGAAG
    CAGGCGCTGA AGAAATGCCG TCCATTTGGC GAGAAGGGCT ACCTGGTGGA CCTGCGTCCC
    GGTGCGGAGC TGCAGCTGAA CGATGTGCGG GACTTGAATA ACTATTCCGA CGTCGACTCC
    AGCTGCGATA CGAGTCTCAA CTACCACGAG GTGAATGTGA CGCCAACGCC GACACCGACG
    CCGCCGCCGC CGCCAGTGGC GCCAATGGCG CCGCCCACAC CGCCGCCGCT GCCCGCCACG
    CTCGTGCATC AGTTGGCCTT CGAGGATATG CGCACGCGTC TGCATCAGTG CCGCAGCAAG
    TTCGAGCACC TGGAGGAGGC GAATCGCCGC AACTTCAGCC AGTCGCAGCA CTCGATGCGC
    CACTTCTTCA AGACGCCGCC GGTGGCATTG AAAATGTTCC AGCGGCTCGA GCACGAGGCA
    TCGCTGAATG GCAGCAGCAG CAGCAGCAGC TCAACGACAG CTGCAGCCGC AGCAGCAGCG
    AAGCAACGCA GCACTCAGCG CATCAATCAG ACGCCCATCT TTGGGCGGCG CCAGCTGCCG
    GCAGAGCAGC CACGGCTGCA GCACGCCGGC TCCTTCGAGC AGCTGGTGAC GGCAGCGAAG
    CCAGCAACTG TTGCCAAGCG CAGCAAAGCA GCCGAACAGC CGGCCACAGC AGGAGCAGCA
    GCAGGAGTAG CAGGAGCAGC ACCGTCAACA CCAACAGCAG CAGCAGCAAC AACAACAACA
    ACGACAACTG CAGCAACCTC AGCGGATTGC CTGGCCAAGA AGCACAAGCT GACGCTGCCG
    CTCTCAGCCA CTTGGCAGCG CCGCGCCGCT CAGCCCATCA GCAAAGCCAC AAAGCCACCA
    AAATCAACAA CAGCCATAAA CAGCCACAAC AACAGCAACA CCAACAACAA CAACAACAAC
    AGCAGCAACA ACAGCAATGG CGCCTCGCCC ACTCGCCACC GACCGGGCTC ACCGGGCAAA
    CATCTCGCCC AGCGTCACAC AGCAGCGACG GCACAGCGCC AGAGCCACAA TCACGTCTCG
    TCTGCTCCCC AGCAGCTGTC GAAGAGCACC CGCCTCAGCA TTCTCAGTCC GGAGAAGGTG
    CATCGCCTGG GCGCTCGACT CACTGACCAG AAGCAGAAGC TGCGCGAGGA GGCGGCAGCA
    GCAGCAGCTG CAGCGCTAAC GGGCAACAGC AATGGCCACG CCCACGGCCA CGGCCATGGA
    CATGGACACG GTCGAGCGGT GGTTGGTGGA ACGGCGGCGG CGGGCAACAG CGTGAATGTG
    GATCGTCGAC GTCGAGCACC GCCGCCGCCG CCAGTGCGAA CGCACTTTAA TACGCGCTGT
    TAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253057
    Clone ID Related Accession (Same CDS sequence) XM_018108979.1
    Accession Version XM_018108979.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3816bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGAGAT CGATGTGAAT
    CTCACGAATT TGCATATCGG CGATCGGATT CTGGAGGTGA ATGGCACGCC CGTCAGCAAC
    TCGTCTGTGG ATCAGATCGA CAAGCTGATA CGCAGCAATG AGAAGATGCT GCAGCTAACG
    GTGGAGCACG ATCCGGTGCA GGTGTGTCGC AGCTGCAGCC AGGCGGACAT TCAGCGCGCC
    AGCTCCGCCT CGACTCTGAT CCTGCCGCTG AGCACGTCTG CGTCCAGTGT TGAGGTCGGT
    GGGCGTGGCC GTGAGCGACT GTACAAGGCA GCGGCCACCG AGCCCAGCGG CAAGATGCGC
    AAGATGCGAC AGCAAACGTT GCAAACCAGC AAATCAGTGC AGCAAACGAC GGGGCAGCAG
    CAGCAGCAGC AGCAGCAGCA ACATCCAGCG GAGCAACTGT CGTCGCAGCT GAAGGAGAAG
    GAGCGCTGCT CGAGCCTCTC GAAACTGCTG GACGAACAGC ACACGGCACA GCAGCACTCG
    GCGCATCCGC AGCTATACGA TTTGTCGCGC ACGCAGAGCT GTCGCGTCGT CCAGAAGCCG
    CAGCGCATCT TTCGCGCCTC CGATCTGGTG ATGGGCGAGA AGCTGGGCGA GGGCTTCTTT
    GGCAAGGTGT TTAAGGTAAC GCATCGGCTC ACCGGCGAGC TGATGGTCCT CAAGGAGCTG
    CATCGCGCCG ACGAGGAGGC GCAGCGCAAT TTCATCAAGG AGGTAGCCGT GCTGCGGCTG
    CTCGACCATC GGCATGTGCT CAAGTTCATC GGCGTGCTCT ACAAGGACAA GAAGCTGCAC
    ATGGTCACGG AGTATGTGGC CGGCGGCTGC CTCAAGGAGC TGATCCACGA CTCGAGTCGC
    GTGCTCAGCT GGTCGCAGCG CGTCTGCCTG GCCAGAGACA TCGCCTGCGG CATGAGCTAT
    CTGCATTCGA TGAACATCAT CCATCGTGAT CTCAATTCAA TGAATTGTCT CGTGCGCGAG
    GATCAATCGG TGATCGTTGC CGACTTTGGT CTGGCGCGCA GTGTCGATGC ACCGCGCCTG
    CCCGGCGCTG GCGCTGCCAC CGGTGCCGGT GCCGGTGTCG GTGCCGGCTC TGCCGCCAGC
    TCCAATTCGG GCTCCATCGA TGCCAGTGCC ATGTCGCCCA GCGGCACGCT GCGGCGCAGC
    AAGAGCCGAC AGCGCCGGCA GCGCTACACA GTGGTGGGCA ATCCCTATTG GATGGCGCCC
    GAAATGATGA AGGGCCTCAA GTACGATGAG AAAGTCGATG TCTTCTCCTT TGGCATCATG
    CTCTGCGAGA TAATTGGCCG TGTGGAAGCC GATCCGGATT ATATGCCACG CAACTCGGAT
    TTCAGTCTGA ACCAGCAGGA GTTTCGCGAA AAGTTCTGCG CCCAGTGCCC GGAGGCGTTC
    GTCAAGGTGG CCTTTGTCTG CTGTGATCTG AATCCGGATA TGCGTCCATG CTTTGAGACG
    TTGTACGTGT GGCTGGAGCA GCTGCGACAG CACCTGGACG CACAGCAACA GCCGCCGGCG
    CGTCTGCTGC ACGAAATCGA GAACTTTCAG GATAGCTACA TCAGTTCGGA GGATGCGCTG
    TCGCCGACAT CGCAGCGCAG CCTCGACAAT CTAACGATGG CCGAGACAGA CAGACCACAG
    CAGCAGCAGC AGCAACAGCA GCAGCAGGAG CAGCAACAAC AGCAGAAGCA AACGGTGCAA
    GCCAATGAGG TGGAGGAGAA GGAGAATGTG GAGAACGTCG TAATGCGCAC CCATGACATA
    CCCAAGTCGC CGCATTTGGG CAAGGATTTC TCGCCGAGTG GCGAACGGCT GCGCGACAGC
    ATGCGGGCGC GTCGCCGGCA GCGTTTCCTG GGCGCCCAGC CGCAGCTGCG TGGCTTGACG
    CCGGAGACGA CATCCACGGA GCGGGCGCTG AAGCAGGCGC TGAAGAAATG CCGTCCATTT
    GGCGAGAAGG GCTACCTGGT GGACCTGCGT CCCGGTGCGG AGCTGCAGCT GAACGATGTG
    CGGGACTTGA ATAACTATTC CGACGTCGAC TCCAGCTGCG ATACGAGTCT CAACTACCAC
    GAGGTGAATG TGACGCCAAC GCCGACACCG ACGCCGCCGC CGCCGCCAGT GGCGCCAATG
    GCGCCGCCCA CACCGCCGCC GCTGCCCGCC ACGCTCGTGC ATCAGTTGGC CTTCGAGGAT
    ATGCGCACGC GTCTGCATCA GTGCCGCAGC AAGTTCGAGC ACCTGGAGGA GGCGAATCGC
    CGCAACTTCA GCCAGTCGCA GCACTCGATG CGCCACTTCT TCAAGACGCC GCCGGTGGCA
    TTGAAAATGT TCCAGCGGCT CGAGCACGAG GCATCGCTGA ATGGCAGCAG CAGCAGCAGC
    AGCTCAACGA CAGCTGCAGC CGCAGCAGCA GCGAAGCAAC GCAGCACTCA GCGCATCAAT
    CAGACGCCCA TCTTTGGGCG GCGCCAGCTG CCGGCAGAGC AGCCACGGCT GCAGCACGCC
    GGCTCCTTCG AGCAGCTGGT GACGGCAGCG AAGCCAGCAA CTGTTGCCAA GCGCAGCAAA
    GCAGCCGAAC AGCCGGCCAC AGCAGGAGCA GCAGCAGGAG TAGCAGGAGC AGCACCGTCA
    ACACCAACAG CAGCAGCAGC AACAACAACA ACAACGACAA CTGCAGCAAC CTCAGCGGAT
    TGCCTGGCCA AGAAGCACAA GCTGACGCTG CCGCTCTCAG CCACTTGGCA GCGCCGCGCC
    GCTCAGCCCA TCAGCAAAGC CACAAAGCCA CCAAAATCAA CAACAGCCAT AAACAGCCAC
    AACAACAGCA ACACCAACAA CAACAACAAC AACAGCAGCA ACAACAGCAA TGGCGCCTCG
    CCCACTCGCC ACCGACCGGG CTCACCGGGC AAACATCTCG CCCAGCGTCA CACAGCAGCG
    ACGGCACAGC GCCAGAGCCA CAATCACGTC TCGTCTGCTC CCCAGCAGCT GTCGAAGAGC
    ACCCGCCTCA GCATTCTCAG TCCGGAGAAG GTGCATCGCC TGGGCGCTCG ACTCACTGAC
    CAGAAGCAGA AGCTGCGCGA GGAGGCGGCA GCAGCAGCAG CTGCAGCGCT AACGGGCAAC
    AGCAATGGCC ACGCCCACGG CCACGGCCAT GGACATGGAC ACGGTCGAGC GGTGGTTGGT
    GGAACGGCGG CGGCGGGCAA CAGCGTGAAT GTGGATCGTC GACGTCGAGC ACCGCCGCCG
    CCGCCAGTGC GAACGCACTT TAATACGCGC TGTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017964468.1
    CDS880..4695
    Translation

    Target ORF information:

    RefSeq Version XM_018108979.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018108979.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGAGAT CGATGTGAAT
    CTCACGAATT TGCATATCGG CGATCGGATT CTGGAGGTGA ATGGCACGCC CGTCAGCAAC
    TCGTCTGTGG ATCAGATCGA CAAGCTGATA CGCAGCAATG AGAAGATGCT GCAGCTAACG
    GTGGAGCACG ATCCGGTGCA GGTGTGTCGC AGCTGCAGCC AGGCGGACAT TCAGCGCGCC
    AGCTCCGCCT CGACTCTGAT CCTGCCGCTG AGCACGTCTG CGTCCAGTGT TGAGGTCGGT
    GGGCGTGGCC GTGAGCGACT GTACAAGGCA GCGGCCACCG AGCCCAGCGG CAAGATGCGC
    AAGATGCGAC AGCAAACGTT GCAAACCAGC AAATCAGTGC AGCAAACGAC GGGGCAGCAG
    CAGCAGCAGC AGCAGCAGCA ACATCCAGCG GAGCAACTGT CGTCGCAGCT GAAGGAGAAG
    GAGCGCTGCT CGAGCCTCTC GAAACTGCTG GACGAACAGC ACACGGCACA GCAGCACTCG
    GCGCATCCGC AGCTATACGA TTTGTCGCGC ACGCAGAGCT GTCGCGTCGT CCAGAAGCCG
    CAGCGCATCT TTCGCGCCTC CGATCTGGTG ATGGGCGAGA AGCTGGGCGA GGGCTTCTTT
    GGCAAGGTGT TTAAGGTAAC GCATCGGCTC ACCGGCGAGC TGATGGTCCT CAAGGAGCTG
    CATCGCGCCG ACGAGGAGGC GCAGCGCAAT TTCATCAAGG AGGTAGCCGT GCTGCGGCTG
    CTCGACCATC GGCATGTGCT CAAGTTCATC GGCGTGCTCT ACAAGGACAA GAAGCTGCAC
    ATGGTCACGG AGTATGTGGC CGGCGGCTGC CTCAAGGAGC TGATCCACGA CTCGAGTCGC
    GTGCTCAGCT GGTCGCAGCG CGTCTGCCTG GCCAGAGACA TCGCCTGCGG CATGAGCTAT
    CTGCATTCGA TGAACATCAT CCATCGTGAT CTCAATTCAA TGAATTGTCT CGTGCGCGAG
    GATCAATCGG TGATCGTTGC CGACTTTGGT CTGGCGCGCA GTGTCGATGC ACCGCGCCTG
    CCCGGCGCTG GCGCTGCCAC CGGTGCCGGT GCCGGTGTCG GTGCCGGCTC TGCCGCCAGC
    TCCAATTCGG GCTCCATCGA TGCCAGTGCC ATGTCGCCCA GCGGCACGCT GCGGCGCAGC
    AAGAGCCGAC AGCGCCGGCA GCGCTACACA GTGGTGGGCA ATCCCTATTG GATGGCGCCC
    GAAATGATGA AGGGCCTCAA GTACGATGAG AAAGTCGATG TCTTCTCCTT TGGCATCATG
    CTCTGCGAGA TAATTGGCCG TGTGGAAGCC GATCCGGATT ATATGCCACG CAACTCGGAT
    TTCAGTCTGA ACCAGCAGGA GTTTCGCGAA AAGTTCTGCG CCCAGTGCCC GGAGGCGTTC
    GTCAAGGTGG CCTTTGTCTG CTGTGATCTG AATCCGGATA TGCGTCCATG CTTTGAGACG
    TTGTACGTGT GGCTGGAGCA GCTGCGACAG CACCTGGACG CACAGCAACA GCCGCCGGCG
    CGTCTGCTGC ACGAAATCGA GAACTTTCAG GATAGCTACA TCAGTTCGGA GGATGCGCTG
    TCGCCGACAT CGCAGCGCAG CCTCGACAAT CTAACGATGG CCGAGACAGA CAGACCACAG
    CAGCAGCAGC AGCAACAGCA GCAGCAGGAG CAGCAACAAC AGCAGAAGCA AACGGTGCAA
    GCCAATGAGG TGGAGGAGAA GGAGAATGTG GAGAACGTCG TAATGCGCAC CCATGACATA
    CCCAAGTCGC CGCATTTGGG CAAGGATTTC TCGCCGAGTG GCGAACGGCT GCGCGACAGC
    ATGCGGGCGC GTCGCCGGCA GCGTTTCCTG GGCGCCCAGC CGCAGCTGCG TGGCTTGACG
    CCGGAGACGA CATCCACGGA GCGGGCGCTG AAGCAGGCGC TGAAGAAATG CCGTCCATTT
    GGCGAGAAGG GCTACCTGGT GGACCTGCGT CCCGGTGCGG AGCTGCAGCT GAACGATGTG
    CGGGACTTGA ATAACTATTC CGACGTCGAC TCCAGCTGCG ATACGAGTCT CAACTACCAC
    GAGGTGAATG TGACGCCAAC GCCGACACCG ACGCCGCCGC CGCCGCCAGT GGCGCCAATG
    GCGCCGCCCA CACCGCCGCC GCTGCCCGCC ACGCTCGTGC ATCAGTTGGC CTTCGAGGAT
    ATGCGCACGC GTCTGCATCA GTGCCGCAGC AAGTTCGAGC ACCTGGAGGA GGCGAATCGC
    CGCAACTTCA GCCAGTCGCA GCACTCGATG CGCCACTTCT TCAAGACGCC GCCGGTGGCA
    TTGAAAATGT TCCAGCGGCT CGAGCACGAG GCATCGCTGA ATGGCAGCAG CAGCAGCAGC
    AGCTCAACGA CAGCTGCAGC CGCAGCAGCA GCGAAGCAAC GCAGCACTCA GCGCATCAAT
    CAGACGCCCA TCTTTGGGCG GCGCCAGCTG CCGGCAGAGC AGCCACGGCT GCAGCACGCC
    GGCTCCTTCG AGCAGCTGGT GACGGCAGCG AAGCCAGCAA CTGTTGCCAA GCGCAGCAAA
    GCAGCCGAAC AGCCGGCCAC AGCAGGAGCA GCAGCAGGAG TAGCAGGAGC AGCACCGTCA
    ACACCAACAG CAGCAGCAGC AACAACAACA ACAACGACAA CTGCAGCAAC CTCAGCGGAT
    TGCCTGGCCA AGAAGCACAA GCTGACGCTG CCGCTCTCAG CCACTTGGCA GCGCCGCGCC
    GCTCAGCCCA TCAGCAAAGC CACAAAGCCA CCAAAATCAA CAACAGCCAT AAACAGCCAC
    AACAACAGCA ACACCAACAA CAACAACAAC AACAGCAGCA ACAACAGCAA TGGCGCCTCG
    CCCACTCGCC ACCGACCGGG CTCACCGGGC AAACATCTCG CCCAGCGTCA CACAGCAGCG
    ACGGCACAGC GCCAGAGCCA CAATCACGTC TCGTCTGCTC CCCAGCAGCT GTCGAAGAGC
    ACCCGCCTCA GCATTCTCAG TCCGGAGAAG GTGCATCGCC TGGGCGCTCG ACTCACTGAC
    CAGAAGCAGA AGCTGCGCGA GGAGGCGGCA GCAGCAGCAG CTGCAGCGCT AACGGGCAAC
    AGCAATGGCC ACGCCCACGG CCACGGCCAT GGACATGGAC ACGGTCGAGC GGTGGTTGGT
    GGAACGGCGG CGGCGGGCAA CAGCGTGAAT GTGGATCGTC GACGTCGAGC ACCGCCGCCG
    CCGCCAGTGC GAACGCACTT TAATACGCGC TGTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253058
    Clone ID Related Accession (Same CDS sequence) XM_018108980.1
    Accession Version XM_018108980.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3231bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGATCGATG TGAATCTCAC GAATTTGCAT ATCGGCGATC GGATTCTGGA GGTGAATGGC 
    ACGCCCGTCA GCAACTCGTC TGTGGATCAG ATCGACAAGC TGATACGCAG CAATGAGAAG
    ATGCTGCAGC TAACGGTGGA GCACGATCCG GTGCAGGTGT GTCGCAGCTG CAGCCAGGCG
    GACATTCAGC GCGCCAGCTC CGCCTCGACT CTGATCCTGC CGCTGAGCAC GTCTGCGTCC
    AGTGTTGAGG TCGGTGGGCG TGGCCGTGAG CGACTGTACA AGGCAGCGGC CACCGAGCCC
    AGCGGCAAGA TGCGCAAGAT GCGACAGCAA ACGTTGCAAA CCAGCAAATC AGTGCAGCAA
    ACGACGGGGC AGCAGCAGCA GCAGCAGCAG CAGCAACATC CAGCGGAGCA ACTGTCGTCG
    CAGCTGAAGG AGAAGGAGCG CTGCTCGAGC CTCTCGAAAC TGCTGGACGA ACAGCACACG
    GCACAGCAGC ACTCGGCGCA TCCGCAGCTA TACGATTTGT CGCGCACGCA GAGCTGTCGC
    GTCGTCCAGA AGCCGCAGCG CATCTTTCGC GCCTCCGATC TGGTGATGGG CGAGAAGCTG
    GGCGAGGGCT TCTTTGGCAA GGTGTTTAAG GTAACGCATC GGCTCACCGG CGAGCTGATG
    GTCCTCAAGG AGCTGCATCG CGCCGACGAG GAGGCGCAGC GCAATTTCAT CAAGGAGGTA
    GCCGTGCTGC GGCTGCTCGA CCATCGGCAT GTGCTCAAGT TCATCGGCGT GCTCTACAAG
    GACAAGAAGC TGCACATGGT CACGGAGTAT GTGGCCGGCG GCTGCCTCAA GGAGCTGATC
    CACGACTCGA GTCGCGTGCT CAGCTGGTCG CAGCGCGTCT GCCTGGCCAG AGACATCGCC
    TGCGGCATGA GCTATCTGCA TTCGATGAAC ATCATCCATC GTGATCTCAA TTCAATGAAT
    TGTCTCGTGC GCGAGGATCA ATCGGTGATC GTTGCCGACT TTGGTCTGGC GCGCAGTGTC
    GATGCACCGC GCCTGCCCGG CGCTGGCGCT GCCACCGGTG CCGGTGCCGG TGTCGGTGCC
    GGCTCTGCCG CCAGCTCCAA TTCGGGCTCC ATCGATGCCA GTGCCATGTC GCCCAGCGGC
    ACGCTGCGGC GCAGCAAGAG CCGACAGCGC CGGCAGCGCT ACACAGTGGT GGGCAATCCC
    TATTGGATGG CGCCCGAAAT GATGAAGGGC CTCAAGTACG ATGAGAAAGT CGATGTCTTC
    TCCTTTGGCA TCATGCTCTG CGAGATAATT GGCCGTGTGG AAGCCGATCC GGATTATATG
    CCACGCAACT CGGATTTCAG TCTGAACCAG CAGGAGTTTC GCGAAAAGTT CTGCGCCCAG
    TGCCCGGAGG CGTTCGTCAA GGTGGCCTTT GTCTGCTGTG ATCTGAATCC GGATATGCGT
    CCATGCTTTG AGACGTTGTA CGTGTGGCTG GAGCAGCTGC GACAGCACCT GGACGCACAG
    CAACAGCCGC CGGCGCGTCT GCTGCACGAA ATCGAGAACT TTCAGGATAG CTACATCAGT
    TCGGAGGATG CGCTGTCGCC GACATCGCAG CGCAGCCTCG ACAATCTAAC GATGGCCGAG
    ACAGACAGAC CACAGCAGCA GCAGCAGCAA CAGCAGCAGC AGGAGCAGCA ACAACAGCAG
    AAGCAAACGG TGCAAGCCAA TGAGGTGGAG GAGAAGGAGA ATGTGGAGAA CGTCGTAATG
    CGCACCCATG ACATACCCAA GTCGCCGCAT TTGGGCAAGG ATTTCTCGCC GAGTGGCGAA
    CGGCTGCGCG ACAGCATGCG GGCGCGTCGC CGGCAGCGTT TCCTGGGCGC CCAGCCGCAG
    CTGCGTGGCT TGACGCCGGA GACGACATCC ACGGAGCGGG CGCTGAAGCA GGCGCTGAAG
    AAATGCCGTC CATTTGGCGA GAAGGGCTAC CTGGTGGACC TGCGTCCCGG TGCGGAGCTG
    CAGCTGAACG ATGTGCGGGA CTTGAATAAC TATTCCGACG TCGACTCCAG CTGCGATACG
    AGTCTCAACT ACCACGAGGT GAATGTGACG CCAACGCCGA CACCGACGCC GCCGCCGCCG
    CCAGTGGCGC CAATGGCGCC GCCCACACCG CCGCCGCTGC CCGCCACGCT CGTGCATCAG
    TTGGCCTTCG AGGATATGCG CACGCGTCTG CATCAGTGCC GCAGCAAGTT CGAGCACCTG
    GAGGAGGCGA ATCGCCGCAA CTTCAGCCAG TCGCAGCACT CGATGCGCCA CTTCTTCAAG
    ACGCCGCCGG TGGCATTGAA AATGTTCCAG CGGCTCGAGC ACGAGGCATC GCTGAATGGC
    AGCAGCAGCA GCAGCAGCTC AACGACAGCT GCAGCCGCAG CAGCAGCGAA GCAACGCAGC
    ACTCAGCGCA TCAATCAGAC GCCCATCTTT GGGCGGCGCC AGCTGCCGGC AGAGCAGCCA
    CGGCTGCAGC ACGCCGGCTC CTTCGAGCAG CTGGTGACGG CAGCGAAGCC AGCAACTGTT
    GCCAAGCGCA GCAAAGCAGC CGAACAGCCG GCCACAGCAG GAGCAGCAGC AGGAGTAGCA
    GGAGCAGCAC CGTCAACACC AACAGCAGCA GCAGCAACAA CAACAACAAC GACAACTGCA
    GCAACCTCAG CGGATTGCCT GGCCAAGAAG CACAAGCTGA CGCTGCCGCT CTCAGCCACT
    TGGCAGCGCC GCGCCGCTCA GCCCATCAGC AAAGCCACAA AGCCACCAAA ATCAACAACA
    GCCATAAACA GCCACAACAA CAGCAACACC AACAACAACA ACAACAACAG CAGCAACAAC
    AGCAATGGCG CCTCGCCCAC TCGCCACCGA CCGGGCTCAC CGGGCAAACA TCTCGCCCAG
    CGTCACACAG CAGCGACGGC ACAGCGCCAG AGCCACAATC ACGTCTCGTC TGCTCCCCAG
    CAGCTGTCGA AGAGCACCCG CCTCAGCATT CTCAGTCCGG AGAAGGTGCA TCGCCTGGGC
    GCTCGACTCA CTGACCAGAA GCAGAAGCTG CGCGAGGAGG CGGCAGCAGC AGCAGCTGCA
    GCGCTAACGG GCAACAGCAA TGGCCACGCC CACGGCCACG GCCATGGACA TGGACACGGT
    CGAGCGGTGG TTGGTGGAAC GGCGGCGGCG GGCAACAGCG TGAATGTGGA TCGTCGACGT
    CGAGCACCGC CGCCGCCGCC AGTGCGAACG CACTTTAATA CGCGCTGTTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017964469.1
    CDS311..3541
    Translation

    Target ORF information:

    RefSeq Version XM_018108980.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018108980.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    ATGATCGATG TGAATCTCAC GAATTTGCAT ATCGGCGATC GGATTCTGGA GGTGAATGGC 
    ACGCCCGTCA GCAACTCGTC TGTGGATCAG ATCGACAAGC TGATACGCAG CAATGAGAAG
    ATGCTGCAGC TAACGGTGGA GCACGATCCG GTGCAGGTGT GTCGCAGCTG CAGCCAGGCG
    GACATTCAGC GCGCCAGCTC CGCCTCGACT CTGATCCTGC CGCTGAGCAC GTCTGCGTCC
    AGTGTTGAGG TCGGTGGGCG TGGCCGTGAG CGACTGTACA AGGCAGCGGC CACCGAGCCC
    AGCGGCAAGA TGCGCAAGAT GCGACAGCAA ACGTTGCAAA CCAGCAAATC AGTGCAGCAA
    ACGACGGGGC AGCAGCAGCA GCAGCAGCAG CAGCAACATC CAGCGGAGCA ACTGTCGTCG
    CAGCTGAAGG AGAAGGAGCG CTGCTCGAGC CTCTCGAAAC TGCTGGACGA ACAGCACACG
    GCACAGCAGC ACTCGGCGCA TCCGCAGCTA TACGATTTGT CGCGCACGCA GAGCTGTCGC
    GTCGTCCAGA AGCCGCAGCG CATCTTTCGC GCCTCCGATC TGGTGATGGG CGAGAAGCTG
    GGCGAGGGCT TCTTTGGCAA GGTGTTTAAG GTAACGCATC GGCTCACCGG CGAGCTGATG
    GTCCTCAAGG AGCTGCATCG CGCCGACGAG GAGGCGCAGC GCAATTTCAT CAAGGAGGTA
    GCCGTGCTGC GGCTGCTCGA CCATCGGCAT GTGCTCAAGT TCATCGGCGT GCTCTACAAG
    GACAAGAAGC TGCACATGGT CACGGAGTAT GTGGCCGGCG GCTGCCTCAA GGAGCTGATC
    CACGACTCGA GTCGCGTGCT CAGCTGGTCG CAGCGCGTCT GCCTGGCCAG AGACATCGCC
    TGCGGCATGA GCTATCTGCA TTCGATGAAC ATCATCCATC GTGATCTCAA TTCAATGAAT
    TGTCTCGTGC GCGAGGATCA ATCGGTGATC GTTGCCGACT TTGGTCTGGC GCGCAGTGTC
    GATGCACCGC GCCTGCCCGG CGCTGGCGCT GCCACCGGTG CCGGTGCCGG TGTCGGTGCC
    GGCTCTGCCG CCAGCTCCAA TTCGGGCTCC ATCGATGCCA GTGCCATGTC GCCCAGCGGC
    ACGCTGCGGC GCAGCAAGAG CCGACAGCGC CGGCAGCGCT ACACAGTGGT GGGCAATCCC
    TATTGGATGG CGCCCGAAAT GATGAAGGGC CTCAAGTACG ATGAGAAAGT CGATGTCTTC
    TCCTTTGGCA TCATGCTCTG CGAGATAATT GGCCGTGTGG AAGCCGATCC GGATTATATG
    CCACGCAACT CGGATTTCAG TCTGAACCAG CAGGAGTTTC GCGAAAAGTT CTGCGCCCAG
    TGCCCGGAGG CGTTCGTCAA GGTGGCCTTT GTCTGCTGTG ATCTGAATCC GGATATGCGT
    CCATGCTTTG AGACGTTGTA CGTGTGGCTG GAGCAGCTGC GACAGCACCT GGACGCACAG
    CAACAGCCGC CGGCGCGTCT GCTGCACGAA ATCGAGAACT TTCAGGATAG CTACATCAGT
    TCGGAGGATG CGCTGTCGCC GACATCGCAG CGCAGCCTCG ACAATCTAAC GATGGCCGAG
    ACAGACAGAC CACAGCAGCA GCAGCAGCAA CAGCAGCAGC AGGAGCAGCA ACAACAGCAG
    AAGCAAACGG TGCAAGCCAA TGAGGTGGAG GAGAAGGAGA ATGTGGAGAA CGTCGTAATG
    CGCACCCATG ACATACCCAA GTCGCCGCAT TTGGGCAAGG ATTTCTCGCC GAGTGGCGAA
    CGGCTGCGCG ACAGCATGCG GGCGCGTCGC CGGCAGCGTT TCCTGGGCGC CCAGCCGCAG
    CTGCGTGGCT TGACGCCGGA GACGACATCC ACGGAGCGGG CGCTGAAGCA GGCGCTGAAG
    AAATGCCGTC CATTTGGCGA GAAGGGCTAC CTGGTGGACC TGCGTCCCGG TGCGGAGCTG
    CAGCTGAACG ATGTGCGGGA CTTGAATAAC TATTCCGACG TCGACTCCAG CTGCGATACG
    AGTCTCAACT ACCACGAGGT GAATGTGACG CCAACGCCGA CACCGACGCC GCCGCCGCCG
    CCAGTGGCGC CAATGGCGCC GCCCACACCG CCGCCGCTGC CCGCCACGCT CGTGCATCAG
    TTGGCCTTCG AGGATATGCG CACGCGTCTG CATCAGTGCC GCAGCAAGTT CGAGCACCTG
    GAGGAGGCGA ATCGCCGCAA CTTCAGCCAG TCGCAGCACT CGATGCGCCA CTTCTTCAAG
    ACGCCGCCGG TGGCATTGAA AATGTTCCAG CGGCTCGAGC ACGAGGCATC GCTGAATGGC
    AGCAGCAGCA GCAGCAGCTC AACGACAGCT GCAGCCGCAG CAGCAGCGAA GCAACGCAGC
    ACTCAGCGCA TCAATCAGAC GCCCATCTTT GGGCGGCGCC AGCTGCCGGC AGAGCAGCCA
    CGGCTGCAGC ACGCCGGCTC CTTCGAGCAG CTGGTGACGG CAGCGAAGCC AGCAACTGTT
    GCCAAGCGCA GCAAAGCAGC CGAACAGCCG GCCACAGCAG GAGCAGCAGC AGGAGTAGCA
    GGAGCAGCAC CGTCAACACC AACAGCAGCA GCAGCAACAA CAACAACAAC GACAACTGCA
    GCAACCTCAG CGGATTGCCT GGCCAAGAAG CACAAGCTGA CGCTGCCGCT CTCAGCCACT
    TGGCAGCGCC GCGCCGCTCA GCCCATCAGC AAAGCCACAA AGCCACCAAA ATCAACAACA
    GCCATAAACA GCCACAACAA CAGCAACACC AACAACAACA ACAACAACAG CAGCAACAAC
    AGCAATGGCG CCTCGCCCAC TCGCCACCGA CCGGGCTCAC CGGGCAAACA TCTCGCCCAG
    CGTCACACAG CAGCGACGGC ACAGCGCCAG AGCCACAATC ACGTCTCGTC TGCTCCCCAG
    CAGCTGTCGA AGAGCACCCG CCTCAGCATT CTCAGTCCGG AGAAGGTGCA TCGCCTGGGC
    GCTCGACTCA CTGACCAGAA GCAGAAGCTG CGCGAGGAGG CGGCAGCAGC AGCAGCTGCA
    GCGCTAACGG GCAACAGCAA TGGCCACGCC CACGGCCACG GCCATGGACA TGGACACGGT
    CGAGCGGTGG TTGGTGGAAC GGCGGCGGCG GGCAACAGCG TGAATGTGGA TCGTCGACGT
    CGAGCACCGC CGCCGCCGCC AGTGCGAACG CACTTTAATA CGCGCTGTTA A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr253059
    Clone ID Related Accession (Same CDS sequence) XM_018108981.1
    Accession Version XM_018108981.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2391bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product LIM domain kinase 1 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181433.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AACAGCAGCA GCAGGAGCAG
    CAACAACTGC AGCAACCTCA GCGGATTGCC TGGCCAAGAA GCACAAGCTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017964470.1
    CDS1..2391
    Translation

    Target ORF information:

    RefSeq Version XM_018108981.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa LIM domain kinase 1 (LOC108656733), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018108981.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    ATGCATCAAC AAAAAGAACA AGCACAACAA CAGCGCACAG CAGTGGCGGC GTCAGCGGCG 
    GCTGCGCTGC CAGCTTGCGC CAGTTGCCTC TGCCCGCTGA TCGCCAACAA TCACAACGAT
    GAGCCGATAG TGATGGCACT CGGCCAGCAA TGGCACTGCG ATTGTTTTCG CTGCTCCGTT
    TGCGACTCCC ACTTGCATAG CTGGTACTTT GAGCGTGAGA ACTTGCTCTA TTGCCGCGAG
    GATTATTATG CCCGTTTCGG CGATGCCTGT CAGCAGTGTA CGGCGGTTAT AACGGGGCCC
    GTAATGGTTG CCGGCGAGCA TAAATTTCAT CCGGAATGCT TCTGCTGTGC CGCCTGCGGC
    TCATTCATTG GCGAGGGCGA ATCGTACGCC TTGGTCGAAC GCTCCAAGCT CTATTGCGGC
    CTGTGCTATG GCAAATGCCT ACCCCTCGAT GCTCGTGCAC GTATCACAAA TGCGGGCAAG
    CCAATGCACT CCATACGCCT GGTGGAGATA CCCAAGGATG CGACGCCCGG CCTGCGTGTG
    GACGGTGGAG CCTTGGACGA TGGTTGTCCC ACAGTGCGGA TAACCGACTT AATTTGTAAA
    TTTTACGGTC GCATGGGCAA ATACGCCTTC TCCCTGCTCA CCTCGGTGGC GGATCGTTGT
    TGTGCTTCAT ATATGATCGA TGTGAATCTC ACGAATTTGC ATATCGGCGA TCGGATTCTG
    GAGGTGAATG GCACGCCCGT CAGCAACTCG TCTGTGGATC AGATCGACAA GCTGATACGC
    AGCAATGAGA AGATGCTGCA GCTAACGGTG GAGCACGATC CGGTGCAGGT GTGTCGCAGC
    TGCAGCCAGG CGGACATTCA GCGCGCCAGC TCCGCCTCGA CTCTGATCCT GCCGCTGAGC
    ACGTCTGCGT CCAGTGTTGA GGTCGGTGGG CGTGGCCGTG AGCGACTGTA CAAGGCAGCG
    GCCACCGAGC CCAGCGGCAA GATGCGCAAG ATGCGACAGC AAACGTTGCA AACCAGCAAA
    TCAGTGCAGC AAACGACGGG GCAGCAGCAG CAGCAGCAGC AGCAGCAACA TCCAGCGGAG
    CAACTGTCGT CGCAGCTGAA GGAGAAGGAG CGCTGCTCGA GCCTCTCGAA ACTGCTGGAC
    GAACAGCACA CGGCACAGCA GCACTCGGCG CATCCGCAGC TATACGATTT GTCGCGCACG
    CAGAGCTGTC GCGTCGTCCA GAAGCCGCAG CGCATCTTTC GCGCCTCCGA TCTGGTGATG
    GGCGAGAAGC TGGGCGAGGG CTTCTTTGGC AAGGTGTTTA AGGTAACGCA TCGGCTCACC
    GGCGAGCTGA TGGTCCTCAA GGAGCTGCAT CGCGCCGACG AGGAGGCGCA GCGCAATTTC
    ATCAAGGAGG TAGCCGTGCT GCGGCTGCTC GACCATCGGC ATGTGCTCAA GTTCATCGGC
    GTGCTCTACA AGGACAAGAA GCTGCACATG GTCACGGAGT ATGTGGCCGG CGGCTGCCTC
    AAGGAGCTGA TCCACGACTC GAGTCGCGTG CTCAGCTGGT CGCAGCGCGT CTGCCTGGCC
    AGAGACATCG CCTGCGGCAT GAGCTATCTG CATTCGATGA ACATCATCCA TCGTGATCTC
    AATTCAATGA ATTGTCTCGT GCGCGAGGAT CAATCGGTGA TCGTTGCCGA CTTTGGTCTG
    GCGCGCAGTG TCGATGCACC GCGCCTGCCC GGCGCTGGCG CTGCCACCGG TGCCGGTGCC
    GGTGTCGGTG CCGGCTCTGC CGCCAGCTCC AATTCGGGCT CCATCGATGC CAGTGCCATG
    TCGCCCAGCG GCACGCTGCG GCGCAGCAAG AGCCGACAGC GCCGGCAGCG CTACACAGTG
    GTGGGCAATC CCTATTGGAT GGCGCCCGAA ATGATGAAGG GCCTCAAGTA CGATGAGAAA
    GTCGATGTCT TCTCCTTTGG CATCATGCTC TGCGAGATAA TTGGCCGTGT GGAAGCCGAT
    CCGGATTATA TGCCACGCAA CTCGGATTTC AGTCTGAACC AGCAGGAGTT TCGCGAAAAG
    TTCTGCGCCC AGTGCCCGGA GGCGTTCGTC AAGGTGGCCT TTGTCTGCTG TGATCTGAAT
    CCGGATATGC GTCCATGCTT TGAGACGTTG TACGTGTGGC TGGAGCAGCT GCGACAGCAC
    CTGGACGCAC AGCAACAGCC GCCGGCGCGT CTGCTGCACG AAATCGAGAA CTTTCAGGAT
    AGCTACATCA GTTCGGAGGA TGCGCTGTCG CCGACATCGC AGCGCAGCCT CGACAATCTA
    ACGATGGCCG AGACAGACAG ACCACAGCAG CAGCAGCAGC AACAGCAGCA GCAGGAGCAG
    CAACAACTGC AGCAACCTCA GCGGATTGCC TGGCCAAGAA GCACAAGCTG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.