LOC105626157 cDNA ORF clone, Atta cephalotes

The following LOC105626157 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105626157 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAt111650 XM_012207469.1
Latest version!
Atta cephalotes hemicentin-1 (LOC105626157), mRNA. pcDNA3.1-C-(k)DYK or customized vector 24-26 $1021.30
$1459.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAt111650
    Clone ID Related Accession (Same CDS sequence) XM_012207469.1
    Accession Version XM_012207469.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 5049bp)
    Protein sequence
    SNP
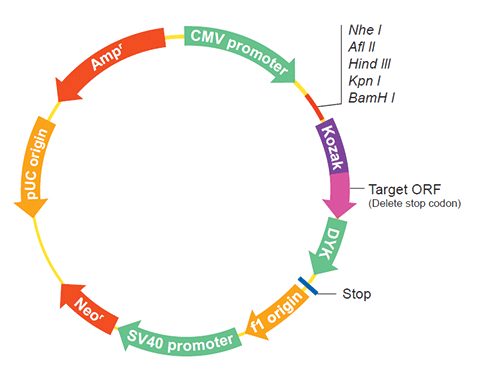
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-04-01
    Organism Atta cephalotes
    Product hemicentin-1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_012130068.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Atta cephalotes Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 10% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    5041
    ATGTTTGTTT CAGGGAGCGA AGCGTGGTTG AAAACTGTGA AGTTTGCTGA GCTCGGAACA 
    GAGATTTTAC TGCCCTGCGT CCTGAAATCA CCACAGTGTG ACGGTCTGCA CAGCATCAAG
    TGGTACCACG GATCCACGAG GATTTTCATT TTCAGTGAGG ATGCCGGGGT TATACGTGGC
    AATAACGACA TTGCTGCTAG GGCGGATATA GAGTATTCGT CGAATTCATC AAGATCGTAT
    TTGAAGCTAT CCGAAATTCA ACTAAACAAC GAGGGTCTAT ACAAGTGTGA GGCTACATAT
    ATGGCGGTCA ACCGCGAGTG CAACAACGTG CAGCACGTTC TTCTTAACGT CACAGTGCAA
    CCAGCGTTTG TACGTGTCAT CGATGAAAAT TCCAAAAATA CTTTGAGCAC TGGCGCCACT
    TTAGGACCTA TAAATGAGGG CTCGACAATA TCATTGTACT GCGAAAGTGG AGAAGGCAAA
    CCTGTACCTA CGGTTGAGTG GTTTAAAGAT GACGAGCTAC TCGAAGCAAC GAACTCGAGG
    ACTGTCACCG ATACCGGAAT TGGTACTGGC AGTAGTTTAC TGGAGATGCA AATTACACGA
    GAAGAGTTAG GCGCAACATT CACGTGTAAA GTCAACAATA TTGCACTCGT GGAACCACTA
    ACAGTTGACA TTAACTTAGA CATACATGTG CGTCCGCTGA AAATGGATTT GGAGGGAGTG
    GTCGGTCACG TCGTGCAGGG TACGAAAATT TTATTACAAT GTAAGGTACA GGCCGCACGA
    CCCGCTGCTA ATATAACATG GAAAAATGGA ACGCACTTTT TAAGTGAGAG CAATGAGAGA
    TTTGAAATGT TCGAAACAAA AATACAGGAA AATGAGGATG GTACATTCGA GACGATAAGT
    TATCTCGCAT TTACAGCCTC GGTATATGAC AACGGCAAGA CGTTTAAGTG TTACGCCGAA
    AATTCGGTTA CTCGTACCGA AGATCTAAAA CCAATGAAGG AAGCAACAAC GATTGAAGTG
    TTATATCCGC CAATAATTAA AATGAAGCCA AACAACATAA CTGTTAACGA GACAGACGAC
    TTTTTAATAT TCTGCGATTA TGAGGCAAAT CCGGCTACGC TACTAAAGGT GACGTGGTTA
    CGAGACGACG ATGAATTAGT GTTAAACGAA GAACATTACG ATGGTGGAAT CACGGAACAA
    ACAGCACTCA CAGTGAAAAA CGCGACTCCT AGCGACATGG GTTCTTACAA ATGCATCCTG
    GAAAACAACG CCGGTCCAAC CATTTCCGAG GCTACTGTAC AAGTTTCAGT CTTTTATAAG
    CCGGTGGTGG AAGTGATAAT GGATCCGGAA ACACCTGTGA ATGAGGCGGA TCGTCAGAAT
    GTTTCGCTAA CGTGCGAGGT CGACGCCGGT AATCCGGCGA TACTGACAGC CGTCCGTTGG
    TATTTGGACG GAGACCTATT GAAAGAACTT CCGGATTGCT CGAGGAATAG CACCGCCATG
    ATGAGCTCCG AGGAATCATT GGCATTCTGT GACATCGACC CCAGCAAATT GCTGCTGGAA
    TCTGTCGGCC GCACCTTCCA CGGCAACTAT TCCTGCGAAG GGAAAAACGA TGCTGGTTGG
    GGACCGAACT CCCCGAGCAC GTCTGTCATA GTTTATTATA AGCCCGGCCC GGCGTCGATA
    ACATACGAAC CTCGGCAAGT GGTGAAGAAA CAAGCATTAT CCATCACTTG CTTCGTTTTG
    GATCCCGGTC GACCGAGGGT GTTAGGCTTC AAGTGGCTGC GCGGCTGGCA CCGACTTCCA
    GACGAGAACG AAGCCACACT CTTCATCGAG TCAGTTAATT TGGAAACCGA GGCGAATTTC
    ACATGTCTGG CTTACAACGA AGCTGGTGAT GGAGAACCAG CCACAACGTT TATCGACGTA
    TCTGTGGCCC CGACATTTAT TAAGAAACTC CATTCGTATC GCGGCTACGT CTATAACGCG
    CCTAACGTGA GCATCATGTG TTGGGTCGAA TGCGCTCCGA TCTGCACTAT TTCCTGGCTG
    AGAGATGACA TTCCCATGAA CTTCACGAAA ACGAATCGAT ACTACGTGTC GAACGTTTAT
    CATCCGCCTG ACCCAAGGAC CGACGACTTC GAGAGCATCC AATCGACTCT CATATGGAAT
    CTGACGGTCT GGCCGAACGG TCAGCTCGAC CGTGCTGAGG ATAACGTCAA ATTTACCTGC
    AAGAGCAGCA GCAACGGAAT CGGTCCGGGC GTGGAGAGTT TTACCCATTT TCATGTCGAG
    TTTCCCCCAG AGGATATTAC AATATCAAAG AAGATAATCA ATGTGATAGT GGATACGGTA
    CCAGAAACCG TTGAGTGCAA TGCGAAAGCG CGACCAAAAC CAAACTTCCG GTGGTATCGC
    GAAGGATCCA CTGATATCAT TATGGAAGGT CACGTGTTTG ACTTGAAAAT GTCAATACCA
    CGGCGCAGTA GTGGCACTTA CTATTGCGAG GCATGGAATC GTCACGGCTC CTTGAATATC
    TCATTTATTA TGAATGTGCA ATTTAAACCA GAATGTCATA TAGAAAAAGA ACGATTTGAG
    GGCCAGGATT ATGTCGTTTG CTCAGCCATT GCCAATCCGA AACAGACGGA TTTCACTTGG
    TCATTGAAGA ACGAAAATGA TTCGCTAGAG CAGGTCGCAC AAATACGAAA CGGAAAAAGT
    TACATGCTGC TCGATACCTC AGTCACTAAC TTCCGGACGT ACGTGTGCGT GGCAAACAAC
    ACAGTCGGCC ATTCCGTAGC GTGTGAACGC GATATACCAG CCCACCATGG AGTTAAACGA
    CATATACCTT GGTGGCATCG GTTGGACGGT AATCTGCTAC TGATTATTAT CGTAATGACG
    GTGATCATGA TACTAGTCCT AATACTGATC TGCGTGGCCA TTTATATCGT GTGCCGACGA
    AAACGCAGTC AATTGAAATA CAGTACTCGG GTGGTCGAAC TGGAGGAACG CGAACATCCA
    GACGGTGGAC CGCCCAGTCC AACAGTATCT TCGCACTCGG TTCAAAACCC GGCACAGCCG
    ACACCGGCGC CGAGATGGCC CTTGAAGCCG GGCGTACTAG TACACATCAA TCGAACTCAC
    AGCCTGCGAT CCGGCCTGAG CGTTCGTGCG AACGAGACTA ATCTGCAAAA CGAGGTGGTG
    GGCAAACATA ATGATGAATC GCTCAGACAG AGGTTCCTCG ATGAGACATC GTTGTCATCG
    ATTGGCCGTA ACCCAGCTCG AACGGTATTC CGCCGCGGTA GGAAAGATCA AACCGCGCAG
    AGAACAACGA GCATGACCAG TCTGAACGAA GACGGTATGC TTGCCCGAGC TAACAAGATA
    AAAGCCATGT TTGGCGTACA GCTCAAAGAG CAAGCCATCC TACCCGGTAT ATCCAGAGAA
    AAGACAGCTG TGACTTACAA GAGAATTGTG CCGCGGATGT TGCACGGCGT GGAATCATCC
    TATGAACCAA ATCGTGGTAA TATATCTCGT AAGCGAAAAA AACCTGGAGC GGATCCCAAT
    CAAGCCGCGA ATAACAATCA TGTGAACAGC GTGTCGGAAG TTCTTCCCGA CTCCGGGACA
    AAGACGTTCT ACGAAAATTT ACCTTTCCAC GGGATCCAAG CGCCACCTAA CAAGTTGGTT
    ACTCCTAAGT TTGCCCGAGT TTCGGCTTTG CATGGCACGT TGCATTCCAT CACGACCTCG
    CCGTGTTCCT CGCGGCCACC CAGCAGAGCT GTCAGTCTGT GCGATGGCAG TTCCGGTTAT
    GAGTCGACCA TGAGCCACCT AGGCCCTCAC TACAACATTT ACAACGTGCC CAGGAGCAAT
    TCGCCAGTGC TTAAATACAA CACCTTGAAA CCACGGCGGC GCAAACAGAA GCACTCGCAA
    CAATTCTATT CGTTGCGACT GTGTCGTCGG CATGAAAACA TCCGCAGGAA ATACGAACTA
    TATGCGATAC CGATCTATAA GACGTGCCCG CACAAGAGCG ATAGCACAAC CACAATCGCG
    ACGATCGTCC GGTCGATGGA GGATGCGCCG TCCTTGACTC TCAGCCAATC GTCGGCATCG
    ATTAGCCTGA TGAGCCGATC GACGCCGTCG ACGCCGATAC CGCCATCACC GATACCACCA
    GTACCAGCAC CGAGGATGTC CAAAAAAACT GATCCATCCA AACACACCTA CCAAAATGTC
    CCTCCCCCCG TTTTTCCGCC GAAAAACGCT TCGTTGCCTA AGCTTAAGAC CGACAGCCTA
    TACAACTACA AAGAACACTA CCAGCAGCAG CATCGGCAGG AGATGCAGCA GTACAGCTAC
    CCCTTACCGA GCAACAGTTC GAACCAACTA ACACTGCCAC TAACGAGCAG CCTCTACCAT
    TCCTCGATAG TTAGTCCCCT GCAGACCTCC CTCGTTTATA CTAACAACAG CCGTCCATCT
    ACCTTGATGC ATCATGAAGC TGCAACCACT GGCAATCACT TGTCTACAGT ACATCAGGAG
    CAGCAGCAGC CGAATTACGG CAATTCCGAC GCGAGACAAT CATCGACGCG TCGACATGCA
    ATGAATCGGC GAAACGAGCG TAATCGGAAG TACCGGAAGC ACGAACGAAT GTCGAGCGAT
    CGAAACAAGT CGAAGCAAAG CCGACAAAAG GACGCTCCTT CACGGCGTAA CAATACTTCC
    TTTGTCGATA CATCCAACTA CGAGACTAGC TTTCGTCAAA TCCCGGATCT GGGCGTGCCT
    GAGACAACGT ACAAGATCTC GTATCCGCAT TACTACGAGG ATGACATCGC GGAGTGCTCC
    ACCGACTATC ACAGACCAAA TCCGAAGGCG CATCAGCAAC AGCAGCAACA GCCGCCGTGG
    GAGCATCAAT CGAATCGCTG TACTGGCAAT AACACGCCCC AATTCGCAGC GGACGCGGGC
    GACGCGAAAA ATCGCAACAA AACGTCGAAA ACGAGACTCA ACGACACCCG CAGCATACCG
    TCCGCGCCCA CGATAATGCA GTACGCCGAA TTTCACTTCC GGGATGTCGG TCAGGAGATC
    GATGTCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012062859.1
    CDS1..5049
    Translation

    Target ORF information:

    RefSeq Version XM_012207469.1
    Organism Atta cephalotes
    Definition Atta cephalotes hemicentin-1 (LOC105626157), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012207469.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    5041
    ATGTTTGTTT CAGGGAGCGA AGCGTGGTTG AAAACTGTGA AGTTTGCTGA GCTCGGAACA 
    GAGATTTTAC TGCCCTGCGT CCTGAAATCA CCACAGTGTG ACGGTCTGCA CAGCATCAAG
    TGGTACCACG GATCCACGAG GATTTTCATT TTCAGTGAGG ATGCCGGGGT TATACGTGGC
    AATAACGACA TTGCTGCTAG GGCGGATATA GAGTATTCGT CGAATTCATC AAGATCGTAT
    TTGAAGCTAT CCGAAATTCA ACTAAACAAC GAGGGTCTAT ACAAGTGTGA GGCTACATAT
    ATGGCGGTCA ACCGCGAGTG CAACAACGTG CAGCACGTTC TTCTTAACGT CACAGTGCAA
    CCAGCGTTTG TACGTGTCAT CGATGAAAAT TCCAAAAATA CTTTGAGCAC TGGCGCCACT
    TTAGGACCTA TAAATGAGGG CTCGACAATA TCATTGTACT GCGAAAGTGG AGAAGGCAAA
    CCTGTACCTA CGGTTGAGTG GTTTAAAGAT GACGAGCTAC TCGAAGCAAC GAACTCGAGG
    ACTGTCACCG ATACCGGAAT TGGTACTGGC AGTAGTTTAC TGGAGATGCA AATTACACGA
    GAAGAGTTAG GCGCAACATT CACGTGTAAA GTCAACAATA TTGCACTCGT GGAACCACTA
    ACAGTTGACA TTAACTTAGA CATACATGTG CGTCCGCTGA AAATGGATTT GGAGGGAGTG
    GTCGGTCACG TCGTGCAGGG TACGAAAATT TTATTACAAT GTAAGGTACA GGCCGCACGA
    CCCGCTGCTA ATATAACATG GAAAAATGGA ACGCACTTTT TAAGTGAGAG CAATGAGAGA
    TTTGAAATGT TCGAAACAAA AATACAGGAA AATGAGGATG GTACATTCGA GACGATAAGT
    TATCTCGCAT TTACAGCCTC GGTATATGAC AACGGCAAGA CGTTTAAGTG TTACGCCGAA
    AATTCGGTTA CTCGTACCGA AGATCTAAAA CCAATGAAGG AAGCAACAAC GATTGAAGTG
    TTATATCCGC CAATAATTAA AATGAAGCCA AACAACATAA CTGTTAACGA GACAGACGAC
    TTTTTAATAT TCTGCGATTA TGAGGCAAAT CCGGCTACGC TACTAAAGGT GACGTGGTTA
    CGAGACGACG ATGAATTAGT GTTAAACGAA GAACATTACG ATGGTGGAAT CACGGAACAA
    ACAGCACTCA CAGTGAAAAA CGCGACTCCT AGCGACATGG GTTCTTACAA ATGCATCCTG
    GAAAACAACG CCGGTCCAAC CATTTCCGAG GCTACTGTAC AAGTTTCAGT CTTTTATAAG
    CCGGTGGTGG AAGTGATAAT GGATCCGGAA ACACCTGTGA ATGAGGCGGA TCGTCAGAAT
    GTTTCGCTAA CGTGCGAGGT CGACGCCGGT AATCCGGCGA TACTGACAGC CGTCCGTTGG
    TATTTGGACG GAGACCTATT GAAAGAACTT CCGGATTGCT CGAGGAATAG CACCGCCATG
    ATGAGCTCCG AGGAATCATT GGCATTCTGT GACATCGACC CCAGCAAATT GCTGCTGGAA
    TCTGTCGGCC GCACCTTCCA CGGCAACTAT TCCTGCGAAG GGAAAAACGA TGCTGGTTGG
    GGACCGAACT CCCCGAGCAC GTCTGTCATA GTTTATTATA AGCCCGGCCC GGCGTCGATA
    ACATACGAAC CTCGGCAAGT GGTGAAGAAA CAAGCATTAT CCATCACTTG CTTCGTTTTG
    GATCCCGGTC GACCGAGGGT GTTAGGCTTC AAGTGGCTGC GCGGCTGGCA CCGACTTCCA
    GACGAGAACG AAGCCACACT CTTCATCGAG TCAGTTAATT TGGAAACCGA GGCGAATTTC
    ACATGTCTGG CTTACAACGA AGCTGGTGAT GGAGAACCAG CCACAACGTT TATCGACGTA
    TCTGTGGCCC CGACATTTAT TAAGAAACTC CATTCGTATC GCGGCTACGT CTATAACGCG
    CCTAACGTGA GCATCATGTG TTGGGTCGAA TGCGCTCCGA TCTGCACTAT TTCCTGGCTG
    AGAGATGACA TTCCCATGAA CTTCACGAAA ACGAATCGAT ACTACGTGTC GAACGTTTAT
    CATCCGCCTG ACCCAAGGAC CGACGACTTC GAGAGCATCC AATCGACTCT CATATGGAAT
    CTGACGGTCT GGCCGAACGG TCAGCTCGAC CGTGCTGAGG ATAACGTCAA ATTTACCTGC
    AAGAGCAGCA GCAACGGAAT CGGTCCGGGC GTGGAGAGTT TTACCCATTT TCATGTCGAG
    TTTCCCCCAG AGGATATTAC AATATCAAAG AAGATAATCA ATGTGATAGT GGATACGGTA
    CCAGAAACCG TTGAGTGCAA TGCGAAAGCG CGACCAAAAC CAAACTTCCG GTGGTATCGC
    GAAGGATCCA CTGATATCAT TATGGAAGGT CACGTGTTTG ACTTGAAAAT GTCAATACCA
    CGGCGCAGTA GTGGCACTTA CTATTGCGAG GCATGGAATC GTCACGGCTC CTTGAATATC
    TCATTTATTA TGAATGTGCA ATTTAAACCA GAATGTCATA TAGAAAAAGA ACGATTTGAG
    GGCCAGGATT ATGTCGTTTG CTCAGCCATT GCCAATCCGA AACAGACGGA TTTCACTTGG
    TCATTGAAGA ACGAAAATGA TTCGCTAGAG CAGGTCGCAC AAATACGAAA CGGAAAAAGT
    TACATGCTGC TCGATACCTC AGTCACTAAC TTCCGGACGT ACGTGTGCGT GGCAAACAAC
    ACAGTCGGCC ATTCCGTAGC GTGTGAACGC GATATACCAG CCCACCATGG AGTTAAACGA
    CATATACCTT GGTGGCATCG GTTGGACGGT AATCTGCTAC TGATTATTAT CGTAATGACG
    GTGATCATGA TACTAGTCCT AATACTGATC TGCGTGGCCA TTTATATCGT GTGCCGACGA
    AAACGCAGTC AATTGAAATA CAGTACTCGG GTGGTCGAAC TGGAGGAACG CGAACATCCA
    GACGGTGGAC CGCCCAGTCC AACAGTATCT TCGCACTCGG TTCAAAACCC GGCACAGCCG
    ACACCGGCGC CGAGATGGCC CTTGAAGCCG GGCGTACTAG TACACATCAA TCGAACTCAC
    AGCCTGCGAT CCGGCCTGAG CGTTCGTGCG AACGAGACTA ATCTGCAAAA CGAGGTGGTG
    GGCAAACATA ATGATGAATC GCTCAGACAG AGGTTCCTCG ATGAGACATC GTTGTCATCG
    ATTGGCCGTA ACCCAGCTCG AACGGTATTC CGCCGCGGTA GGAAAGATCA AACCGCGCAG
    AGAACAACGA GCATGACCAG TCTGAACGAA GACGGTATGC TTGCCCGAGC TAACAAGATA
    AAAGCCATGT TTGGCGTACA GCTCAAAGAG CAAGCCATCC TACCCGGTAT ATCCAGAGAA
    AAGACAGCTG TGACTTACAA GAGAATTGTG CCGCGGATGT TGCACGGCGT GGAATCATCC
    TATGAACCAA ATCGTGGTAA TATATCTCGT AAGCGAAAAA AACCTGGAGC GGATCCCAAT
    CAAGCCGCGA ATAACAATCA TGTGAACAGC GTGTCGGAAG TTCTTCCCGA CTCCGGGACA
    AAGACGTTCT ACGAAAATTT ACCTTTCCAC GGGATCCAAG CGCCACCTAA CAAGTTGGTT
    ACTCCTAAGT TTGCCCGAGT TTCGGCTTTG CATGGCACGT TGCATTCCAT CACGACCTCG
    CCGTGTTCCT CGCGGCCACC CAGCAGAGCT GTCAGTCTGT GCGATGGCAG TTCCGGTTAT
    GAGTCGACCA TGAGCCACCT AGGCCCTCAC TACAACATTT ACAACGTGCC CAGGAGCAAT
    TCGCCAGTGC TTAAATACAA CACCTTGAAA CCACGGCGGC GCAAACAGAA GCACTCGCAA
    CAATTCTATT CGTTGCGACT GTGTCGTCGG CATGAAAACA TCCGCAGGAA ATACGAACTA
    TATGCGATAC CGATCTATAA GACGTGCCCG CACAAGAGCG ATAGCACAAC CACAATCGCG
    ACGATCGTCC GGTCGATGGA GGATGCGCCG TCCTTGACTC TCAGCCAATC GTCGGCATCG
    ATTAGCCTGA TGAGCCGATC GACGCCGTCG ACGCCGATAC CGCCATCACC GATACCACCA
    GTACCAGCAC CGAGGATGTC CAAAAAAACT GATCCATCCA AACACACCTA CCAAAATGTC
    CCTCCCCCCG TTTTTCCGCC GAAAAACGCT TCGTTGCCTA AGCTTAAGAC CGACAGCCTA
    TACAACTACA AAGAACACTA CCAGCAGCAG CATCGGCAGG AGATGCAGCA GTACAGCTAC
    CCCTTACCGA GCAACAGTTC GAACCAACTA ACACTGCCAC TAACGAGCAG CCTCTACCAT
    TCCTCGATAG TTAGTCCCCT GCAGACCTCC CTCGTTTATA CTAACAACAG CCGTCCATCT
    ACCTTGATGC ATCATGAAGC TGCAACCACT GGCAATCACT TGTCTACAGT ACATCAGGAG
    CAGCAGCAGC CGAATTACGG CAATTCCGAC GCGAGACAAT CATCGACGCG TCGACATGCA
    ATGAATCGGC GAAACGAGCG TAATCGGAAG TACCGGAAGC ACGAACGAAT GTCGAGCGAT
    CGAAACAAGT CGAAGCAAAG CCGACAAAAG GACGCTCCTT CACGGCGTAA CAATACTTCC
    TTTGTCGATA CATCCAACTA CGAGACTAGC TTTCGTCAAA TCCCGGATCT GGGCGTGCCT
    GAGACAACGT ACAAGATCTC GTATCCGCAT TACTACGAGG ATGACATCGC GGAGTGCTCC
    ACCGACTATC ACAGACCAAA TCCGAAGGCG CATCAGCAAC AGCAGCAACA GCCGCCGTGG
    GAGCATCAAT CGAATCGCTG TACTGGCAAT AACACGCCCC AATTCGCAGC GGACGCGGGC
    GACGCGAAAA ATCGCAACAA AACGTCGAAA ACGAGACTCA ACGACACCCG CAGCATACCG
    TCCGCGCCCA CGATAATGCA GTACGCCGAA TTTCACTTCC GGGATGTCGG TCAGGAGATC
    GATGTCTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.