LOC105621109 cDNA ORF clone, Atta cephalotes

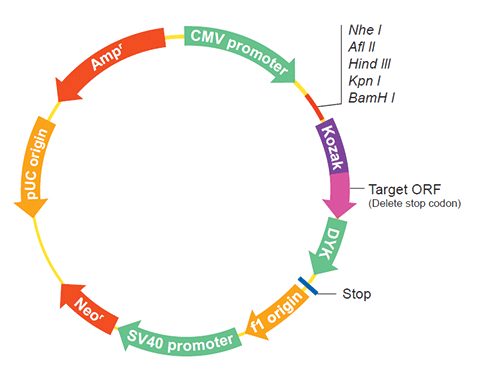
The following LOC105621109 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105621109 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAt116672 XM_012202581.1
Latest version!
Atta cephalotes 5'-3' exoribonuclease 1 (LOC105621109), mRNA. pcDNA3.1-C-(k)DYK or customized vector 24-26 $1021.30
$1459.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAt116672
    Clone ID Related Accession (Same CDS sequence) XM_012202581.1
    Accession Version XM_012202581.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 5040bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-04-01
    Organism Atta cephalotes
    Product 5'-3' exoribonuclease 1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_012130096.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Atta cephalotes Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    ATGGGTGTGC CGAAATTCTT CAGATACATA AGCGAGAGAT ATCCCTGTCT CAGCGAGGTC 
    GTGAAGGAAC ATCAGATACC AGAATTTGAT TATTTATATT TGGACATGAA TGGTATTATA
    CATACATGTT CCCATCCCAA TGACGATGTC TGCTTCCGCA TCTCCGAGGA GATGATTTTT
    AAAAATATAT TTCACTATAT AGAGGTGCTA TTTAATATGA TCCGCCCACA GAAATTGTTT
    TTTATGGCGA TTGACGGTGT CGCGCCTAGA GCAAAAATCA ATCAACAGAG GGGCCGACGT
    TTCAGAGCTG CTAAGGATGC CGAAGTGCAA GAAGCTAAAG CCAAGGCCAA GGGTATTCCA
    ATACCCAAAG AGAAGAGATT CGACTCGAAT TGCATAACCC CAGGAACACT TTTTATGGCA
    AAATTAGGCG AGCAGCTTAA ATGTTTTGTC GAACACAAGG TTTCTACAGA TGATGCTTGG
    AAAAAATGTA AAATATTGTT CAGTGGTTCT GAGGTCCCTG GAGAGGGAGA GCACAAGATT
    ATGGATTATA TAAGGTACAT GAAGGCAAGC AAGGATTACA ACAATGACTC TAGCCATTGT
    TTATATGGTT TGGATGCAGA TTTAATAATG TTAGGCTTGT GTTCACATGA ACCGAATTTC
    TCTCTTTTGA GAGAGGAAGT AAAATTTGGC AAGCAACAAG TGAAAATGAC CCCGGAGGAA
    ACAAAGTTCT GCCTTCTTCA TTTGTCACTT TTACGAGAAT ACATAGAACA TGAGTTCTCA
    CCGATCAAGG ATAAACTGTC ATTTTCGTTT GATATTGAGA AAATAATTGA CGACTGGGTT
    TTAATGGGTT TTTTAGTAGG AAATGATTTT ATTCCCCACC TGCCAAATTT ACATATTGCC
    AACGGTGCAT TACCAATTCT ATACCGTGCA TATATGGAGG TATTACCAAC ACTAGAGGGT
    TATATAAATG AAGCGGGAAC ATTAAATCTT GACCGTTTTG AAAAGTTTAT GGAGAGACTT
    AGCCGTTTAG ATGTAGAGCA GTTTAACGAG CAATATGCCG ATATAAAGTT TTTTGAAAGT
    AAGACAGGTA GAAGGCCCAA TGAATCTGAG CGTCATATAT ATAAGAAAAC AGAAGACAGT
    GAGAGTGCAT CTCCAAAAAA AACACAAAAT AAAGATTTAG ATGCGCTTAT CAAAAGTACT
    AGGGAGATGT CCTTAGGTAA TTTTGACGAT GATGATATCT TTATAGAGTA TAGAAATATG
    GATTTAATAG TAGATGATGA ATCGGATAGT GAAATATATA ACATGGAATT TGTACAACAT
    AAAAAAGATT ATTATATGAA CAAGTTAGAA TATGAAAACG TCGATGAAGA AGTTTTACGT
    TCACAGGCTG AAGGTTATGT GAGAGCGATA CAGTGGAATT TGCATTATTA TTATCACGGC
    TGTTGCAGCT GGTCGTGGTA TTATCCACAT CATTACGCCC CATACATCTC AGATATAAAA
    GACTTCAAAG ATTTGAAGTT AGAATTCGAC TTAGGAGAGC CATTCTTACC TTTTCAACAA
    TTGCTAGCTG TGTTACCAGC ATTTAGCAAA GATTTATTAC CAATGGCATT TCAGTCACTA
    CTGACAGAGG AAACTTCTCC AATTATTAAT TATTATCCAC ATAATTTTAA AACCGATTTA
    AATGGGAAAC GACAGGAATG GGAAGCAGTT GTACTGATCC CATTTATTGA TGAAAAACTA
    TTGTTGGCTG CTATGCAGCC ACACTTATCA AGATTAACAC TTGAAGAACA AGCAAGAAAT
    AAACATGGGC CGATGTGTTT GTACTCGTAT ACCGATGAAA GCCAAAGTGT TCACAAAACA
    ACAATATACT TTCCAGAATT TACCAATCAT GTTCAAGTAA AATTAATGAA TCGCGAAGAA
    ATTTTTGTTC CGAGAGAACA ATTAATTAGG GGATTATCCC CTGGTTTTGA TCTCGACATT
    TATTATCCAG GATTTCCTAC ACTACGGCAT TTGGACCATT CAGCGCATTT GGAAAAAGCG
    AGGGTCAAAG TATTTCAGCA ACATTCAGTC TTGGACAGTA TGATTCTAAC TCTAATATCA
    AAATCAATAC CCAATTTAAC GACTTTAGCA TCAGAGCTAT TAGGAAAGAG CATATATGTG
    GAATGGCCTC ATTTGAAAGA AGTCCTTGTA GTCGGTGTGT CTGACTGTAA CGTGAAACTC
    AGTTTAATCA ACCAATTAGG CAGTTACAGT CACGATAATC TGAAGAAAGA AGATGTGAAG
    GGCGCGTTAT CTGCAGAATG GAACACATTA TGCAAACAAA TTAAAGAATT ACATATGTCA
    CGTCTTGGAA TAGATATTGG CGATACAAAT GTGTTGCTTT ATGCTCGTGC ATTCCTGGGC
    AACAAATATG TTTTCGGTGT TCAAGGAAAA GTTACAGTTG AGAAACAGTG GAACGATTAC
    GCCGCAGCTT ATGCTTATCA GACTGTAGTT AAAGATATTT CCGTCTACAG TAAAAAATTG
    CCAATCTACG AAACTATGCA TGATATTTTT ATACCAGGAA CCTTTTGTTT CATGTTGGGA
    CATCCCTATT ATGGTGCAAT GGGACAGGTT ATACACAATA AAGAGGGTTG CAAGTCACGC
    AGAATCAAAA TTTCTATAAA AACTATGAAG GAGCCAACAT TCGATACTAT TAAACAAGCT
    TACGGGCAAC AAAAAACGCG ATATATGCCT GGCAGTGTTG CCGCACAACG TCTTGGAATA
    AATAGTCATC TTTTGAGTAG GGTCACTGGA ACAATTTATG TTATAGAATC ATCGACGATT
    GAAGTTACTA AACATAATCT TGGATTGAAT TTAAAATTCA ATAAAAGGAA TGAAGAGGTA
    CCTGGTTATA CCAAAAAGGA AAACAATCAA TGGTTATACA GCACAAAAGC GATCGAACTG
    ATTCGGAATT ACATGACGAA ATGTCCTAAT TTATTCGAAC GTTTAACTCA AAATGTAGCA
    AACGATATTT TCCAAGAGGA AGAGTTATTC ACAAAGGGCT CGGATGAATT GAAGGATACA
    GTTGCATGGT TGAAAACAGA ACTGAACGGT TTAGAAAGTC GCACTTGCGG AATGGATGTC
    ATCGAAGCAG ATTTGATCAA ACAAATCGAG GAGGGAGTAG AAGAATATTT GAAAGCTGAA
    GAGACTATGG CAAAAACGGT CTTTCTGCAA GTGAAGCCGC AATTACTTTA TAAGCCGGGT
    TTACACTTGC GTAGCGTGCC GCCCGATCCG AACTCCCAAA ATCGTTTATT CGATAGAATT
    CTCTGTGTAA GAAGCGGCTT TAGCGTACCG CTCGGAACTA AGGGCACTAT CATTGGAATA
    CGAAATGGAA GCAATCCAAT TGATACCATG TATGACGTTT TGTTCGATAA GCCTTTTATC
    GGCGGACTTA CATTAAACGG TTGCTCTCAG TTTCGCGGTT ATCGTTTGTC GACTATGGAT
    TTCATAAATA TTAGTTTCGG CGAAAGAACA GAGCAGGGAA ATGTAGTGAA TGAATTGACA
    GAAAGCCGGA AGCAAACGAT CAATTCTGTT TCTCCCAACA AGAAGAACGA ATTATCGAAG
    GCATATCCGC AAATGCAGCT TGCTAAGAAG GGACTCGAAA AATTAAATCG TGATATTTGT
    ATGCGTATGG CGCAACATGG CATGGAAGTG AATCCTAAAA CAGTACCTCA GAAAACATTA
    ACTCAGAACG CACCACCGCC TAATCAAACA TCTGAGTTTC AAGCATTGTG GAATGAATTG
    CACAAGATGC AGAAACCGAA TGAACCACCA GAGAAAGTGG CATGCAGTTC AACGCCGAGA
    ATCAAGTCGT ACAGCAACAA TCATAGCGCA CAATCGCCAC AAGATCCTAG TGCATTTTTA
    AAAGCTGTGC TAAAGATTCC TGACGTAAAT CCACAAACGA GCAAGCAAGA AAATACGCCT
    CAACAATCTA CGTCACAACA ATCTGTACCA CAACAATCTA TGCCGCAACA GTCTATATCG
    CAACCCGCAA CGATGCTTCA GAAAACAGTC TCGCAGAAGG ATCAGAATCC TCCACCTTTA
    GTACAACAGT TGTTCGATCG TGCCCGACAA ACAGAACAGA AAAAAGAGAA AGCAAATGCA
    GTCTGGTACA GCACGCAATT ATTGAAACAT TTCTCATATA ACGGAACTGG CGTGCCAAAA
    TATAATTATA TTGTCGACGA AAAAACAGGT TTGATCAGCG CTCATGTTAT GCTTATGGAC
    AATAAGATCT TTAAGGGCGA TCCTTGTACT ACTCATGAAC AAGCCACAGA AAGCGCCGCA
    AAAAAAGCTT ACAAGGCGTT AAATTTGAAT AAGGCATCAA TGCACGATAC GAAAGTAGCA
    ATAACGCCTC AGTGGTTTAA CACTCAACAA AACAATTGGA TCCAAAATAT CCGACCTCCT
    ATGATGCCTC CAATGGGCCA TCTGAAAATA CCGCCAGTTC CGCTGAATAT GCCACCTATG
    CAGCCTAACT TATTTTATCC AAAGTGGAAT CCAAAATTAC CACCGACTCC AGCGTTCATG
    CAACTCGCAT CGTATAGCCA AAGCAGGCAA TTGCAAATGA AACATCAGAT GCAACAGAAT
    CATCAACAAC AGAAAGGTCC TCAGAATGGA TCAAAGATGG AAATAAGAAA TAGCACCGCA
    TTTGTTCCGT TACAAGCTCA GAAAAAGAGT AGAAACGCCA GCGTACAACA AGCCTCGAAA
    GAGATGAATC CGAATGCTAA GAAGAGCTCC AGTCCTTCAA AAACGCAACA ACAACCACAA
    AAACAGAAAC AAGAAGAAAT GTTGCCCAAG AAACAGAAGC CAGAAGTTGT AAATAAGGCC
    AGGGAAAAGA TAGCGTCAAA CGAGCCGCAG CTACAAGCAA AACAACAACT GCAGCTGCAA
    CAACAACCAC AGCAACAGCC GCAACAAAAC ACAGGAAAAT CGTCCAAGCC CAGGAAATCA
    CGTGTCGCTG CAAAATTCGG CACACAACCC TTGTCGAACG GTGGTGAATC CCCTCAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012057971.1
    CDS1..5040
    Translation

    Target ORF information:

    RefSeq Version XM_012202581.1
    Organism Atta cephalotes
    Definition Atta cephalotes 5'-3' exoribonuclease 1 (LOC105621109), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012202581.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    3781
    3841
    3901
    3961
    4021
    4081
    4141
    4201
    4261
    4321
    4381
    4441
    4501
    4561
    4621
    4681
    4741
    4801
    4861
    4921
    4981
    ATGGGTGTGC CGAAATTCTT CAGATACATA AGCGAGAGAT ATCCCTGTCT CAGCGAGGTC 
    GTGAAGGAAC ATCAGATACC AGAATTTGAT TATTTATATT TGGACATGAA TGGTATTATA
    CATACATGTT CCCATCCCAA TGACGATGTC TGCTTCCGCA TCTCCGAGGA GATGATTTTT
    AAAAATATAT TTCACTATAT AGAGGTGCTA TTTAATATGA TCCGCCCACA GAAATTGTTT
    TTTATGGCGA TTGACGGTGT CGCGCCTAGA GCAAAAATCA ATCAACAGAG GGGCCGACGT
    TTCAGAGCTG CTAAGGATGC CGAAGTGCAA GAAGCTAAAG CCAAGGCCAA GGGTATTCCA
    ATACCCAAAG AGAAGAGATT CGACTCGAAT TGCATAACCC CAGGAACACT TTTTATGGCA
    AAATTAGGCG AGCAGCTTAA ATGTTTTGTC GAACACAAGG TTTCTACAGA TGATGCTTGG
    AAAAAATGTA AAATATTGTT CAGTGGTTCT GAGGTCCCTG GAGAGGGAGA GCACAAGATT
    ATGGATTATA TAAGGTACAT GAAGGCAAGC AAGGATTACA ACAATGACTC TAGCCATTGT
    TTATATGGTT TGGATGCAGA TTTAATAATG TTAGGCTTGT GTTCACATGA ACCGAATTTC
    TCTCTTTTGA GAGAGGAAGT AAAATTTGGC AAGCAACAAG TGAAAATGAC CCCGGAGGAA
    ACAAAGTTCT GCCTTCTTCA TTTGTCACTT TTACGAGAAT ACATAGAACA TGAGTTCTCA
    CCGATCAAGG ATAAACTGTC ATTTTCGTTT GATATTGAGA AAATAATTGA CGACTGGGTT
    TTAATGGGTT TTTTAGTAGG AAATGATTTT ATTCCCCACC TGCCAAATTT ACATATTGCC
    AACGGTGCAT TACCAATTCT ATACCGTGCA TATATGGAGG TATTACCAAC ACTAGAGGGT
    TATATAAATG AAGCGGGAAC ATTAAATCTT GACCGTTTTG AAAAGTTTAT GGAGAGACTT
    AGCCGTTTAG ATGTAGAGCA GTTTAACGAG CAATATGCCG ATATAAAGTT TTTTGAAAGT
    AAGACAGGTA GAAGGCCCAA TGAATCTGAG CGTCATATAT ATAAGAAAAC AGAAGACAGT
    GAGAGTGCAT CTCCAAAAAA AACACAAAAT AAAGATTTAG ATGCGCTTAT CAAAAGTACT
    AGGGAGATGT CCTTAGGTAA TTTTGACGAT GATGATATCT TTATAGAGTA TAGAAATATG
    GATTTAATAG TAGATGATGA ATCGGATAGT GAAATATATA ACATGGAATT TGTACAACAT
    AAAAAAGATT ATTATATGAA CAAGTTAGAA TATGAAAACG TCGATGAAGA AGTTTTACGT
    TCACAGGCTG AAGGTTATGT GAGAGCGATA CAGTGGAATT TGCATTATTA TTATCACGGC
    TGTTGCAGCT GGTCGTGGTA TTATCCACAT CATTACGCCC CATACATCTC AGATATAAAA
    GACTTCAAAG ATTTGAAGTT AGAATTCGAC TTAGGAGAGC CATTCTTACC TTTTCAACAA
    TTGCTAGCTG TGTTACCAGC ATTTAGCAAA GATTTATTAC CAATGGCATT TCAGTCACTA
    CTGACAGAGG AAACTTCTCC AATTATTAAT TATTATCCAC ATAATTTTAA AACCGATTTA
    AATGGGAAAC GACAGGAATG GGAAGCAGTT GTACTGATCC CATTTATTGA TGAAAAACTA
    TTGTTGGCTG CTATGCAGCC ACACTTATCA AGATTAACAC TTGAAGAACA AGCAAGAAAT
    AAACATGGGC CGATGTGTTT GTACTCGTAT ACCGATGAAA GCCAAAGTGT TCACAAAACA
    ACAATATACT TTCCAGAATT TACCAATCAT GTTCAAGTAA AATTAATGAA TCGCGAAGAA
    ATTTTTGTTC CGAGAGAACA ATTAATTAGG GGATTATCCC CTGGTTTTGA TCTCGACATT
    TATTATCCAG GATTTCCTAC ACTACGGCAT TTGGACCATT CAGCGCATTT GGAAAAAGCG
    AGGGTCAAAG TATTTCAGCA ACATTCAGTC TTGGACAGTA TGATTCTAAC TCTAATATCA
    AAATCAATAC CCAATTTAAC GACTTTAGCA TCAGAGCTAT TAGGAAAGAG CATATATGTG
    GAATGGCCTC ATTTGAAAGA AGTCCTTGTA GTCGGTGTGT CTGACTGTAA CGTGAAACTC
    AGTTTAATCA ACCAATTAGG CAGTTACAGT CACGATAATC TGAAGAAAGA AGATGTGAAG
    GGCGCGTTAT CTGCAGAATG GAACACATTA TGCAAACAAA TTAAAGAATT ACATATGTCA
    CGTCTTGGAA TAGATATTGG CGATACAAAT GTGTTGCTTT ATGCTCGTGC ATTCCTGGGC
    AACAAATATG TTTTCGGTGT TCAAGGAAAA GTTACAGTTG AGAAACAGTG GAACGATTAC
    GCCGCAGCTT ATGCTTATCA GACTGTAGTT AAAGATATTT CCGTCTACAG TAAAAAATTG
    CCAATCTACG AAACTATGCA TGATATTTTT ATACCAGGAA CCTTTTGTTT CATGTTGGGA
    CATCCCTATT ATGGTGCAAT GGGACAGGTT ATACACAATA AAGAGGGTTG CAAGTCACGC
    AGAATCAAAA TTTCTATAAA AACTATGAAG GAGCCAACAT TCGATACTAT TAAACAAGCT
    TACGGGCAAC AAAAAACGCG ATATATGCCT GGCAGTGTTG CCGCACAACG TCTTGGAATA
    AATAGTCATC TTTTGAGTAG GGTCACTGGA ACAATTTATG TTATAGAATC ATCGACGATT
    GAAGTTACTA AACATAATCT TGGATTGAAT TTAAAATTCA ATAAAAGGAA TGAAGAGGTA
    CCTGGTTATA CCAAAAAGGA AAACAATCAA TGGTTATACA GCACAAAAGC GATCGAACTG
    ATTCGGAATT ACATGACGAA ATGTCCTAAT TTATTCGAAC GTTTAACTCA AAATGTAGCA
    AACGATATTT TCCAAGAGGA AGAGTTATTC ACAAAGGGCT CGGATGAATT GAAGGATACA
    GTTGCATGGT TGAAAACAGA ACTGAACGGT TTAGAAAGTC GCACTTGCGG AATGGATGTC
    ATCGAAGCAG ATTTGATCAA ACAAATCGAG GAGGGAGTAG AAGAATATTT GAAAGCTGAA
    GAGACTATGG CAAAAACGGT CTTTCTGCAA GTGAAGCCGC AATTACTTTA TAAGCCGGGT
    TTACACTTGC GTAGCGTGCC GCCCGATCCG AACTCCCAAA ATCGTTTATT CGATAGAATT
    CTCTGTGTAA GAAGCGGCTT TAGCGTACCG CTCGGAACTA AGGGCACTAT CATTGGAATA
    CGAAATGGAA GCAATCCAAT TGATACCATG TATGACGTTT TGTTCGATAA GCCTTTTATC
    GGCGGACTTA CATTAAACGG TTGCTCTCAG TTTCGCGGTT ATCGTTTGTC GACTATGGAT
    TTCATAAATA TTAGTTTCGG CGAAAGAACA GAGCAGGGAA ATGTAGTGAA TGAATTGACA
    GAAAGCCGGA AGCAAACGAT CAATTCTGTT TCTCCCAACA AGAAGAACGA ATTATCGAAG
    GCATATCCGC AAATGCAGCT TGCTAAGAAG GGACTCGAAA AATTAAATCG TGATATTTGT
    ATGCGTATGG CGCAACATGG CATGGAAGTG AATCCTAAAA CAGTACCTCA GAAAACATTA
    ACTCAGAACG CACCACCGCC TAATCAAACA TCTGAGTTTC AAGCATTGTG GAATGAATTG
    CACAAGATGC AGAAACCGAA TGAACCACCA GAGAAAGTGG CATGCAGTTC AACGCCGAGA
    ATCAAGTCGT ACAGCAACAA TCATAGCGCA CAATCGCCAC AAGATCCTAG TGCATTTTTA
    AAAGCTGTGC TAAAGATTCC TGACGTAAAT CCACAAACGA GCAAGCAAGA AAATACGCCT
    CAACAATCTA CGTCACAACA ATCTGTACCA CAACAATCTA TGCCGCAACA GTCTATATCG
    CAACCCGCAA CGATGCTTCA GAAAACAGTC TCGCAGAAGG ATCAGAATCC TCCACCTTTA
    GTACAACAGT TGTTCGATCG TGCCCGACAA ACAGAACAGA AAAAAGAGAA AGCAAATGCA
    GTCTGGTACA GCACGCAATT ATTGAAACAT TTCTCATATA ACGGAACTGG CGTGCCAAAA
    TATAATTATA TTGTCGACGA AAAAACAGGT TTGATCAGCG CTCATGTTAT GCTTATGGAC
    AATAAGATCT TTAAGGGCGA TCCTTGTACT ACTCATGAAC AAGCCACAGA AAGCGCCGCA
    AAAAAAGCTT ACAAGGCGTT AAATTTGAAT AAGGCATCAA TGCACGATAC GAAAGTAGCA
    ATAACGCCTC AGTGGTTTAA CACTCAACAA AACAATTGGA TCCAAAATAT CCGACCTCCT
    ATGATGCCTC CAATGGGCCA TCTGAAAATA CCGCCAGTTC CGCTGAATAT GCCACCTATG
    CAGCCTAACT TATTTTATCC AAAGTGGAAT CCAAAATTAC CACCGACTCC AGCGTTCATG
    CAACTCGCAT CGTATAGCCA AAGCAGGCAA TTGCAAATGA AACATCAGAT GCAACAGAAT
    CATCAACAAC AGAAAGGTCC TCAGAATGGA TCAAAGATGG AAATAAGAAA TAGCACCGCA
    TTTGTTCCGT TACAAGCTCA GAAAAAGAGT AGAAACGCCA GCGTACAACA AGCCTCGAAA
    GAGATGAATC CGAATGCTAA GAAGAGCTCC AGTCCTTCAA AAACGCAACA ACAACCACAA
    AAACAGAAAC AAGAAGAAAT GTTGCCCAAG AAACAGAAGC CAGAAGTTGT AAATAAGGCC
    AGGGAAAAGA TAGCGTCAAA CGAGCCGCAG CTACAAGCAA AACAACAACT GCAGCTGCAA
    CAACAACCAC AGCAACAGCC GCAACAAAAC ACAGGAAAAT CGTCCAAGCC CAGGAAATCA
    CGTGTCGCTG CAAAATTCGG CACACAACCC TTGTCGAACG GTGGTGAATC CCCTCAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.