LOC105617172 cDNA ORF clone, Atta cephalotes

The following LOC105617172 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105617172 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAt113339 XM_012198738.1
Latest version!
Atta cephalotes uncharacterized LOC105617172 (LOC105617172), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAt113339
    Clone ID Related Accession (Same CDS sequence) XM_012198738.1
    Accession Version XM_012198738.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1938bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
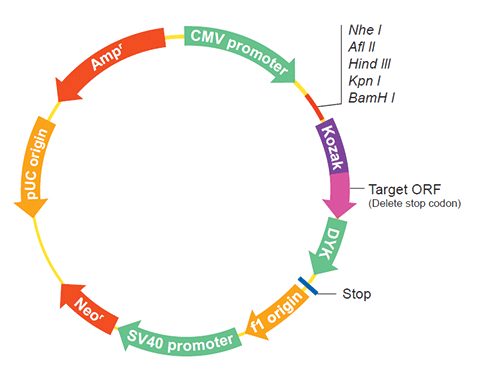
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-04-01
    Organism Atta cephalotes
    Product uncharacterized protein LOC105617172
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_012130076.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Atta cephalotes Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGAATTTAA AAATGCGGCT CTTTCTGGTC ATCTATGTTT GCGTATTAAT GCTTTCGCTG 
    ACGCAAGCTA AGCAGAAAGC CGAAATGCAG AAGTCGGAAA TCACGAAGCT GGAAGTGGTG
    AATCTTGGCG AAATTCAAGT TAAATCCAAT TCCAAGCAAT TCGACGTGCA ACGGAAACGA
    GATTCCGGAT ACATTTATAA CAGGCCGAAT CATGTCTCTT CAAATGCTCG GTTTCGCATT
    CAAACGCAAC CATCCAGAAG TCAAATAGCA TTTAAGGTTC CTGGCCAATT GAACAGACCG
    TTTACAAAAT ATGGATCTCC TATCATTCAC TCAACTTCCA ATCAGGCCAC ACATGAATAT
    CATGCTCAGC AACATCAGAA TAAATTGCAG TACAATATCA ATCAACAGCA ATCAAGCAAT
    TTCGGTGGAA CAGGACTGGT GAAACAGGAA ATACCGAGCC CGATTAGAAA CGTTGATTTT
    ACGGAGGTCA ATCCGATTGC TAGTCAAAAT AATGAGCCAT TTGGCATGCA CACCGCTAAT
    TATTTACCGC CGCAAAATCA AAAGCTGCCG GTTTATTCTC CGACGAATAA TTTCAATTCA
    CAGAACATTC CAAATCAGGG ACAAATTCAC GGTACAAGCT CACAGAGCCA GAATTTCGCG
    CAGAATCAAA TTTCCGACGC CGCGTTCTTC CTGTCTGAGA ACGCACAAGC GATCCAGCAA
    CTTTACGGCG CACCCGCAAG CAATCAAGAC TTTGCGCCCA GCAATAATCA ATTTCAGAAT
    ATCGGTAATC AAATTCATAA TCTAAATGGT CAGTTTGAGA GTACCTCGTC GAACTCTGAG
    GAATACCGTG ATGCGTTGCC GTCATATGCA TCGGGAACAC TCGATCCTCG AGAGACTCTG
    GAACAAATTC AGGCTCAAGA GAAAGATCGG TTAATCATTC AATTGCAGCA GGCTCTCGCT
    CAGGCTCAGA TTAACCCGCG CGCAAACACG GCGGGAAGAT ATGCTCAGAA TCAAGCAGGT
    TTTATTCAGA ATCAAGAACT TTTGGCCTCC ATAAATCAGC AAATAAACCC GCGTATTCCC
    ACGACGTCGC AATCTACAAC TGTTGGCTCT GAAAACACCG CGTTCAGCCA GTCTACCTTT
    CTACCAGAGA CCACAATCAA CCCCTTGAGA TTACCCGTTA ACTACGGTAT TCCGACTACT
    ACTCAAACTC CGACCACAAC AACGGTAGCA GCGGGAGTTT TCACTACGCA ATCTTCATCG
    CAATCATCTA AGGGTGATAG TACTGTCCAA GTAGTATCAT CACAACCCGC TTCTAACCAG
    CCTGGTTTTT CCGCGACTGG ATCTCCCGCG GGGATCCCCA TTTATGGTGG ATTCGTACCG
    ACTTTCATCA CGGGAACCAA CTTGGCTCCC AGCTACAGTA CCAGCATCTT GACATCCGGA
    TCCTTTAGGC CCGAAACATC GCCCACCCAT TTTGGGATAC CGATTCCCAC AGAATCGCAG
    CATAAACCGT CGGAATCAGT ACCTTCGATG CCAACGACGA CAACACCACC TCTTTCGTCT
    GTCTCACCGT CCAATCGACC GGGGGTTGCT CTAACACCAG CGGCAATCAC CCCGGTAGCT
    TTGCCAATTC AACCGTTACG ACCTGTTGCT CCCCTCGCAA CATCGATACA TCCGATCACC
    GCTCCTTTAC TGCCGAATCC CACTCAAGTG CATCCGGCGC AATCCATTCC TGTAACGTCC
    AGCGTGCAAC ACACGTATGG TGTGCAAACC GCTTTGATCA ATCCCATTCT TTATAAACCA
    GTTAAAGCTG TCTATCCGGT GTATTATTAT CCCGTGAATA TTCCCTATCA GCTGCAGAAA
    CCTGTTTCAC CGAGTTACCC TTGGAATTAC GCGCCTTCGT ATACGACGCA GACAGGATCG
    GCGAAAATAT GGAAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012054128.1
    CDS1..1938
    Translation

    Target ORF information:

    RefSeq Version XM_012198738.1
    Organism Atta cephalotes
    Definition Atta cephalotes uncharacterized LOC105617172 (LOC105617172), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012198738.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGAATTTAA AAATGCGGCT CTTTCTGGTC ATCTATGTTT GCGTATTAAT GCTTTCGCTG 
    ACGCAAGCTA AGCAGAAAGC CGAAATGCAG AAGTCGGAAA TCACGAAGCT GGAAGTGGTG
    AATCTTGGCG AAATTCAAGT TAAATCCAAT TCCAAGCAAT TCGACGTGCA ACGGAAACGA
    GATTCCGGAT ACATTTATAA CAGGCCGAAT CATGTCTCTT CAAATGCTCG GTTTCGCATT
    CAAACGCAAC CATCCAGAAG TCAAATAGCA TTTAAGGTTC CTGGCCAATT GAACAGACCG
    TTTACAAAAT ATGGATCTCC TATCATTCAC TCAACTTCCA ATCAGGCCAC ACATGAATAT
    CATGCTCAGC AACATCAGAA TAAATTGCAG TACAATATCA ATCAACAGCA ATCAAGCAAT
    TTCGGTGGAA CAGGACTGGT GAAACAGGAA ATACCGAGCC CGATTAGAAA CGTTGATTTT
    ACGGAGGTCA ATCCGATTGC TAGTCAAAAT AATGAGCCAT TTGGCATGCA CACCGCTAAT
    TATTTACCGC CGCAAAATCA AAAGCTGCCG GTTTATTCTC CGACGAATAA TTTCAATTCA
    CAGAACATTC CAAATCAGGG ACAAATTCAC GGTACAAGCT CACAGAGCCA GAATTTCGCG
    CAGAATCAAA TTTCCGACGC CGCGTTCTTC CTGTCTGAGA ACGCACAAGC GATCCAGCAA
    CTTTACGGCG CACCCGCAAG CAATCAAGAC TTTGCGCCCA GCAATAATCA ATTTCAGAAT
    ATCGGTAATC AAATTCATAA TCTAAATGGT CAGTTTGAGA GTACCTCGTC GAACTCTGAG
    GAATACCGTG ATGCGTTGCC GTCATATGCA TCGGGAACAC TCGATCCTCG AGAGACTCTG
    GAACAAATTC AGGCTCAAGA GAAAGATCGG TTAATCATTC AATTGCAGCA GGCTCTCGCT
    CAGGCTCAGA TTAACCCGCG CGCAAACACG GCGGGAAGAT ATGCTCAGAA TCAAGCAGGT
    TTTATTCAGA ATCAAGAACT TTTGGCCTCC ATAAATCAGC AAATAAACCC GCGTATTCCC
    ACGACGTCGC AATCTACAAC TGTTGGCTCT GAAAACACCG CGTTCAGCCA GTCTACCTTT
    CTACCAGAGA CCACAATCAA CCCCTTGAGA TTACCCGTTA ACTACGGTAT TCCGACTACT
    ACTCAAACTC CGACCACAAC AACGGTAGCA GCGGGAGTTT TCACTACGCA ATCTTCATCG
    CAATCATCTA AGGGTGATAG TACTGTCCAA GTAGTATCAT CACAACCCGC TTCTAACCAG
    CCTGGTTTTT CCGCGACTGG ATCTCCCGCG GGGATCCCCA TTTATGGTGG ATTCGTACCG
    ACTTTCATCA CGGGAACCAA CTTGGCTCCC AGCTACAGTA CCAGCATCTT GACATCCGGA
    TCCTTTAGGC CCGAAACATC GCCCACCCAT TTTGGGATAC CGATTCCCAC AGAATCGCAG
    CATAAACCGT CGGAATCAGT ACCTTCGATG CCAACGACGA CAACACCACC TCTTTCGTCT
    GTCTCACCGT CCAATCGACC GGGGGTTGCT CTAACACCAG CGGCAATCAC CCCGGTAGCT
    TTGCCAATTC AACCGTTACG ACCTGTTGCT CCCCTCGCAA CATCGATACA TCCGATCACC
    GCTCCTTTAC TGCCGAATCC CACTCAAGTG CATCCGGCGC AATCCATTCC TGTAACGTCC
    AGCGTGCAAC ACACGTATGG TGTGCAAACC GCTTTGATCA ATCCCATTCT TTATAAACCA
    GTTAAAGCTG TCTATCCGGT GTATTATTAT CCCGTGAATA TTCCCTATCA GCTGCAGAAA
    CCTGTTTCAC CGAGTTACCC TTGGAATTAC GCGCCTTCGT ATACGACGCA GACAGGATCG
    GCGAAAATAT GGAAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.