LOC100990972 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

The following LOC100990972 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC100990972 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa60954 XM_003805495.1
Latest version!
Pan paniscus uncharacterized LOC100990972 (LOC100990972), mRNA. pcDNA3.1-C-(k)DYK or customized vector 9-11 $258.30
$369.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa60954
    Clone ID Related Accession (Same CDS sequence) XM_003805495.1
    Accession Version XM_003805495.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1065bp)
    Protein sequence
    SNP
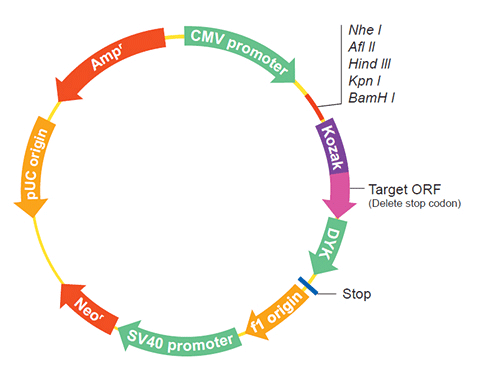
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product uncharacterized protein LOC100990972
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027879.1) annotated using gene prediction method: Gnomon, supported by mRNA evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 39% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    ATGCCCCCCT TTGAGGGCAC CCCAGTGACA TGGGCTTCCA TAGCTGTCTT CTGCCATGCC 
    CTCCAGAGTG CCACATGCCT GAGCATGGAG AACCCTCAGG ACTGCGGGAA TGAGACGCCT
    CGTGCAAAAG AAGAGCGAGA CCCACCAGGA TGCAGAGAGG GAAAGTCTAG GGAAGGACAT
    CTGGACTCTT CTTGGTCACT GAGCCTCAAC TCCACACATC TTGGGGATCT GCTGCCCCCA
    GAGCCAGGCA TCCGAAACCC CACAGTCTGC CTCCAAGCCA ATGATACCCT GGCCTTCCTG
    GTGACTCATG AGCATTACCC AGAGTATGAC CTGGGCCACT TCTATAACAC ACTGGAGCAA
    TTTGACTGGG GGTGCTTCCG GACCCTGGCT GAGGAGTCCC AGCTCTATGA GCAAAGCCTC
    AGCCTCTTTC TGCAGCATTT CCAACAGCCG GGCATTTATG TCTTTCGTCT GAGCAGCAAC
    CGACATCGGA AGATGATTCA GTGTCACAGC CTGAGCTGGG CTCGGAAGGC TGCTCCCCAC
    CCCACCTTCA GGAGACGTCA GCAGGAATGC AACCTCGATG CCTACACTTC CCCAAGAACT
    GGGATAATGT CAATAAGGAG AGGCCGATCT CACCAAGACT CTGACGCCCC CAGGGTTGAG
    GGGGGTCCTG GTGGGAGCTG GGAGGCTGAG GAGCAGGTAG ACCTGGAGTG GTTTGACACA
    GAGGCCTTCT TTGGAATCCT CCTCAGGCAG TCTCTGTCAG TGACAGCCAA ACTCAGCCAG
    ACGAAGGAAG AGCTCAAACT CCTCTACCTT AAACTTCTGG GTGAAGCCCG TTCTCTCCAG
    CAGCTGTGGG GAACAAGGCG CTGCCTCCCA GCCTCCGCTA ACCGGCTTCT AAGGAGCGTG
    CAGAGGGAGC AGCAGCAGGG CAGTTCCCCA GCTGGACACT GTGCTGGGCC ACCTGTCCCA
    GGTCGTGCTG CAGGAGGGCC ACCGTCTGAA GGCCTGGGGC ATTCTGGGCA CTGGCACTGG
    GGTGGAGCTA CTGCGGCCAG CCCCAGCAGG CCCTCCTGGT GCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003805543.1
    CDS1..1065
    Translation

    Target ORF information:

    RefSeq Version XM_003805495.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus uncharacterized LOC100990972 (LOC100990972), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003805495.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    ATGCCCCCCT TTGAGGGCAC CCCAGTGACA TGGGCTTCCA TAGCTGTCTT CTGCCATGCC 
    CTCCAGAGTG CCACATGCCT GAGCATGGAG AACCCTCAGG ACTGCGGGAA TGAGACGCCT
    CGTGCAAAAG AAGAGCGAGA CCCACCAGGA TGCAGAGAGG GAAAGTCTAG GGAAGGACAT
    CTGGACTCTT CTTGGTCACT GAGCCTCAAC TCCACACATC TTGGGGATCT GCTGCCCCCA
    GAGCCAGGCA TCCGAAACCC CACAGTCTGC CTCCAAGCCA ATGATACCCT GGCCTTCCTG
    GTGACTCATG AGCATTACCC AGAGTATGAC CTGGGCCACT TCTATAACAC ACTGGAGCAA
    TTTGACTGGG GGTGCTTCCG GACCCTGGCT GAGGAGTCCC AGCTCTATGA GCAAAGCCTC
    AGCCTCTTTC TGCAGCATTT CCAACAGCCG GGCATTTATG TCTTTCGTCT GAGCAGCAAC
    CGACATCGGA AGATGATTCA GTGTCACAGC CTGAGCTGGG CTCGGAAGGC TGCTCCCCAC
    CCCACCTTCA GGAGACGTCA GCAGGAATGC AACCTCGATG CCTACACTTC CCCAAGAACT
    GGGATAATGT CAATAAGGAG AGGCCGATCT CACCAAGACT CTGACGCCCC CAGGGTTGAG
    GGGGGTCCTG GTGGGAGCTG GGAGGCTGAG GAGCAGGTAG ACCTGGAGTG GTTTGACACA
    GAGGCCTTCT TTGGAATCCT CCTCAGGCAG TCTCTGTCAG TGACAGCCAA ACTCAGCCAG
    ACGAAGGAAG AGCTCAAACT CCTCTACCTT AAACTTCTGG GTGAAGCCCG TTCTCTCCAG
    CAGCTGTGGG GAACAAGGCG CTGCCTCCCA GCCTCCGCTA ACCGGCTTCT AAGGAGCGTG
    CAGAGGGAGC AGCAGCAGGG CAGTTCCCCA GCTGGACACT GTGCTGGGCC ACCTGTCCCA
    GGTCGTGCTG CAGGAGGGCC ACCGTCTGAA GGCCTGGGGC ATTCTGGGCA CTGGCACTGG
    GGTGGAGCTA CTGCGGCCAG CCCCAGCAGG CCCTCCTGGT GCTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.