ZNF185 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

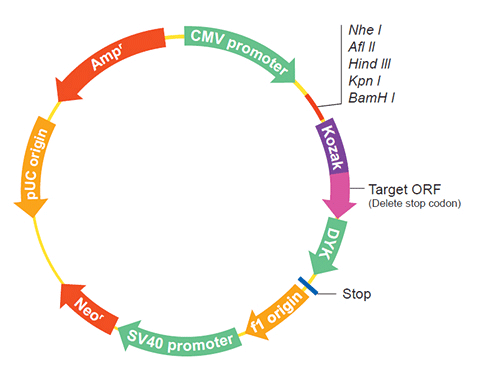
The following ZNF185 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ZNF185 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa453784 XM_024927343.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
OPa453785 XM_024927344.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X7, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $391.30
$559.00
OPa76590 XM_014343576.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76590 XM_014343575.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76591 XM_014343577.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76592 XM_014343578.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76593 XM_014343579.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76594 XM_014343580.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X8, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76595 XM_014343581.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X9, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76596 XM_003804964.3
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X10, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76597 XM_008965797.2
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X11, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76598 XM_014343582.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X12, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76599 XM_008965822.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X13, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $342.30
$489.00
OPa76600 XM_008965835.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X14, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $342.30
$489.00
OPa76601 XM_008965841.2
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X15, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $342.30
$489.00
OPa76602 XM_008965848.2
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X16, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $342.30
$489.00
OPa76603 XM_008965857.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X17, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $342.30
$489.00
OPa76604 XM_008965866.2
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X18, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $174.30
$249.00
OPa76605 XM_008965811.1
Latest version!
Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X19, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $342.30
$489.00
View Old Accession Versions >>
OPa76604 XM_008965866.1 Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X16, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $174.30
$249.00
OPa76601 XM_008965841.1 Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X13, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $342.30
$489.00
OPa76597 XM_008965797.1 Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X9, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPa76602 XM_008965848.1 Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X14, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $342.30
$489.00
OPa76596 XM_003804964.2 Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X8, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa453784
    Clone ID Related Accession (Same CDS sequence) XM_024927343.1
    Accession Version XM_024927343.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2133bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATGC CTCCGAGCAC AAGGGCTCCC
    ACTGGCTACA TCATCCGGGG AGTGTTCACC AAGCCCATAG ACAGCTCTTC CCAGCCCCAG
    CAGCAGTTCC CCAAGGCCAA TGGGACTCCA AAAAGTGCTG CCAGTCTGGT GAGAACAGCT
    AACACTGGTC CTCCCCGCCC CTCCTCCTCT GGCTACAAGA TGACCACTGA GGATTACAAG
    AAGCTGGCAC CCTACAATAT CAGGCGCAGC TCTACATCAG GGGACACCGA GGAGGAGGAG
    GAGGTGGTGC CTTTCTCCTC AGATGAACAG AAACGGAGGT CAGAGGCTGC AAGCAGTGTT
    CTGAGGAGGA CAGCTCCCCG GGAGCACTCC TACGTCCTGT CAGCGGCCAA GAAGAGCACT
    GGCAGTCCTA CCCAGGAGAC ACAGGCACCG TTTATCGCGA AGAGGGTGGA GGTGGTGGAA
    GAGGACGGGC CTTCTGAGAA GAGCCAGGAC CCACCTGCTC TGGCAAGATC CACTCCTGGC
    TCAAACAGTG CGGATGGAGG CAGGACCAAA GCATCTCGGG CAATTTGGAT AGAGTGCCTG
    CCAAGTATGC CTAGCCCCGC TGGGAGCCAG GAGCTCAGCT CAAGAGGTGA GGAAATTGTC
    CGCCTGCAGA TCCTGACACC CAGGGCAGGA CTCCGCCTGG TGGCCCCAGA CCTGGAAGGC
    ATGAGGTCTT CCCCAGGCAA CAAAGACAAG GAGGCCCCCT GCTCCAGAGA GCTCCAGAGG
    GACTTGGCTG GTGAGGAGGC TTTCAGGGGC CCCAACACAG ATGCTGCAAG GTCAAGTGCA
    CAGTTGAGTG ATGGCAATGT GGGATCCGGA GCCACGGGCT CCCGGCCTGA AGGCTTGGCT
    GCAGTAGACA TCGGCTCCGA GAGAGGAAGC TCCAGTGCCA CTTCAGTCTC TGCTGTCCCT
    GCTGATAGGA AGAGCAACAG CACAGCAGCC CAGGAGGATG CAAAGGCAGA CCCAAAGGGG
    GCCTTGGCTG ATTATGAGGG GAAGAATGTG GCCACCAGGG TCGGAGAGGC CTGGCAGGAG
    AGGCCTGGAG CTCCAAGAGG TGGCCAAGGA GACCCAGCTG TACCCACTCA GCAACCTGCA
    GATCCCAGCA CCCCAGAGCG GCAGAGCAGC CCCAGCGGAT CTGAGCAACT TGTCAGACGA
    GAGAGTTGTG GCAGCAGGAG AGTGCCACAG CCAGACTCGA GTCCAAAGAA GATCCCTCCA
    TTGCCCTGTG GAGGACCAGG CCAGGGGAGT ATACGACGAG ACAAGGCAGG AGGCCATATT
    GGAGACTGTT TGCTTACACC AGGGGCAAGC GTGTTGGCTG ATTTTGAGGG GAAGGATGTG
    GCCACCAAGG TCGGAGAGGC CTGGCAGGAC AGGCCTGGAG CCCCAAGAGG TGGCCAAGGA
    GACCCAGCTG TACCCACTCA GCAACCTGCA GATCCCAGCA CCCCAGAACA GCAGAACAGC
    CCCAGCGGAT CTGAGCAATT CGTCAGACGA GAGAGCTGCA CCAGCAGGGT GAGGAGCCCC
    TCGAGCTGCA TGGTCACTGT TACTGTCACT GCCACATCTG AGCAGCCTCA CATTTATATT
    CCAGCCCCCG CAAGTGAATT GGACTCCAGC TCTACCACCA AAGGGATTCT CTTCGTGAAG
    GAGTACGTGA ATGCTAGTGA AGTGTCTTCT GGGAAGCCAG TATCTGCACG CTATAGCAAC
    GTCAGCAGCA TTGAGGACTC ATTCGCCATG GAGAAGAAGC CTCCATGTGG CAGCACTCCA
    TACTCTGAGA GGACAACTGG AGGGATCTGT ACTTACTGCA ACCGTGAGAT CCGAGACTGT
    CCAAAGATTA CCCTAGAACA TCTTGGTATC TGCTGCCATG AATATTGCTT TAAGTGTGGG
    ATTTGCAGTA AACCGATGGG TGATCTCCTG GATCAGATCT TCATTCACCG TGACACCATT
    CACTGTGGGA AATGCTATGA AAAGCTCTTC TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_024783111.1
    CDS123..2255
    Translation

    Target ORF information:

    RefSeq Version XM_024927343.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_024927343.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATGC CTCCGAGCAC AAGGGCTCCC
    ACTGGCTACA TCATCCGGGG AGTGTTCACC AAGCCCATAG ACAGCTCTTC CCAGCCCCAG
    CAGCAGTTCC CCAAGGCCAA TGGGACTCCA AAAAGTGCTG CCAGTCTGGT GAGAACAGCT
    AACACTGGTC CTCCCCGCCC CTCCTCCTCT GGCTACAAGA TGACCACTGA GGATTACAAG
    AAGCTGGCAC CCTACAATAT CAGGCGCAGC TCTACATCAG GGGACACCGA GGAGGAGGAG
    GAGGTGGTGC CTTTCTCCTC AGATGAACAG AAACGGAGGT CAGAGGCTGC AAGCAGTGTT
    CTGAGGAGGA CAGCTCCCCG GGAGCACTCC TACGTCCTGT CAGCGGCCAA GAAGAGCACT
    GGCAGTCCTA CCCAGGAGAC ACAGGCACCG TTTATCGCGA AGAGGGTGGA GGTGGTGGAA
    GAGGACGGGC CTTCTGAGAA GAGCCAGGAC CCACCTGCTC TGGCAAGATC CACTCCTGGC
    TCAAACAGTG CGGATGGAGG CAGGACCAAA GCATCTCGGG CAATTTGGAT AGAGTGCCTG
    CCAAGTATGC CTAGCCCCGC TGGGAGCCAG GAGCTCAGCT CAAGAGGTGA GGAAATTGTC
    CGCCTGCAGA TCCTGACACC CAGGGCAGGA CTCCGCCTGG TGGCCCCAGA CCTGGAAGGC
    ATGAGGTCTT CCCCAGGCAA CAAAGACAAG GAGGCCCCCT GCTCCAGAGA GCTCCAGAGG
    GACTTGGCTG GTGAGGAGGC TTTCAGGGGC CCCAACACAG ATGCTGCAAG GTCAAGTGCA
    CAGTTGAGTG ATGGCAATGT GGGATCCGGA GCCACGGGCT CCCGGCCTGA AGGCTTGGCT
    GCAGTAGACA TCGGCTCCGA GAGAGGAAGC TCCAGTGCCA CTTCAGTCTC TGCTGTCCCT
    GCTGATAGGA AGAGCAACAG CACAGCAGCC CAGGAGGATG CAAAGGCAGA CCCAAAGGGG
    GCCTTGGCTG ATTATGAGGG GAAGAATGTG GCCACCAGGG TCGGAGAGGC CTGGCAGGAG
    AGGCCTGGAG CTCCAAGAGG TGGCCAAGGA GACCCAGCTG TACCCACTCA GCAACCTGCA
    GATCCCAGCA CCCCAGAGCG GCAGAGCAGC CCCAGCGGAT CTGAGCAACT TGTCAGACGA
    GAGAGTTGTG GCAGCAGGAG AGTGCCACAG CCAGACTCGA GTCCAAAGAA GATCCCTCCA
    TTGCCCTGTG GAGGACCAGG CCAGGGGAGT ATACGACGAG ACAAGGCAGG AGGCCATATT
    GGAGACTGTT TGCTTACACC AGGGGCAAGC GTGTTGGCTG ATTTTGAGGG GAAGGATGTG
    GCCACCAAGG TCGGAGAGGC CTGGCAGGAC AGGCCTGGAG CCCCAAGAGG TGGCCAAGGA
    GACCCAGCTG TACCCACTCA GCAACCTGCA GATCCCAGCA CCCCAGAACA GCAGAACAGC
    CCCAGCGGAT CTGAGCAATT CGTCAGACGA GAGAGCTGCA CCAGCAGGGT GAGGAGCCCC
    TCGAGCTGCA TGGTCACTGT TACTGTCACT GCCACATCTG AGCAGCCTCA CATTTATATT
    CCAGCCCCCG CAAGTGAATT GGACTCCAGC TCTACCACCA AAGGGATTCT CTTCGTGAAG
    GAGTACGTGA ATGCTAGTGA AGTGTCTTCT GGGAAGCCAG TATCTGCACG CTATAGCAAC
    GTCAGCAGCA TTGAGGACTC ATTCGCCATG GAGAAGAAGC CTCCATGTGG CAGCACTCCA
    TACTCTGAGA GGACAACTGG AGGGATCTGT ACTTACTGCA ACCGTGAGAT CCGAGACTGT
    CCAAAGATTA CCCTAGAACA TCTTGGTATC TGCTGCCATG AATATTGCTT TAAGTGTGGG
    ATTTGCAGTA AACCGATGGG TGATCTCCTG GATCAGATCT TCATTCACCG TGACACCATT
    CACTGTGGGA AATGCTATGA AAAGCTCTTC TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa453785
    Clone ID Related Accession (Same CDS sequence) XM_024927344.1
    Accession Version XM_024927344.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2109bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGGGCCT TGGCTGATTA TGAGGGGAAG
    AATGTGGCCA CCAGGGTCGG AGAGGCCTGG CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAGCGGCAG
    AGCAGCCCCA GCGGATCTGA GCAACTTGTC AGACGAGAGA GTTGTGGCAG CAGGAGAGTG
    CCACAGCCAG ACTCGAGTCC AAAGAAGATC CCTCCATTGC CCTGTGGAGG ACCAGGCCAG
    GGGAGTATAC GACGAGACAA GGCAGGAGGC CATATTGGAG ACTGTTTGCT TACACCAGGG
    GCAAGCGTGT TGGCTGATTT TGAGGGGAAG GATGTGGCCA CCAAGGTCGG AGAGGCCTGG
    CAGGACAGGC CTGGAGCCCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAACAGCAG AACAGCCCCA GCGGATCTGA GCAATTCGTC
    AGACGAGAGA GCTGCACCAG CAGGGTGAGG AGCCCCTCGA GCTGCATGGT CACTGTTACT
    GTCACTGCCA CATCTGAGCA GCCTCACATT TATATTCCAG CCCCCGCAAG TGAATTGGAC
    TCCAGCTCTA CCACCAAAGG GATTCTCTTC GTGAAGGAGT ACGTGAATGC TAGTGAAGTG
    TCTTCTGGGA AGCCAGTATC TGCACGCTAT AGCAACGTCA GCAGCATTGA GGACTCATTC
    GCCATGGAGA AGAAGCCTCC ATGTGGCAGC ACTCCATACT CTGAGAGGAC AACTGGAGGG
    ATCTGTACTT ACTGCAACCG TGAGATCCGA GACTGTCCAA AGATTACCCT AGAACATCTT
    GGTATCTGCT GCCATGAATA TTGCTTTAAG TGTGGGATTT GCAGTAAACC GATGGGTGAT
    CTCCTGGATC AGATCTTCAT TCACCGTGAC ACCATTCACT GTGGGAAATG CTATGAAAAG
    CTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_024783112.1
    CDS123..2231
    Translation

    Target ORF information:

    RefSeq Version XM_024927344.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X7, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_024927344.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGGGCCT TGGCTGATTA TGAGGGGAAG
    AATGTGGCCA CCAGGGTCGG AGAGGCCTGG CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAGCGGCAG
    AGCAGCCCCA GCGGATCTGA GCAACTTGTC AGACGAGAGA GTTGTGGCAG CAGGAGAGTG
    CCACAGCCAG ACTCGAGTCC AAAGAAGATC CCTCCATTGC CCTGTGGAGG ACCAGGCCAG
    GGGAGTATAC GACGAGACAA GGCAGGAGGC CATATTGGAG ACTGTTTGCT TACACCAGGG
    GCAAGCGTGT TGGCTGATTT TGAGGGGAAG GATGTGGCCA CCAAGGTCGG AGAGGCCTGG
    CAGGACAGGC CTGGAGCCCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAACAGCAG AACAGCCCCA GCGGATCTGA GCAATTCGTC
    AGACGAGAGA GCTGCACCAG CAGGGTGAGG AGCCCCTCGA GCTGCATGGT CACTGTTACT
    GTCACTGCCA CATCTGAGCA GCCTCACATT TATATTCCAG CCCCCGCAAG TGAATTGGAC
    TCCAGCTCTA CCACCAAAGG GATTCTCTTC GTGAAGGAGT ACGTGAATGC TAGTGAAGTG
    TCTTCTGGGA AGCCAGTATC TGCACGCTAT AGCAACGTCA GCAGCATTGA GGACTCATTC
    GCCATGGAGA AGAAGCCTCC ATGTGGCAGC ACTCCATACT CTGAGAGGAC AACTGGAGGG
    ATCTGTACTT ACTGCAACCG TGAGATCCGA GACTGTCCAA AGATTACCCT AGAACATCTT
    GGTATCTGCT GCCATGAATA TTGCTTTAAG TGTGGGATTT GCAGTAAACC GATGGGTGAT
    CTCCTGGATC AGATCTTCAT TCACCGTGAC ACCATTCACT GTGGGAAATG CTATGAAAAG
    CTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76590
    Clone ID Related Accession (Same CDS sequence) XM_014343575.1 , XM_014343576.1
    Accession Version XM_014343575.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2199bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGGAGAGTG CCACAGCCAG ACTCGAGTCC AAAGAAGATC
    CCTCCATTGC CCTGTGGAGG ACCAGGCCAG GGGAGTATAC GACGAGACAA GGCAGGAGGC
    CATATTGGAG ACTGTTTGCT TACACCAGGG GCAAGCGTGT TGGCTGATTT TGAGGGGAAG
    GATGTGGCCA CCAAGGTCGG AGAGGCCTGG CAGGACAGGC CTGGAGCCCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAACAGCAG
    AACAGCCCCA GCGGATCTGA GCAATTCGTC AGACGAGAGA GCTGCACCAG CAGGGTGAGG
    AGCCCCTCGA GCTGCATGGT CACTGTTACT GTCACTGCCA CATCTGAGCA GCCTCACATT
    TATATTCCAG CCCCCGCAAG TGAATTGGAC TCCAGCTCTA CCACCAAAGG GATTCTCTTC
    GTGAAGGAGT ACGTGAATGC TAGTGAAGTG TCTTCTGGGA AGCCAGTATC TGCACGCTAT
    AGCAACGTCA GCAGCATTGA GGACTCATTC GCCATGGAGA AGAAGCCTCC ATGTGGCAGC
    ACTCCATACT CTGAGAGGAC AACTGGAGGG ATCTGTACTT ACTGCAACCG TGAGATCCGA
    GACTGTCCAA AGATTACCCT AGAACATCTT GGTATCTGCT GCCATGAATA TTGCTTTAAG
    TGTGGGATTT GCAGTAAACC GATGGGTGAT CTCCTGGATC AGATCTTCAT TCACCGTGAC
    ACCATTCACT GTGGGAAATG CTATGAAAAG CTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014199061.1
    CDS123..2321
    Translation

    Target ORF information:

    RefSeq Version XM_014343575.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014343575.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGGAGAGTG CCACAGCCAG ACTCGAGTCC AAAGAAGATC
    CCTCCATTGC CCTGTGGAGG ACCAGGCCAG GGGAGTATAC GACGAGACAA GGCAGGAGGC
    CATATTGGAG ACTGTTTGCT TACACCAGGG GCAAGCGTGT TGGCTGATTT TGAGGGGAAG
    GATGTGGCCA CCAAGGTCGG AGAGGCCTGG CAGGACAGGC CTGGAGCCCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAACAGCAG
    AACAGCCCCA GCGGATCTGA GCAATTCGTC AGACGAGAGA GCTGCACCAG CAGGGTGAGG
    AGCCCCTCGA GCTGCATGGT CACTGTTACT GTCACTGCCA CATCTGAGCA GCCTCACATT
    TATATTCCAG CCCCCGCAAG TGAATTGGAC TCCAGCTCTA CCACCAAAGG GATTCTCTTC
    GTGAAGGAGT ACGTGAATGC TAGTGAAGTG TCTTCTGGGA AGCCAGTATC TGCACGCTAT
    AGCAACGTCA GCAGCATTGA GGACTCATTC GCCATGGAGA AGAAGCCTCC ATGTGGCAGC
    ACTCCATACT CTGAGAGGAC AACTGGAGGG ATCTGTACTT ACTGCAACCG TGAGATCCGA
    GACTGTCCAA AGATTACCCT AGAACATCTT GGTATCTGCT GCCATGAATA TTGCTTTAAG
    TGTGGGATTT GCAGTAAACC GATGGGTGAT CTCCTGGATC AGATCTTCAT TCACCGTGAC
    ACCATTCACT GTGGGAAATG CTATGAAAAG CTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76590
    Clone ID Related Accession (Same CDS sequence) XM_014343575.1 , XM_014343576.1
    Accession Version XM_014343576.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2199bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGGAGAGTG CCACAGCCAG ACTCGAGTCC AAAGAAGATC
    CCTCCATTGC CCTGTGGAGG ACCAGGCCAG GGGAGTATAC GACGAGACAA GGCAGGAGGC
    CATATTGGAG ACTGTTTGCT TACACCAGGG GCAAGCGTGT TGGCTGATTT TGAGGGGAAG
    GATGTGGCCA CCAAGGTCGG AGAGGCCTGG CAGGACAGGC CTGGAGCCCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAACAGCAG
    AACAGCCCCA GCGGATCTGA GCAATTCGTC AGACGAGAGA GCTGCACCAG CAGGGTGAGG
    AGCCCCTCGA GCTGCATGGT CACTGTTACT GTCACTGCCA CATCTGAGCA GCCTCACATT
    TATATTCCAG CCCCCGCAAG TGAATTGGAC TCCAGCTCTA CCACCAAAGG GATTCTCTTC
    GTGAAGGAGT ACGTGAATGC TAGTGAAGTG TCTTCTGGGA AGCCAGTATC TGCACGCTAT
    AGCAACGTCA GCAGCATTGA GGACTCATTC GCCATGGAGA AGAAGCCTCC ATGTGGCAGC
    ACTCCATACT CTGAGAGGAC AACTGGAGGG ATCTGTACTT ACTGCAACCG TGAGATCCGA
    GACTGTCCAA AGATTACCCT AGAACATCTT GGTATCTGCT GCCATGAATA TTGCTTTAAG
    TGTGGGATTT GCAGTAAACC GATGGGTGAT CTCCTGGATC AGATCTTCAT TCACCGTGAC
    ACCATTCACT GTGGGAAATG CTATGAAAAG CTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014199062.1
    CDS131..2329
    Translation

    Target ORF information:

    RefSeq Version XM_014343576.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014343576.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGGAGAGTG CCACAGCCAG ACTCGAGTCC AAAGAAGATC
    CCTCCATTGC CCTGTGGAGG ACCAGGCCAG GGGAGTATAC GACGAGACAA GGCAGGAGGC
    CATATTGGAG ACTGTTTGCT TACACCAGGG GCAAGCGTGT TGGCTGATTT TGAGGGGAAG
    GATGTGGCCA CCAAGGTCGG AGAGGCCTGG CAGGACAGGC CTGGAGCCCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAACAGCAG
    AACAGCCCCA GCGGATCTGA GCAATTCGTC AGACGAGAGA GCTGCACCAG CAGGGTGAGG
    AGCCCCTCGA GCTGCATGGT CACTGTTACT GTCACTGCCA CATCTGAGCA GCCTCACATT
    TATATTCCAG CCCCCGCAAG TGAATTGGAC TCCAGCTCTA CCACCAAAGG GATTCTCTTC
    GTGAAGGAGT ACGTGAATGC TAGTGAAGTG TCTTCTGGGA AGCCAGTATC TGCACGCTAT
    AGCAACGTCA GCAGCATTGA GGACTCATTC GCCATGGAGA AGAAGCCTCC ATGTGGCAGC
    ACTCCATACT CTGAGAGGAC AACTGGAGGG ATCTGTACTT ACTGCAACCG TGAGATCCGA
    GACTGTCCAA AGATTACCCT AGAACATCTT GGTATCTGCT GCCATGAATA TTGCTTTAAG
    TGTGGGATTT GCAGTAAACC GATGGGTGAT CTCCTGGATC AGATCTTCAT TCACCGTGAC
    ACCATTCACT GTGGGAAATG CTATGAAAAG CTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76591
    Clone ID Related Accession (Same CDS sequence) XM_014343577.1
    Accession Version XM_014343577.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2196bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GTGCGGATGG AGGCAGGACC AAAGCATCTC GGGCAATTTG GATAGAGTGC
    CTGCCAAGTA TGCCTAGCCC CGCTGGGAGC CAGGAGCTCA GCTCAAGAGG TGAGGAAATT
    GTCCGCCTGC AGATCCTGAC ACCCAGGGCA GGACTCCGCC TGGTGGCCCC AGACCTGGAA
    GGCATGAGGT CTTCCCCAGG CAACAAAGAC AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG
    AGGGACTTGG CTGGTGAGGA GGCTTTCAGG GGCCCCAACA CAGATGCTGC AAGGTCAAGT
    GCACAGTTGA GTGATGGCAA TGTGGGATCC GGAGCCACGG GCTCCCGGCC TGAAGGCTTG
    GCTGCAGTAG ACATCGGCTC CGAGAGAGGA AGCTCCAGTG CCACTTCAGT CTCTGCTGTC
    CCTGCTGATA GGAAGAGCAA CAGCACAGCA GCCCAGGAGG ATGCAAAGGC AGACCCAAAG
    GGGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG GAGAGTGCCA CAGCCAGACT CGAGTCCAAA GAAGATCCCT
    CCATTGCCCT GTGGAGGACC AGGCCAGGGG AGTATACGAC GAGACAAGGC AGGAGGCCAT
    ATTGGAGACT GTTTGCTTAC ACCAGGGGCA AGCGTGTTGG CTGATTTTGA GGGGAAGGAT
    GTGGCCACCA AGGTCGGAGA GGCCTGGCAG GACAGGCCTG GAGCCCCAAG AGGTGGCCAA
    GGAGACCCAG CTGTACCCAC TCAGCAACCT GCAGATCCCA GCACCCCAGA ACAGCAGAAC
    AGCCCCAGCG GATCTGAGCA ATTCGTCAGA CGAGAGAGCT GCACCAGCAG GGTGAGGAGC
    CCCTCGAGCT GCATGGTCAC TGTTACTGTC ACTGCCACAT CTGAGCAGCC TCACATTTAT
    ATTCCAGCCC CCGCAAGTGA ATTGGACTCC AGCTCTACCA CCAAAGGGAT TCTCTTCGTG
    AAGGAGTACG TGAATGCTAG TGAAGTGTCT TCTGGGAAGC CAGTATCTGC ACGCTATAGC
    AACGTCAGCA GCATTGAGGA CTCATTCGCC ATGGAGAAGA AGCCTCCATG TGGCAGCACT
    CCATACTCTG AGAGGACAAC TGGAGGGATC TGTACTTACT GCAACCGTGA GATCCGAGAC
    TGTCCAAAGA TTACCCTAGA ACATCTTGGT ATCTGCTGCC ATGAATATTG CTTTAAGTGT
    GGGATTTGCA GTAAACCGAT GGGTGATCTC CTGGATCAGA TCTTCATTCA CCGTGACACC
    ATTCACTGTG GGAAATGCTA TGAAAAGCTC TTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014199063.1
    CDS123..2318
    Translation

    Target ORF information:

    RefSeq Version XM_014343577.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014343577.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GTGCGGATGG AGGCAGGACC AAAGCATCTC GGGCAATTTG GATAGAGTGC
    CTGCCAAGTA TGCCTAGCCC CGCTGGGAGC CAGGAGCTCA GCTCAAGAGG TGAGGAAATT
    GTCCGCCTGC AGATCCTGAC ACCCAGGGCA GGACTCCGCC TGGTGGCCCC AGACCTGGAA
    GGCATGAGGT CTTCCCCAGG CAACAAAGAC AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG
    AGGGACTTGG CTGGTGAGGA GGCTTTCAGG GGCCCCAACA CAGATGCTGC AAGGTCAAGT
    GCACAGTTGA GTGATGGCAA TGTGGGATCC GGAGCCACGG GCTCCCGGCC TGAAGGCTTG
    GCTGCAGTAG ACATCGGCTC CGAGAGAGGA AGCTCCAGTG CCACTTCAGT CTCTGCTGTC
    CCTGCTGATA GGAAGAGCAA CAGCACAGCA GCCCAGGAGG ATGCAAAGGC AGACCCAAAG
    GGGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG GAGAGTGCCA CAGCCAGACT CGAGTCCAAA GAAGATCCCT
    CCATTGCCCT GTGGAGGACC AGGCCAGGGG AGTATACGAC GAGACAAGGC AGGAGGCCAT
    ATTGGAGACT GTTTGCTTAC ACCAGGGGCA AGCGTGTTGG CTGATTTTGA GGGGAAGGAT
    GTGGCCACCA AGGTCGGAGA GGCCTGGCAG GACAGGCCTG GAGCCCCAAG AGGTGGCCAA
    GGAGACCCAG CTGTACCCAC TCAGCAACCT GCAGATCCCA GCACCCCAGA ACAGCAGAAC
    AGCCCCAGCG GATCTGAGCA ATTCGTCAGA CGAGAGAGCT GCACCAGCAG GGTGAGGAGC
    CCCTCGAGCT GCATGGTCAC TGTTACTGTC ACTGCCACAT CTGAGCAGCC TCACATTTAT
    ATTCCAGCCC CCGCAAGTGA ATTGGACTCC AGCTCTACCA CCAAAGGGAT TCTCTTCGTG
    AAGGAGTACG TGAATGCTAG TGAAGTGTCT TCTGGGAAGC CAGTATCTGC ACGCTATAGC
    AACGTCAGCA GCATTGAGGA CTCATTCGCC ATGGAGAAGA AGCCTCCATG TGGCAGCACT
    CCATACTCTG AGAGGACAAC TGGAGGGATC TGTACTTACT GCAACCGTGA GATCCGAGAC
    TGTCCAAAGA TTACCCTAGA ACATCTTGGT ATCTGCTGCC ATGAATATTG CTTTAAGTGT
    GGGATTTGCA GTAAACCGAT GGGTGATCTC CTGGATCAGA TCTTCATTCA CCGTGACACC
    ATTCACTGTG GGAAATGCTA TGAAAAGCTC TTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76592
    Clone ID Related Accession (Same CDS sequence) XM_014343578.1
    Accession Version XM_014343578.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2115bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGCAGTCC TACCCAGGAG
    ACACAGGCAC CGTTTATCGC GAAGAGGGTG GAGGTGGTGG AAGAGGACGG GCCTTCTGAG
    AAGAGCCAGG ACCCACCTGC TCTGGCAAGA TCCACTCCTG GCTCAAACAG TGCGGATGGA
    GGCAGGACCA AAGCATCTCG GGCAATTTGG ATAGAGTGCC TGCCAAGTAT GCCTAGCCCC
    GCTGGGAGCC AGGAGCTCAG CTCAAGAGGT GAGGAAATTG TCCGCCTGCA GATCCTGACA
    CCCAGGGCAG GACTCCGCCT GGTGGCCCCA GACCTGGAAG GCATGAGGTC TTCCCCAGGC
    AACAAAGACA AGGAGGCCCC CTGCTCCAGA GAGCTCCAGA GGGACTTGGC TGGTGAGGAG
    GCTTTCAGGG GCCCCAACAC AGATGCTGCA AGGTCAAGTG CACAGTTGAG TGATGGCAAT
    GTGGGATCCG GAGCCACGGG CTCCCGGCCT GAAGGCTTGG CTGCAGTAGA CATCGGCTCC
    GAGAGAGGAA GCTCCAGTGC CACTTCAGTC TCTGCTGTCC CTGCTGATAG GAAGAGCAAC
    AGCACAGCAG CCCAGGAGGA TGCAAAGGCA GACCCAAAGG GGGCCTTGGC TGATTATGAG
    GGGAAGAATG TGGCCACCAG GGTCGGAGAG GCCTGGCAGG AGAGGCCTGG AGCTCCAAGA
    GGTGGCCAAG GAGACCCAGC TGTACCCACT CAGCAACCTG CAGATCCCAG CACCCCAGAG
    CGGCAGAGCA GCCCCAGCGG ATCTGAGCAA CTTGTCAGAC GAGAGAGTTG TGGCAGCAGG
    AGAGTGCCAC AGCCAGACTC GAGTCCAAAG AAGATCCCTC CATTGCCCTG TGGAGGACCA
    GGCCAGGGGA GTATACGACG AGACAAGGCA GGAGGCCATA TTGGAGACTG TTTGCTTACA
    CCAGGGGCAA GCGTGTTGGC TGATTTTGAG GGGAAGGATG TGGCCACCAA GGTCGGAGAG
    GCCTGGCAGG ACAGGCCTGG AGCCCCAAGA GGTGGCCAAG GAGACCCAGC TGTACCCACT
    CAGCAACCTG CAGATCCCAG CACCCCAGAA CAGCAGAACA GCCCCAGCGG ATCTGAGCAA
    TTCGTCAGAC GAGAGAGCTG CACCAGCAGG GTGAGGAGCC CCTCGAGCTG CATGGTCACT
    GTTACTGTCA CTGCCACATC TGAGCAGCCT CACATTTATA TTCCAGCCCC CGCAAGTGAA
    TTGGACTCCA GCTCTACCAC CAAAGGGATT CTCTTCGTGA AGGAGTACGT GAATGCTAGT
    GAAGTGTCTT CTGGGAAGCC AGTATCTGCA CGCTATAGCA ACGTCAGCAG CATTGAGGAC
    TCATTCGCCA TGGAGAAGAA GCCTCCATGT GGCAGCACTC CATACTCTGA GAGGACAACT
    GGAGGGATCT GTACTTACTG CAACCGTGAG ATCCGAGACT GTCCAAAGAT TACCCTAGAA
    CATCTTGGTA TCTGCTGCCA TGAATATTGC TTTAAGTGTG GGATTTGCAG TAAACCGATG
    GGTGATCTCC TGGATCAGAT CTTCATTCAC CGTGACACCA TTCACTGTGG GAAATGCTAT
    GAAAAGCTCT TCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014199064.1
    CDS123..2237
    Translation

    Target ORF information:

    RefSeq Version XM_014343578.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014343578.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGCAGTCC TACCCAGGAG
    ACACAGGCAC CGTTTATCGC GAAGAGGGTG GAGGTGGTGG AAGAGGACGG GCCTTCTGAG
    AAGAGCCAGG ACCCACCTGC TCTGGCAAGA TCCACTCCTG GCTCAAACAG TGCGGATGGA
    GGCAGGACCA AAGCATCTCG GGCAATTTGG ATAGAGTGCC TGCCAAGTAT GCCTAGCCCC
    GCTGGGAGCC AGGAGCTCAG CTCAAGAGGT GAGGAAATTG TCCGCCTGCA GATCCTGACA
    CCCAGGGCAG GACTCCGCCT GGTGGCCCCA GACCTGGAAG GCATGAGGTC TTCCCCAGGC
    AACAAAGACA AGGAGGCCCC CTGCTCCAGA GAGCTCCAGA GGGACTTGGC TGGTGAGGAG
    GCTTTCAGGG GCCCCAACAC AGATGCTGCA AGGTCAAGTG CACAGTTGAG TGATGGCAAT
    GTGGGATCCG GAGCCACGGG CTCCCGGCCT GAAGGCTTGG CTGCAGTAGA CATCGGCTCC
    GAGAGAGGAA GCTCCAGTGC CACTTCAGTC TCTGCTGTCC CTGCTGATAG GAAGAGCAAC
    AGCACAGCAG CCCAGGAGGA TGCAAAGGCA GACCCAAAGG GGGCCTTGGC TGATTATGAG
    GGGAAGAATG TGGCCACCAG GGTCGGAGAG GCCTGGCAGG AGAGGCCTGG AGCTCCAAGA
    GGTGGCCAAG GAGACCCAGC TGTACCCACT CAGCAACCTG CAGATCCCAG CACCCCAGAG
    CGGCAGAGCA GCCCCAGCGG ATCTGAGCAA CTTGTCAGAC GAGAGAGTTG TGGCAGCAGG
    AGAGTGCCAC AGCCAGACTC GAGTCCAAAG AAGATCCCTC CATTGCCCTG TGGAGGACCA
    GGCCAGGGGA GTATACGACG AGACAAGGCA GGAGGCCATA TTGGAGACTG TTTGCTTACA
    CCAGGGGCAA GCGTGTTGGC TGATTTTGAG GGGAAGGATG TGGCCACCAA GGTCGGAGAG
    GCCTGGCAGG ACAGGCCTGG AGCCCCAAGA GGTGGCCAAG GAGACCCAGC TGTACCCACT
    CAGCAACCTG CAGATCCCAG CACCCCAGAA CAGCAGAACA GCCCCAGCGG ATCTGAGCAA
    TTCGTCAGAC GAGAGAGCTG CACCAGCAGG GTGAGGAGCC CCTCGAGCTG CATGGTCACT
    GTTACTGTCA CTGCCACATC TGAGCAGCCT CACATTTATA TTCCAGCCCC CGCAAGTGAA
    TTGGACTCCA GCTCTACCAC CAAAGGGATT CTCTTCGTGA AGGAGTACGT GAATGCTAGT
    GAAGTGTCTT CTGGGAAGCC AGTATCTGCA CGCTATAGCA ACGTCAGCAG CATTGAGGAC
    TCATTCGCCA TGGAGAAGAA GCCTCCATGT GGCAGCACTC CATACTCTGA GAGGACAACT
    GGAGGGATCT GTACTTACTG CAACCGTGAG ATCCGAGACT GTCCAAAGAT TACCCTAGAA
    CATCTTGGTA TCTGCTGCCA TGAATATTGC TTTAAGTGTG GGATTTGCAG TAAACCGATG
    GGTGATCTCC TGGATCAGAT CTTCATTCAC CGTGACACCA TTCACTGTGG GAAATGCTAT
    GAAAAGCTCT TCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76593
    Clone ID Related Accession (Same CDS sequence) XM_014343579.1
    Accession Version XM_014343579.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2109bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGCTCAAG AGGTGAGGAA ATTGTCCGCC TGCAGATCCT GACACCCAGG
    GCAGGACTCC GCCTGGTGGC CCCAGACCTG GAAGGCATGA GGTCTTCCCC AGGCAACAAA
    GACAAGGAGG CCCCCTGCTC CAGAGAGCTC CAGAGGGACT TGGCTGGTGA GGAGGCTTTC
    AGGGGCCCCA ACACAGATGC TGCAAGGTCA AGTGCACAGT TGAGTGATGG CAATGTGGGA
    TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC TTGGCTGCAG TAGACATCGG CTCCGAGAGA
    GGAAGCTCCA GTGCCACTTC AGTCTCTGCT GTCCCTGCTG ATAGGAAGAG CAACAGCACA
    GCAGCCCAGG AGGATGCAAA GGCAGACCCA AAGGGGGCCT TGGCTGATTA TGAGGGGAAG
    AATGTGGCCA CCAGGGTCGG AGAGGCCTGG CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAGCGGCAG
    AGCAGCCCCA GCGGATCTGA GCAACTTGTC AGACGAGAGA GTTGTGGCAG CAGGAGAGTG
    CCACAGCCAG ACTCGAGTCC AAAGAAGATC CCTCCATTGC CCTGTGGAGG ACCAGGCCAG
    GGGAGTATAC GACGAGACAA GGCAGGAGGC CATATTGGAG ACTGTTTGCT TACACCAGGG
    GCAAGCGTGT TGGCTGATTT TGAGGGGAAG GATGTGGCCA CCAAGGTCGG AGAGGCCTGG
    CAGGACAGGC CTGGAGCCCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAACAGCAG AACAGCCCCA GCGGATCTGA GCAATTCGTC
    AGACGAGAGA GCTGCACCAG CAGGGTGAGG AGCCCCTCGA GCTGCATGGT CACTGTTACT
    GTCACTGCCA CATCTGAGCA GCCTCACATT TATATTCCAG CCCCCGCAAG TGAATTGGAC
    TCCAGCTCTA CCACCAAAGG GATTCTCTTC GTGAAGGAGT ACGTGAATGC TAGTGAAGTG
    TCTTCTGGGA AGCCAGTATC TGCACGCTAT AGCAACGTCA GCAGCATTGA GGACTCATTC
    GCCATGGAGA AGAAGCCTCC ATGTGGCAGC ACTCCATACT CTGAGAGGAC AACTGGAGGG
    ATCTGTACTT ACTGCAACCG TGAGATCCGA GACTGTCCAA AGATTACCCT AGAACATCTT
    GGTATCTGCT GCCATGAATA TTGCTTTAAG TGTGGGATTT GCAGTAAACC GATGGGTGAT
    CTCCTGGATC AGATCTTCAT TCACCGTGAC ACCATTCACT GTGGGAAATG CTATGAAAAG
    CTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014199065.1
    CDS123..2231
    Translation

    Target ORF information:

    RefSeq Version XM_014343579.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014343579.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGCTCAAG AGGTGAGGAA ATTGTCCGCC TGCAGATCCT GACACCCAGG
    GCAGGACTCC GCCTGGTGGC CCCAGACCTG GAAGGCATGA GGTCTTCCCC AGGCAACAAA
    GACAAGGAGG CCCCCTGCTC CAGAGAGCTC CAGAGGGACT TGGCTGGTGA GGAGGCTTTC
    AGGGGCCCCA ACACAGATGC TGCAAGGTCA AGTGCACAGT TGAGTGATGG CAATGTGGGA
    TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC TTGGCTGCAG TAGACATCGG CTCCGAGAGA
    GGAAGCTCCA GTGCCACTTC AGTCTCTGCT GTCCCTGCTG ATAGGAAGAG CAACAGCACA
    GCAGCCCAGG AGGATGCAAA GGCAGACCCA AAGGGGGCCT TGGCTGATTA TGAGGGGAAG
    AATGTGGCCA CCAGGGTCGG AGAGGCCTGG CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAGCGGCAG
    AGCAGCCCCA GCGGATCTGA GCAACTTGTC AGACGAGAGA GTTGTGGCAG CAGGAGAGTG
    CCACAGCCAG ACTCGAGTCC AAAGAAGATC CCTCCATTGC CCTGTGGAGG ACCAGGCCAG
    GGGAGTATAC GACGAGACAA GGCAGGAGGC CATATTGGAG ACTGTTTGCT TACACCAGGG
    GCAAGCGTGT TGGCTGATTT TGAGGGGAAG GATGTGGCCA CCAAGGTCGG AGAGGCCTGG
    CAGGACAGGC CTGGAGCCCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAACAGCAG AACAGCCCCA GCGGATCTGA GCAATTCGTC
    AGACGAGAGA GCTGCACCAG CAGGGTGAGG AGCCCCTCGA GCTGCATGGT CACTGTTACT
    GTCACTGCCA CATCTGAGCA GCCTCACATT TATATTCCAG CCCCCGCAAG TGAATTGGAC
    TCCAGCTCTA CCACCAAAGG GATTCTCTTC GTGAAGGAGT ACGTGAATGC TAGTGAAGTG
    TCTTCTGGGA AGCCAGTATC TGCACGCTAT AGCAACGTCA GCAGCATTGA GGACTCATTC
    GCCATGGAGA AGAAGCCTCC ATGTGGCAGC ACTCCATACT CTGAGAGGAC AACTGGAGGG
    ATCTGTACTT ACTGCAACCG TGAGATCCGA GACTGTCCAA AGATTACCCT AGAACATCTT
    GGTATCTGCT GCCATGAATA TTGCTTTAAG TGTGGGATTT GCAGTAAACC GATGGGTGAT
    CTCCTGGATC AGATCTTCAT TCACCGTGAC ACCATTCACT GTGGGAAATG CTATGAAAAG
    CTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76594
    Clone ID Related Accession (Same CDS sequence) XM_014343580.1
    Accession Version XM_014343580.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2106bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X7
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GCTCAAGAGG TGAGGAAATT GTCCGCCTGC AGATCCTGAC ACCCAGGGCA
    GGACTCCGCC TGGTGGCCCC AGACCTGGAA GGCATGAGGT CTTCCCCAGG CAACAAAGAC
    AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG AGGGACTTGG CTGGTGAGGA GGCTTTCAGG
    GGCCCCAACA CAGATGCTGC AAGGTCAAGT GCACAGTTGA GTGATGGCAA TGTGGGATCC
    GGAGCCACGG GCTCCCGGCC TGAAGGCTTG GCTGCAGTAG ACATCGGCTC CGAGAGAGGA
    AGCTCCAGTG CCACTTCAGT CTCTGCTGTC CCTGCTGATA GGAAGAGCAA CAGCACAGCA
    GCCCAGGAGG ATGCAAAGGC AGACCCAAAG GGGGCCTTGG CTGATTATGA GGGGAAGAAT
    GTGGCCACCA GGGTCGGAGA GGCCTGGCAG GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA
    GGAGACCCAG CTGTACCCAC TCAGCAACCT GCAGATCCCA GCACCCCAGA GCGGCAGAGC
    AGCCCCAGCG GATCTGAGCA ACTTGTCAGA CGAGAGAGTT GTGGCAGCAG GAGAGTGCCA
    CAGCCAGACT CGAGTCCAAA GAAGATCCCT CCATTGCCCT GTGGAGGACC AGGCCAGGGG
    AGTATACGAC GAGACAAGGC AGGAGGCCAT ATTGGAGACT GTTTGCTTAC ACCAGGGGCA
    AGCGTGTTGG CTGATTTTGA GGGGAAGGAT GTGGCCACCA AGGTCGGAGA GGCCTGGCAG
    GACAGGCCTG GAGCCCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA ACAGCAGAAC AGCCCCAGCG GATCTGAGCA ATTCGTCAGA
    CGAGAGAGCT GCACCAGCAG GGTGAGGAGC CCCTCGAGCT GCATGGTCAC TGTTACTGTC
    ACTGCCACAT CTGAGCAGCC TCACATTTAT ATTCCAGCCC CCGCAAGTGA ATTGGACTCC
    AGCTCTACCA CCAAAGGGAT TCTCTTCGTG AAGGAGTACG TGAATGCTAG TGAAGTGTCT
    TCTGGGAAGC CAGTATCTGC ACGCTATAGC AACGTCAGCA GCATTGAGGA CTCATTCGCC
    ATGGAGAAGA AGCCTCCATG TGGCAGCACT CCATACTCTG AGAGGACAAC TGGAGGGATC
    TGTACTTACT GCAACCGTGA GATCCGAGAC TGTCCAAAGA TTACCCTAGA ACATCTTGGT
    ATCTGCTGCC ATGAATATTG CTTTAAGTGT GGGATTTGCA GTAAACCGAT GGGTGATCTC
    CTGGATCAGA TCTTCATTCA CCGTGACACC ATTCACTGTG GGAAATGCTA TGAAAAGCTC
    TTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014199066.1
    CDS123..2228
    Translation

    Target ORF information:

    RefSeq Version XM_014343580.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X8, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014343580.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GCTCAAGAGG TGAGGAAATT GTCCGCCTGC AGATCCTGAC ACCCAGGGCA
    GGACTCCGCC TGGTGGCCCC AGACCTGGAA GGCATGAGGT CTTCCCCAGG CAACAAAGAC
    AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG AGGGACTTGG CTGGTGAGGA GGCTTTCAGG
    GGCCCCAACA CAGATGCTGC AAGGTCAAGT GCACAGTTGA GTGATGGCAA TGTGGGATCC
    GGAGCCACGG GCTCCCGGCC TGAAGGCTTG GCTGCAGTAG ACATCGGCTC CGAGAGAGGA
    AGCTCCAGTG CCACTTCAGT CTCTGCTGTC CCTGCTGATA GGAAGAGCAA CAGCACAGCA
    GCCCAGGAGG ATGCAAAGGC AGACCCAAAG GGGGCCTTGG CTGATTATGA GGGGAAGAAT
    GTGGCCACCA GGGTCGGAGA GGCCTGGCAG GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA
    GGAGACCCAG CTGTACCCAC TCAGCAACCT GCAGATCCCA GCACCCCAGA GCGGCAGAGC
    AGCCCCAGCG GATCTGAGCA ACTTGTCAGA CGAGAGAGTT GTGGCAGCAG GAGAGTGCCA
    CAGCCAGACT CGAGTCCAAA GAAGATCCCT CCATTGCCCT GTGGAGGACC AGGCCAGGGG
    AGTATACGAC GAGACAAGGC AGGAGGCCAT ATTGGAGACT GTTTGCTTAC ACCAGGGGCA
    AGCGTGTTGG CTGATTTTGA GGGGAAGGAT GTGGCCACCA AGGTCGGAGA GGCCTGGCAG
    GACAGGCCTG GAGCCCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA ACAGCAGAAC AGCCCCAGCG GATCTGAGCA ATTCGTCAGA
    CGAGAGAGCT GCACCAGCAG GGTGAGGAGC CCCTCGAGCT GCATGGTCAC TGTTACTGTC
    ACTGCCACAT CTGAGCAGCC TCACATTTAT ATTCCAGCCC CCGCAAGTGA ATTGGACTCC
    AGCTCTACCA CCAAAGGGAT TCTCTTCGTG AAGGAGTACG TGAATGCTAG TGAAGTGTCT
    TCTGGGAAGC CAGTATCTGC ACGCTATAGC AACGTCAGCA GCATTGAGGA CTCATTCGCC
    ATGGAGAAGA AGCCTCCATG TGGCAGCACT CCATACTCTG AGAGGACAAC TGGAGGGATC
    TGTACTTACT GCAACCGTGA GATCCGAGAC TGTCCAAAGA TTACCCTAGA ACATCTTGGT
    ATCTGCTGCC ATGAATATTG CTTTAAGTGT GGGATTTGCA GTAAACCGAT GGGTGATCTC
    CTGGATCAGA TCTTCATTCA CCGTGACACC ATTCACTGTG GGAAATGCTA TGAAAAGCTC
    TTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76595
    Clone ID Related Accession (Same CDS sequence) XM_014343581.1
    Accession Version XM_014343581.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2100bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X8
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGCTCC
    AGTGCCACTT CAGTCTCTGC TGTCCCTGCT GATAGGAAGA GCAACAGCAC AGCAGCCCAG
    GAGGATGCAA AGGCAGACCC AAAGGGGGCC TTGGCTGATT ATGAGGGGAA GAATGTGGCC
    ACCAGGGTCG GAGAGGCCTG GCAGGAGAGG CCTGGAGCTC CAAGAGGTGG CCAAGGAGAC
    CCAGCTGTAC CCACTCAGCA ACCTGCAGAT CCCAGCACCC CAGAGCGGCA GAGCAGCCCC
    AGCGGATCTG AGCAACTTGT CAGACGAGAG AGTTGTGGCA GCAGGAGAGT GCCACAGCCA
    GACTCGAGTC CAAAGAAGAT CCCTCCATTG CCCTGTGGAG GACCAGGCCA GGGGAGTATA
    CGACGAGACA AGGCAGGAGG CCATATTGGA GACTGTTTGC TTACACCAGG GGCAAGCGTG
    TTGGCTGATT TTGAGGGGAA GGATGTGGCC ACCAAGGTCG GAGAGGCCTG GCAGGACAGG
    CCTGGAGCCC CAAGAGGTGG CCAAGGAGAC CCAGCTGTAC CCACTCAGCA ACCTGCAGAT
    CCCAGCACCC CAGAACAGCA GAACAGCCCC AGCGGATCTG AGCAATTCGT CAGACGAGAG
    AGCTGCACCA GCAGGGTGAG GAGCCCCTCG AGCTGCATGG TCACTGTTAC TGTCACTGCC
    ACATCTGAGC AGCCTCACAT TTATATTCCA GCCCCCGCAA GTGAATTGGA CTCCAGCTCT
    ACCACCAAAG GGATTCTCTT CGTGAAGGAG TACGTGAATG CTAGTGAAGT GTCTTCTGGG
    AAGCCAGTAT CTGCACGCTA TAGCAACGTC AGCAGCATTG AGGACTCATT CGCCATGGAG
    AAGAAGCCTC CATGTGGCAG CACTCCATAC TCTGAGAGGA CAACTGGAGG GATCTGTACT
    TACTGCAACC GTGAGATCCG AGACTGTCCA AAGATTACCC TAGAACATCT TGGTATCTGC
    TGCCATGAAT ATTGCTTTAA GTGTGGGATT TGCAGTAAAC CGATGGGTGA TCTCCTGGAT
    CAGATCTTCA TTCACCGTGA CACCATTCAC TGTGGGAAAT GCTATGAAAA GCTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014199067.1
    CDS123..2222
    Translation

    Target ORF information:

    RefSeq Version XM_014343581.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X9, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014343581.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGCTCC
    AGTGCCACTT CAGTCTCTGC TGTCCCTGCT GATAGGAAGA GCAACAGCAC AGCAGCCCAG
    GAGGATGCAA AGGCAGACCC AAAGGGGGCC TTGGCTGATT ATGAGGGGAA GAATGTGGCC
    ACCAGGGTCG GAGAGGCCTG GCAGGAGAGG CCTGGAGCTC CAAGAGGTGG CCAAGGAGAC
    CCAGCTGTAC CCACTCAGCA ACCTGCAGAT CCCAGCACCC CAGAGCGGCA GAGCAGCCCC
    AGCGGATCTG AGCAACTTGT CAGACGAGAG AGTTGTGGCA GCAGGAGAGT GCCACAGCCA
    GACTCGAGTC CAAAGAAGAT CCCTCCATTG CCCTGTGGAG GACCAGGCCA GGGGAGTATA
    CGACGAGACA AGGCAGGAGG CCATATTGGA GACTGTTTGC TTACACCAGG GGCAAGCGTG
    TTGGCTGATT TTGAGGGGAA GGATGTGGCC ACCAAGGTCG GAGAGGCCTG GCAGGACAGG
    CCTGGAGCCC CAAGAGGTGG CCAAGGAGAC CCAGCTGTAC CCACTCAGCA ACCTGCAGAT
    CCCAGCACCC CAGAACAGCA GAACAGCCCC AGCGGATCTG AGCAATTCGT CAGACGAGAG
    AGCTGCACCA GCAGGGTGAG GAGCCCCTCG AGCTGCATGG TCACTGTTAC TGTCACTGCC
    ACATCTGAGC AGCCTCACAT TTATATTCCA GCCCCCGCAA GTGAATTGGA CTCCAGCTCT
    ACCACCAAAG GGATTCTCTT CGTGAAGGAG TACGTGAATG CTAGTGAAGT GTCTTCTGGG
    AAGCCAGTAT CTGCACGCTA TAGCAACGTC AGCAGCATTG AGGACTCATT CGCCATGGAG
    AAGAAGCCTC CATGTGGCAG CACTCCATAC TCTGAGAGGA CAACTGGAGG GATCTGTACT
    TACTGCAACC GTGAGATCCG AGACTGTCCA AAGATTACCC TAGAACATCT TGGTATCTGC
    TGCCATGAAT ATTGCTTTAA GTGTGGGATT TGCAGTAAAC CGATGGGTGA TCTCCTGGAT
    CAGATCTTCA TTCACCGTGA CACCATTCAC TGTGGGAAAT GCTATGAAAA GCTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76596
    Clone ID Related Accession (Same CDS sequence) XM_003804964.2 , XM_003804964.3
    Accession Version XM_003804964.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2067bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X7
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014477.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 2, 2014 this sequence version replaced XM_003804964.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGCGTGTTG GCTGATTTTG AGGGGAAGGA TGTGGCCACC
    AAGGTCGGAG AGGCCTGGCA GGACAGGCCT GGAGCCCCAA GAGGTGGCCA AGGAGACCCA
    GCTGTACCCA CTCAGCAACC TGCAGATCCC AGCACCCCAG AACAGCAGAA CAGCCCCAGC
    GGATCTGAGC AATTCGTCAG ACGAGAGAGC TGCACCAGCA GGGTGAGGAG CCCCTCGAGC
    TGCATGGTCA CTGTTACTGT CACTGCCACA TCTGAGCAGC CTCACATTTA TATTCCAGCC
    CCCGCAAGTG AATTGGACTC CAGCTCTACC ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC
    GTGAATGCTA GTGAAGTGTC TTCTGGGAAG CCAGTATCTG CACGCTATAG CAACGTCAGC
    AGCATTGAGG ACTCATTCGC CATGGAGAAG AAGCCTCCAT GTGGCAGCAC TCCATACTCT
    GAGAGGACAA CTGGAGGGAT CTGTACTTAC TGCAACCGTG AGATCCGAGA CTGTCCAAAG
    ATTACCCTAG AACATCTTGG TATCTGCTGC CATGAATATT GCTTTAAGTG TGGGATTTGC
    AGTAAACCGA TGGGTGATCT CCTGGATCAG ATCTTCATTC ACCGTGACAC CATTCACTGT
    GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003805012.1
    CDS123..2189
    Translation

    Target ORF information:

    RefSeq Version XM_003804964.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X8, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003804964.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGCGTGTTG GCTGATTTTG AGGGGAAGGA TGTGGCCACC
    AAGGTCGGAG AGGCCTGGCA GGACAGGCCT GGAGCCCCAA GAGGTGGCCA AGGAGACCCA
    GCTGTACCCA CTCAGCAACC TGCAGATCCC AGCACCCCAG AACAGCAGAA CAGCCCCAGC
    GGATCTGAGC AATTCGTCAG ACGAGAGAGC TGCACCAGCA GGGTGAGGAG CCCCTCGAGC
    TGCATGGTCA CTGTTACTGT CACTGCCACA TCTGAGCAGC CTCACATTTA TATTCCAGCC
    CCCGCAAGTG AATTGGACTC CAGCTCTACC ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC
    GTGAATGCTA GTGAAGTGTC TTCTGGGAAG CCAGTATCTG CACGCTATAG CAACGTCAGC
    AGCATTGAGG ACTCATTCGC CATGGAGAAG AAGCCTCCAT GTGGCAGCAC TCCATACTCT
    GAGAGGACAA CTGGAGGGAT CTGTACTTAC TGCAACCGTG AGATCCGAGA CTGTCCAAAG
    ATTACCCTAG AACATCTTGG TATCTGCTGC CATGAATATT GCTTTAAGTG TGGGATTTGC
    AGTAAACCGA TGGGTGATCT CCTGGATCAG ATCTTCATTC ACCGTGACAC CATTCACTGT
    GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76596
    Clone ID Related Accession (Same CDS sequence) XM_003804964.2 , XM_003804964.3
    Accession Version XM_003804964.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2067bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X9
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_003804964.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGCGTGTTG GCTGATTTTG AGGGGAAGGA TGTGGCCACC
    AAGGTCGGAG AGGCCTGGCA GGACAGGCCT GGAGCCCCAA GAGGTGGCCA AGGAGACCCA
    GCTGTACCCA CTCAGCAACC TGCAGATCCC AGCACCCCAG AACAGCAGAA CAGCCCCAGC
    GGATCTGAGC AATTCGTCAG ACGAGAGAGC TGCACCAGCA GGGTGAGGAG CCCCTCGAGC
    TGCATGGTCA CTGTTACTGT CACTGCCACA TCTGAGCAGC CTCACATTTA TATTCCAGCC
    CCCGCAAGTG AATTGGACTC CAGCTCTACC ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC
    GTGAATGCTA GTGAAGTGTC TTCTGGGAAG CCAGTATCTG CACGCTATAG CAACGTCAGC
    AGCATTGAGG ACTCATTCGC CATGGAGAAG AAGCCTCCAT GTGGCAGCAC TCCATACTCT
    GAGAGGACAA CTGGAGGGAT CTGTACTTAC TGCAACCGTG AGATCCGAGA CTGTCCAAAG
    ATTACCCTAG AACATCTTGG TATCTGCTGC CATGAATATT GCTTTAAGTG TGGGATTTGC
    AGTAAACCGA TGGGTGATCT CCTGGATCAG ATCTTCATTC ACCGTGACAC CATTCACTGT
    GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003805012.1
    CDS123..2189
    Translation

    Target ORF information:

    RefSeq Version XM_003804964.3
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X10, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003804964.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGTGCGGA TGGAGGCAGG ACCAAAGCAT CTCGGGCAAT TTGGATAGAG
    TGCCTGCCAA GTATGCCTAG CCCCGCTGGG AGCCAGGAGC TCAGCTCAAG AGGTGAGGAA
    ATTGTCCGCC TGCAGATCCT GACACCCAGG GCAGGACTCC GCCTGGTGGC CCCAGACCTG
    GAAGGCATGA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGCGTGTTG GCTGATTTTG AGGGGAAGGA TGTGGCCACC
    AAGGTCGGAG AGGCCTGGCA GGACAGGCCT GGAGCCCCAA GAGGTGGCCA AGGAGACCCA
    GCTGTACCCA CTCAGCAACC TGCAGATCCC AGCACCCCAG AACAGCAGAA CAGCCCCAGC
    GGATCTGAGC AATTCGTCAG ACGAGAGAGC TGCACCAGCA GGGTGAGGAG CCCCTCGAGC
    TGCATGGTCA CTGTTACTGT CACTGCCACA TCTGAGCAGC CTCACATTTA TATTCCAGCC
    CCCGCAAGTG AATTGGACTC CAGCTCTACC ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC
    GTGAATGCTA GTGAAGTGTC TTCTGGGAAG CCAGTATCTG CACGCTATAG CAACGTCAGC
    AGCATTGAGG ACTCATTCGC CATGGAGAAG AAGCCTCCAT GTGGCAGCAC TCCATACTCT
    GAGAGGACAA CTGGAGGGAT CTGTACTTAC TGCAACCGTG AGATCCGAGA CTGTCCAAAG
    ATTACCCTAG AACATCTTGG TATCTGCTGC CATGAATATT GCTTTAAGTG TGGGATTTGC
    AGTAAACCGA TGGGTGATCT CCTGGATCAG ATCTTCATTC ACCGTGACAC CATTCACTGT
    GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76597
    Clone ID Related Accession (Same CDS sequence) XM_008965797.2 , XM_008965797.1
    Accession Version XM_008965797.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2064bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X10
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008965797.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GTGCGGATGG AGGCAGGACC AAAGCATCTC GGGCAATTTG GATAGAGTGC
    CTGCCAAGTA TGCCTAGCCC CGCTGGGAGC CAGGAGCTCA GCTCAAGAGG TGAGGAAATT
    GTCCGCCTGC AGATCCTGAC ACCCAGGGCA GGACTCCGCC TGGTGGCCCC AGACCTGGAA
    GGCATGAGGT CTTCCCCAGG CAACAAAGAC AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG
    AGGGACTTGG CTGGTGAGGA GGCTTTCAGG GGCCCCAACA CAGATGCTGC AAGGTCAAGT
    GCACAGTTGA GTGATGGCAA TGTGGGATCC GGAGCCACGG GCTCCCGGCC TGAAGGCTTG
    GCTGCAGTAG ACATCGGCTC CGAGAGAGGA AGCTCCAGTG CCACTTCAGT CTCTGCTGTC
    CCTGCTGATA GGAAGAGCAA CAGCACAGCA GCCCAGGAGG ATGCAAAGGC AGACCCAAAG
    GGGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT GATTTTGAGG GGAAGGATGT GGCCACCAAG
    GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA GCCCCAAGAG GTGGCCAAGG AGACCCAGCT
    GTACCCACTC AGCAACCTGC AGATCCCAGC ACCCCAGAAC AGCAGAACAG CCCCAGCGGA
    TCTGAGCAAT TCGTCAGACG AGAGAGCTGC ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC
    ATGGTCACTG TTACTGTCAC TGCCACATCT GAGCAGCCTC ACATTTATAT TCCAGCCCCC
    GCAAGTGAAT TGGACTCCAG CTCTACCACC AAAGGGATTC TCTTCGTGAA GGAGTACGTG
    AATGCTAGTG AAGTGTCTTC TGGGAAGCCA GTATCTGCAC GCTATAGCAA CGTCAGCAGC
    ATTGAGGACT CATTCGCCAT GGAGAAGAAG CCTCCATGTG GCAGCACTCC ATACTCTGAG
    AGGACAACTG GAGGGATCTG TACTTACTGC AACCGTGAGA TCCGAGACTG TCCAAAGATT
    ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT GAATATTGCT TTAAGTGTGG GATTTGCAGT
    AAACCGATGG GTGATCTCCT GGATCAGATC TTCATTCACC GTGACACCAT TCACTGTGGG
    AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964045.1
    CDS123..2186
    Translation

    Target ORF information:

    RefSeq Version XM_008965797.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X11, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965797.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GTGCGGATGG AGGCAGGACC AAAGCATCTC GGGCAATTTG GATAGAGTGC
    CTGCCAAGTA TGCCTAGCCC CGCTGGGAGC CAGGAGCTCA GCTCAAGAGG TGAGGAAATT
    GTCCGCCTGC AGATCCTGAC ACCCAGGGCA GGACTCCGCC TGGTGGCCCC AGACCTGGAA
    GGCATGAGGT CTTCCCCAGG CAACAAAGAC AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG
    AGGGACTTGG CTGGTGAGGA GGCTTTCAGG GGCCCCAACA CAGATGCTGC AAGGTCAAGT
    GCACAGTTGA GTGATGGCAA TGTGGGATCC GGAGCCACGG GCTCCCGGCC TGAAGGCTTG
    GCTGCAGTAG ACATCGGCTC CGAGAGAGGA AGCTCCAGTG CCACTTCAGT CTCTGCTGTC
    CCTGCTGATA GGAAGAGCAA CAGCACAGCA GCCCAGGAGG ATGCAAAGGC AGACCCAAAG
    GGGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT GATTTTGAGG GGAAGGATGT GGCCACCAAG
    GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA GCCCCAAGAG GTGGCCAAGG AGACCCAGCT
    GTACCCACTC AGCAACCTGC AGATCCCAGC ACCCCAGAAC AGCAGAACAG CCCCAGCGGA
    TCTGAGCAAT TCGTCAGACG AGAGAGCTGC ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC
    ATGGTCACTG TTACTGTCAC TGCCACATCT GAGCAGCCTC ACATTTATAT TCCAGCCCCC
    GCAAGTGAAT TGGACTCCAG CTCTACCACC AAAGGGATTC TCTTCGTGAA GGAGTACGTG
    AATGCTAGTG AAGTGTCTTC TGGGAAGCCA GTATCTGCAC GCTATAGCAA CGTCAGCAGC
    ATTGAGGACT CATTCGCCAT GGAGAAGAAG CCTCCATGTG GCAGCACTCC ATACTCTGAG
    AGGACAACTG GAGGGATCTG TACTTACTGC AACCGTGAGA TCCGAGACTG TCCAAAGATT
    ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT GAATATTGCT TTAAGTGTGG GATTTGCAGT
    AAACCGATGG GTGATCTCCT GGATCAGATC TTCATTCACC GTGACACCAT TCACTGTGGG
    AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76597
    Clone ID Related Accession (Same CDS sequence) XM_008965797.2 , XM_008965797.1
    Accession Version XM_008965797.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2064bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X8
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014477.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GTGCGGATGG AGGCAGGACC AAAGCATCTC GGGCAATTTG GATAGAGTGC
    CTGCCAAGTA TGCCTAGCCC CGCTGGGAGC CAGGAGCTCA GCTCAAGAGG TGAGGAAATT
    GTCCGCCTGC AGATCCTGAC ACCCAGGGCA GGACTCCGCC TGGTGGCCCC AGACCTGGAA
    GGCATGAGGT CTTCCCCAGG CAACAAAGAC AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG
    AGGGACTTGG CTGGTGAGGA GGCTTTCAGG GGCCCCAACA CAGATGCTGC AAGGTCAAGT
    GCACAGTTGA GTGATGGCAA TGTGGGATCC GGAGCCACGG GCTCCCGGCC TGAAGGCTTG
    GCTGCAGTAG ACATCGGCTC CGAGAGAGGA AGCTCCAGTG CCACTTCAGT CTCTGCTGTC
    CCTGCTGATA GGAAGAGCAA CAGCACAGCA GCCCAGGAGG ATGCAAAGGC AGACCCAAAG
    GGGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT GATTTTGAGG GGAAGGATGT GGCCACCAAG
    GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA GCCCCAAGAG GTGGCCAAGG AGACCCAGCT
    GTACCCACTC AGCAACCTGC AGATCCCAGC ACCCCAGAAC AGCAGAACAG CCCCAGCGGA
    TCTGAGCAAT TCGTCAGACG AGAGAGCTGC ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC
    ATGGTCACTG TTACTGTCAC TGCCACATCT GAGCAGCCTC ACATTTATAT TCCAGCCCCC
    GCAAGTGAAT TGGACTCCAG CTCTACCACC AAAGGGATTC TCTTCGTGAA GGAGTACGTG
    AATGCTAGTG AAGTGTCTTC TGGGAAGCCA GTATCTGCAC GCTATAGCAA CGTCAGCAGC
    ATTGAGGACT CATTCGCCAT GGAGAAGAAG CCTCCATGTG GCAGCACTCC ATACTCTGAG
    AGGACAACTG GAGGGATCTG TACTTACTGC AACCGTGAGA TCCGAGACTG TCCAAAGATT
    ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT GAATATTGCT TTAAGTGTGG GATTTGCAGT
    AAACCGATGG GTGATCTCCT GGATCAGATC TTCATTCACC GTGACACCAT TCACTGTGGG
    AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964045.1
    CDS123..2186
    Translation

    Target ORF information:

    RefSeq Version XM_008965797.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X9, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965797.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GTGCGGATGG AGGCAGGACC AAAGCATCTC GGGCAATTTG GATAGAGTGC
    CTGCCAAGTA TGCCTAGCCC CGCTGGGAGC CAGGAGCTCA GCTCAAGAGG TGAGGAAATT
    GTCCGCCTGC AGATCCTGAC ACCCAGGGCA GGACTCCGCC TGGTGGCCCC AGACCTGGAA
    GGCATGAGGT CTTCCCCAGG CAACAAAGAC AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG
    AGGGACTTGG CTGGTGAGGA GGCTTTCAGG GGCCCCAACA CAGATGCTGC AAGGTCAAGT
    GCACAGTTGA GTGATGGCAA TGTGGGATCC GGAGCCACGG GCTCCCGGCC TGAAGGCTTG
    GCTGCAGTAG ACATCGGCTC CGAGAGAGGA AGCTCCAGTG CCACTTCAGT CTCTGCTGTC
    CCTGCTGATA GGAAGAGCAA CAGCACAGCA GCCCAGGAGG ATGCAAAGGC AGACCCAAAG
    GGGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT GATTTTGAGG GGAAGGATGT GGCCACCAAG
    GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA GCCCCAAGAG GTGGCCAAGG AGACCCAGCT
    GTACCCACTC AGCAACCTGC AGATCCCAGC ACCCCAGAAC AGCAGAACAG CCCCAGCGGA
    TCTGAGCAAT TCGTCAGACG AGAGAGCTGC ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC
    ATGGTCACTG TTACTGTCAC TGCCACATCT GAGCAGCCTC ACATTTATAT TCCAGCCCCC
    GCAAGTGAAT TGGACTCCAG CTCTACCACC AAAGGGATTC TCTTCGTGAA GGAGTACGTG
    AATGCTAGTG AAGTGTCTTC TGGGAAGCCA GTATCTGCAC GCTATAGCAA CGTCAGCAGC
    ATTGAGGACT CATTCGCCAT GGAGAAGAAG CCTCCATGTG GCAGCACTCC ATACTCTGAG
    AGGACAACTG GAGGGATCTG TACTTACTGC AACCGTGAGA TCCGAGACTG TCCAAAGATT
    ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT GAATATTGCT TTAAGTGTGG GATTTGCAGT
    AAACCGATGG GTGATCTCCT GGATCAGATC TTCATTCACC GTGACACCAT TCACTGTGGG
    AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76598
    Clone ID Related Accession (Same CDS sequence) XM_014343582.1
    Accession Version XM_014343582.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2022bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X11
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGGTCTTC CCCAGGCAAC AAAGACAAGG AGGCCCCCTG CTCCAGAGAG
    CTCCAGAGGG ACTTGGCTGG TGAGGAGGCT TTCAGGGGCC CCAACACAGA TGCTGCAAGG
    TCAAGTGCAC AGTTGAGTGA TGGCAATGTG GGATCCGGAG CCACGGGCTC CCGGCCTGAA
    GGCTTGGCTG CAGTAGACAT CGGCTCCGAG AGAGGAAGCT CCAGTGCCAC TTCAGTCTCT
    GCTGTCCCTG CTGATAGGAA GAGCAACAGC ACAGCAGCCC AGGAGGATGC AAAGGCAGAC
    CCAAAGGGGG CCTTGGCTGA TTATGAGGGG AAGAATGTGG CCACCAGGGT CGGAGAGGCC
    TGGCAGGAGA GGCCTGGAGC TCCAAGAGGT GGCCAAGGAG ACCCAGCTGT ACCCACTCAG
    CAACCTGCAG ATCCCAGCAC CCCAGAGCGG CAGAGCAGCC CCAGCGGATC TGAGCAACTT
    GTCAGACGAG AGAGTTGTGG CAGCAGGAGA GTGCCACAGC CAGACTCGAG TCCAAAGAAG
    ATCCCTCCAT TGCCCTGTGG AGGACCAGGC CAGGGGAGTA TACGACGAGA CAAGGCAGGA
    GGCCATATTG GAGACTGTTT GCTTACACCA GGGGCAAGCG TGTTGGCTGA TTTTGAGGGG
    AAGGATGTGG CCACCAAGGT CGGAGAGGCC TGGCAGGACA GGCCTGGAGC CCCAAGAGGT
    GGCCAAGGAG ACCCAGCTGT ACCCACTCAG CAACCTGCAG ATCCCAGCAC CCCAGAACAG
    CAGAACAGCC CCAGCGGATC TGAGCAATTC GTCAGACGAG AGAGCTGCAC CAGCAGGGTG
    AGGAGCCCCT CGAGCTGCAT GGTCACTGTT ACTGTCACTG CCACATCTGA GCAGCCTCAC
    ATTTATATTC CAGCCCCCGC AAGTGAATTG GACTCCAGCT CTACCACCAA AGGGATTCTC
    TTCGTGAAGG AGTACGTGAA TGCTAGTGAA GTGTCTTCTG GGAAGCCAGT ATCTGCACGC
    TATAGCAACG TCAGCAGCAT TGAGGACTCA TTCGCCATGG AGAAGAAGCC TCCATGTGGC
    AGCACTCCAT ACTCTGAGAG GACAACTGGA GGGATCTGTA CTTACTGCAA CCGTGAGATC
    CGAGACTGTC CAAAGATTAC CCTAGAACAT CTTGGTATCT GCTGCCATGA ATATTGCTTT
    AAGTGTGGGA TTTGCAGTAA ACCGATGGGT GATCTCCTGG ATCAGATCTT CATTCACCGT
    GACACCATTC ACTGTGGGAA ATGCTATGAA AAGCTCTTCT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014199068.1
    CDS123..2144
    Translation

    Target ORF information:

    RefSeq Version XM_014343582.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X12, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014343582.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGGTCTTC CCCAGGCAAC AAAGACAAGG AGGCCCCCTG CTCCAGAGAG
    CTCCAGAGGG ACTTGGCTGG TGAGGAGGCT TTCAGGGGCC CCAACACAGA TGCTGCAAGG
    TCAAGTGCAC AGTTGAGTGA TGGCAATGTG GGATCCGGAG CCACGGGCTC CCGGCCTGAA
    GGCTTGGCTG CAGTAGACAT CGGCTCCGAG AGAGGAAGCT CCAGTGCCAC TTCAGTCTCT
    GCTGTCCCTG CTGATAGGAA GAGCAACAGC ACAGCAGCCC AGGAGGATGC AAAGGCAGAC
    CCAAAGGGGG CCTTGGCTGA TTATGAGGGG AAGAATGTGG CCACCAGGGT CGGAGAGGCC
    TGGCAGGAGA GGCCTGGAGC TCCAAGAGGT GGCCAAGGAG ACCCAGCTGT ACCCACTCAG
    CAACCTGCAG ATCCCAGCAC CCCAGAGCGG CAGAGCAGCC CCAGCGGATC TGAGCAACTT
    GTCAGACGAG AGAGTTGTGG CAGCAGGAGA GTGCCACAGC CAGACTCGAG TCCAAAGAAG
    ATCCCTCCAT TGCCCTGTGG AGGACCAGGC CAGGGGAGTA TACGACGAGA CAAGGCAGGA
    GGCCATATTG GAGACTGTTT GCTTACACCA GGGGCAAGCG TGTTGGCTGA TTTTGAGGGG
    AAGGATGTGG CCACCAAGGT CGGAGAGGCC TGGCAGGACA GGCCTGGAGC CCCAAGAGGT
    GGCCAAGGAG ACCCAGCTGT ACCCACTCAG CAACCTGCAG ATCCCAGCAC CCCAGAACAG
    CAGAACAGCC CCAGCGGATC TGAGCAATTC GTCAGACGAG AGAGCTGCAC CAGCAGGGTG
    AGGAGCCCCT CGAGCTGCAT GGTCACTGTT ACTGTCACTG CCACATCTGA GCAGCCTCAC
    ATTTATATTC CAGCCCCCGC AAGTGAATTG GACTCCAGCT CTACCACCAA AGGGATTCTC
    TTCGTGAAGG AGTACGTGAA TGCTAGTGAA GTGTCTTCTG GGAAGCCAGT ATCTGCACGC
    TATAGCAACG TCAGCAGCAT TGAGGACTCA TTCGCCATGG AGAAGAAGCC TCCATGTGGC
    AGCACTCCAT ACTCTGAGAG GACAACTGGA GGGATCTGTA CTTACTGCAA CCGTGAGATC
    CGAGACTGTC CAAAGATTAC CCTAGAACAT CTTGGTATCT GCTGCCATGA ATATTGCTTT
    AAGTGTGGGA TTTGCAGTAA ACCGATGGGT GATCTCCTGG ATCAGATCTT CATTCACCGT
    GACACCATTC ACTGTGGGAA ATGCTATGAA AAGCTCTTCT AG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76599
    Clone ID Related Accession (Same CDS sequence) XM_008965822.1
    Accession Version XM_008965822.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1974bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X12
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GCTCAAGAGG TGAGGAAATT GTCCGCCTGC AGATCCTGAC ACCCAGGGCA
    GGACTCCGCC TGGTGGCCCC AGACCTGGAA GGCATGAGGT CTTCCCCAGG CAACAAAGAC
    AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG AGGGACTTGG CTGGTGAGGA GGCTTTCAGG
    GGCCCCAACA CAGATGCTGC AAGGTCAAGT GCACAGTTGA GTGATGGCAA TGTGGGATCC
    GGAGCCACGG GCTCCCGGCC TGAAGGCTTG GCTGCAGTAG ACATCGGCTC CGAGAGAGGA
    AGCTCCAGTG CCACTTCAGT CTCTGCTGTC CCTGCTGATA GGAAGAGCAA CAGCACAGCA
    GCCCAGGAGG ATGCAAAGGC AGACCCAAAG GGGGCCTTGG CTGATTATGA GGGGAAGAAT
    GTGGCCACCA GGGTCGGAGA GGCCTGGCAG GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA
    GGAGACCCAG CTGTACCCAC TCAGCAACCT GCAGATCCCA GCACCCCAGA GCGGCAGAGC
    AGCCCCAGCG GATCTGAGCA ACTTGTCAGA CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT
    GATTTTGAGG GGAAGGATGT GGCCACCAAG GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA
    GCCCCAAGAG GTGGCCAAGG AGACCCAGCT GTACCCACTC AGCAACCTGC AGATCCCAGC
    ACCCCAGAAC AGCAGAACAG CCCCAGCGGA TCTGAGCAAT TCGTCAGACG AGAGAGCTGC
    ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC ATGGTCACTG TTACTGTCAC TGCCACATCT
    GAGCAGCCTC ACATTTATAT TCCAGCCCCC GCAAGTGAAT TGGACTCCAG CTCTACCACC
    AAAGGGATTC TCTTCGTGAA GGAGTACGTG AATGCTAGTG AAGTGTCTTC TGGGAAGCCA
    GTATCTGCAC GCTATAGCAA CGTCAGCAGC ATTGAGGACT CATTCGCCAT GGAGAAGAAG
    CCTCCATGTG GCAGCACTCC ATACTCTGAG AGGACAACTG GAGGGATCTG TACTTACTGC
    AACCGTGAGA TCCGAGACTG TCCAAAGATT ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT
    GAATATTGCT TTAAGTGTGG GATTTGCAGT AAACCGATGG GTGATCTCCT GGATCAGATC
    TTCATTCACC GTGACACCAT TCACTGTGGG AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964070.1
    CDS123..2096
    Translation

    Target ORF information:

    RefSeq Version XM_008965822.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X13, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965822.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GCTCAAGAGG TGAGGAAATT GTCCGCCTGC AGATCCTGAC ACCCAGGGCA
    GGACTCCGCC TGGTGGCCCC AGACCTGGAA GGCATGAGGT CTTCCCCAGG CAACAAAGAC
    AAGGAGGCCC CCTGCTCCAG AGAGCTCCAG AGGGACTTGG CTGGTGAGGA GGCTTTCAGG
    GGCCCCAACA CAGATGCTGC AAGGTCAAGT GCACAGTTGA GTGATGGCAA TGTGGGATCC
    GGAGCCACGG GCTCCCGGCC TGAAGGCTTG GCTGCAGTAG ACATCGGCTC CGAGAGAGGA
    AGCTCCAGTG CCACTTCAGT CTCTGCTGTC CCTGCTGATA GGAAGAGCAA CAGCACAGCA
    GCCCAGGAGG ATGCAAAGGC AGACCCAAAG GGGGCCTTGG CTGATTATGA GGGGAAGAAT
    GTGGCCACCA GGGTCGGAGA GGCCTGGCAG GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA
    GGAGACCCAG CTGTACCCAC TCAGCAACCT GCAGATCCCA GCACCCCAGA GCGGCAGAGC
    AGCCCCAGCG GATCTGAGCA ACTTGTCAGA CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT
    GATTTTGAGG GGAAGGATGT GGCCACCAAG GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA
    GCCCCAAGAG GTGGCCAAGG AGACCCAGCT GTACCCACTC AGCAACCTGC AGATCCCAGC
    ACCCCAGAAC AGCAGAACAG CCCCAGCGGA TCTGAGCAAT TCGTCAGACG AGAGAGCTGC
    ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC ATGGTCACTG TTACTGTCAC TGCCACATCT
    GAGCAGCCTC ACATTTATAT TCCAGCCCCC GCAAGTGAAT TGGACTCCAG CTCTACCACC
    AAAGGGATTC TCTTCGTGAA GGAGTACGTG AATGCTAGTG AAGTGTCTTC TGGGAAGCCA
    GTATCTGCAC GCTATAGCAA CGTCAGCAGC ATTGAGGACT CATTCGCCAT GGAGAAGAAG
    CCTCCATGTG GCAGCACTCC ATACTCTGAG AGGACAACTG GAGGGATCTG TACTTACTGC
    AACCGTGAGA TCCGAGACTG TCCAAAGATT ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT
    GAATATTGCT TTAAGTGTGG GATTTGCAGT AAACCGATGG GTGATCTCCT GGATCAGATC
    TTCATTCACC GTGACACCAT TCACTGTGGG AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76600
    Clone ID Related Accession (Same CDS sequence) XM_008965835.1
    Accession Version XM_008965835.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1890bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X13
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGGTCTTC CCCAGGCAAC AAAGACAAGG AGGCCCCCTG CTCCAGAGAG
    CTCCAGAGGG ACTTGGCTGG TGAGGAGGCT TTCAGGGGCC CCAACACAGA TGCTGCAAGG
    TCAAGTGCAC AGTTGAGTGA TGGCAATGTG GGATCCGGAG CCACGGGCTC CCGGCCTGAA
    GGCTTGGCTG CAGTAGACAT CGGCTCCGAG AGAGGAAGCT CCAGTGCCAC TTCAGTCTCT
    GCTGTCCCTG CTGATAGGAA GAGCAACAGC ACAGCAGCCC AGGAGGATGC AAAGGCAGAC
    CCAAAGGGGG CCTTGGCTGA TTATGAGGGG AAGAATGTGG CCACCAGGGT CGGAGAGGCC
    TGGCAGGAGA GGCCTGGAGC TCCAAGAGGT GGCCAAGGAG ACCCAGCTGT ACCCACTCAG
    CAACCTGCAG ATCCCAGCAC CCCAGAGCGG CAGAGCAGCC CCAGCGGATC TGAGCAACTT
    GTCAGACGAG AGAGTTGTGG CAGCAGCGTG TTGGCTGATT TTGAGGGGAA GGATGTGGCC
    ACCAAGGTCG GAGAGGCCTG GCAGGACAGG CCTGGAGCCC CAAGAGGTGG CCAAGGAGAC
    CCAGCTGTAC CCACTCAGCA ACCTGCAGAT CCCAGCACCC CAGAACAGCA GAACAGCCCC
    AGCGGATCTG AGCAATTCGT CAGACGAGAG AGCTGCACCA GCAGGGTGAG GAGCCCCTCG
    AGCTGCATGG TCACTGTTAC TGTCACTGCC ACATCTGAGC AGCCTCACAT TTATATTCCA
    GCCCCCGCAA GTGAATTGGA CTCCAGCTCT ACCACCAAAG GGATTCTCTT CGTGAAGGAG
    TACGTGAATG CTAGTGAAGT GTCTTCTGGG AAGCCAGTAT CTGCACGCTA TAGCAACGTC
    AGCAGCATTG AGGACTCATT CGCCATGGAG AAGAAGCCTC CATGTGGCAG CACTCCATAC
    TCTGAGAGGA CAACTGGAGG GATCTGTACT TACTGCAACC GTGAGATCCG AGACTGTCCA
    AAGATTACCC TAGAACATCT TGGTATCTGC TGCCATGAAT ATTGCTTTAA GTGTGGGATT
    TGCAGTAAAC CGATGGGTGA TCTCCTGGAT CAGATCTTCA TTCACCGTGA CACCATTCAC
    TGTGGGAAAT GCTATGAAAA GCTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964083.1
    CDS123..2012
    Translation

    Target ORF information:

    RefSeq Version XM_008965835.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X14, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965835.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGGTCTTC CCCAGGCAAC AAAGACAAGG AGGCCCCCTG CTCCAGAGAG
    CTCCAGAGGG ACTTGGCTGG TGAGGAGGCT TTCAGGGGCC CCAACACAGA TGCTGCAAGG
    TCAAGTGCAC AGTTGAGTGA TGGCAATGTG GGATCCGGAG CCACGGGCTC CCGGCCTGAA
    GGCTTGGCTG CAGTAGACAT CGGCTCCGAG AGAGGAAGCT CCAGTGCCAC TTCAGTCTCT
    GCTGTCCCTG CTGATAGGAA GAGCAACAGC ACAGCAGCCC AGGAGGATGC AAAGGCAGAC
    CCAAAGGGGG CCTTGGCTGA TTATGAGGGG AAGAATGTGG CCACCAGGGT CGGAGAGGCC
    TGGCAGGAGA GGCCTGGAGC TCCAAGAGGT GGCCAAGGAG ACCCAGCTGT ACCCACTCAG
    CAACCTGCAG ATCCCAGCAC CCCAGAGCGG CAGAGCAGCC CCAGCGGATC TGAGCAACTT
    GTCAGACGAG AGAGTTGTGG CAGCAGCGTG TTGGCTGATT TTGAGGGGAA GGATGTGGCC
    ACCAAGGTCG GAGAGGCCTG GCAGGACAGG CCTGGAGCCC CAAGAGGTGG CCAAGGAGAC
    CCAGCTGTAC CCACTCAGCA ACCTGCAGAT CCCAGCACCC CAGAACAGCA GAACAGCCCC
    AGCGGATCTG AGCAATTCGT CAGACGAGAG AGCTGCACCA GCAGGGTGAG GAGCCCCTCG
    AGCTGCATGG TCACTGTTAC TGTCACTGCC ACATCTGAGC AGCCTCACAT TTATATTCCA
    GCCCCCGCAA GTGAATTGGA CTCCAGCTCT ACCACCAAAG GGATTCTCTT CGTGAAGGAG
    TACGTGAATG CTAGTGAAGT GTCTTCTGGG AAGCCAGTAT CTGCACGCTA TAGCAACGTC
    AGCAGCATTG AGGACTCATT CGCCATGGAG AAGAAGCCTC CATGTGGCAG CACTCCATAC
    TCTGAGAGGA CAACTGGAGG GATCTGTACT TACTGCAACC GTGAGATCCG AGACTGTCCA
    AAGATTACCC TAGAACATCT TGGTATCTGC TGCCATGAAT ATTGCTTTAA GTGTGGGATT
    TGCAGTAAAC CGATGGGTGA TCTCCTGGAT CAGATCTTCA TTCACCGTGA CACCATTCAC
    TGTGGGAAAT GCTATGAAAA GCTCTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76601
    Clone ID Related Accession (Same CDS sequence) XM_008965841.2 , XM_008965841.1
    Accession Version XM_008965841.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1887bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X14
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008965841.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGCGTGTTG GCTGATTTTG AGGGGAAGGA TGTGGCCACC
    AAGGTCGGAG AGGCCTGGCA GGACAGGCCT GGAGCCCCAA GAGGTGGCCA AGGAGACCCA
    GCTGTACCCA CTCAGCAACC TGCAGATCCC AGCACCCCAG AACAGCAGAA CAGCCCCAGC
    GGATCTGAGC AATTCGTCAG ACGAGAGAGC TGCACCAGCA GGGTGAGGAG CCCCTCGAGC
    TGCATGGTCA CTGTTACTGT CACTGCCACA TCTGAGCAGC CTCACATTTA TATTCCAGCC
    CCCGCAAGTG AATTGGACTC CAGCTCTACC ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC
    GTGAATGCTA GTGAAGTGTC TTCTGGGAAG CCAGTATCTG CACGCTATAG CAACGTCAGC
    AGCATTGAGG ACTCATTCGC CATGGAGAAG AAGCCTCCAT GTGGCAGCAC TCCATACTCT
    GAGAGGACAA CTGGAGGGAT CTGTACTTAC TGCAACCGTG AGATCCGAGA CTGTCCAAAG
    ATTACCCTAG AACATCTTGG TATCTGCTGC CATGAATATT GCTTTAAGTG TGGGATTTGC
    AGTAAACCGA TGGGTGATCT CCTGGATCAG ATCTTCATTC ACCGTGACAC CATTCACTGT
    GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964089.1
    CDS123..2009
    Translation

    Target ORF information:

    RefSeq Version XM_008965841.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X15, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965841.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGCGTGTTG GCTGATTTTG AGGGGAAGGA TGTGGCCACC
    AAGGTCGGAG AGGCCTGGCA GGACAGGCCT GGAGCCCCAA GAGGTGGCCA AGGAGACCCA
    GCTGTACCCA CTCAGCAACC TGCAGATCCC AGCACCCCAG AACAGCAGAA CAGCCCCAGC
    GGATCTGAGC AATTCGTCAG ACGAGAGAGC TGCACCAGCA GGGTGAGGAG CCCCTCGAGC
    TGCATGGTCA CTGTTACTGT CACTGCCACA TCTGAGCAGC CTCACATTTA TATTCCAGCC
    CCCGCAAGTG AATTGGACTC CAGCTCTACC ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC
    GTGAATGCTA GTGAAGTGTC TTCTGGGAAG CCAGTATCTG CACGCTATAG CAACGTCAGC
    AGCATTGAGG ACTCATTCGC CATGGAGAAG AAGCCTCCAT GTGGCAGCAC TCCATACTCT
    GAGAGGACAA CTGGAGGGAT CTGTACTTAC TGCAACCGTG AGATCCGAGA CTGTCCAAAG
    ATTACCCTAG AACATCTTGG TATCTGCTGC CATGAATATT GCTTTAAGTG TGGGATTTGC
    AGTAAACCGA TGGGTGATCT CCTGGATCAG ATCTTCATTC ACCGTGACAC CATTCACTGT
    GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76601
    Clone ID Related Accession (Same CDS sequence) XM_008965841.2 , XM_008965841.1
    Accession Version XM_008965841.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1887bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X12
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014477.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGCGTGTTG GCTGATTTTG AGGGGAAGGA TGTGGCCACC
    AAGGTCGGAG AGGCCTGGCA GGACAGGCCT GGAGCCCCAA GAGGTGGCCA AGGAGACCCA
    GCTGTACCCA CTCAGCAACC TGCAGATCCC AGCACCCCAG AACAGCAGAA CAGCCCCAGC
    GGATCTGAGC AATTCGTCAG ACGAGAGAGC TGCACCAGCA GGGTGAGGAG CCCCTCGAGC
    TGCATGGTCA CTGTTACTGT CACTGCCACA TCTGAGCAGC CTCACATTTA TATTCCAGCC
    CCCGCAAGTG AATTGGACTC CAGCTCTACC ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC
    GTGAATGCTA GTGAAGTGTC TTCTGGGAAG CCAGTATCTG CACGCTATAG CAACGTCAGC
    AGCATTGAGG ACTCATTCGC CATGGAGAAG AAGCCTCCAT GTGGCAGCAC TCCATACTCT
    GAGAGGACAA CTGGAGGGAT CTGTACTTAC TGCAACCGTG AGATCCGAGA CTGTCCAAAG
    ATTACCCTAG AACATCTTGG TATCTGCTGC CATGAATATT GCTTTAAGTG TGGGATTTGC
    AGTAAACCGA TGGGTGATCT CCTGGATCAG ATCTTCATTC ACCGTGACAC CATTCACTGT
    GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964089.1
    CDS123..2009
    Translation

    Target ORF information:

    RefSeq Version XM_008965841.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X13, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965841.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGTC CTACCCAGGA GACACAGGCA CCGTTTATCG CGAAGAGGGT GGAGGTGGTG
    GAAGAGGACG GGCCTTCTGA GAAGAGCCAG GACCCACCTG CTCTGGCAAG ATCCACTCCT
    GGCTCAAACA GGTCTTCCCC AGGCAACAAA GACAAGGAGG CCCCCTGCTC CAGAGAGCTC
    CAGAGGGACT TGGCTGGTGA GGAGGCTTTC AGGGGCCCCA ACACAGATGC TGCAAGGTCA
    AGTGCACAGT TGAGTGATGG CAATGTGGGA TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC
    TTGGCTGCAG TAGACATCGG CTCCGAGAGA GGAAGCTCCA GTGCCACTTC AGTCTCTGCT
    GTCCCTGCTG ATAGGAAGAG CAACAGCACA GCAGCCCAGG AGGATGCAAA GGCAGACCCA
    AAGGGGGCCT TGGCTGATTA TGAGGGGAAG AATGTGGCCA CCAGGGTCGG AGAGGCCTGG
    CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC CAAGGAGACC CAGCTGTACC CACTCAGCAA
    CCTGCAGATC CCAGCACCCC AGAGCGGCAG AGCAGCCCCA GCGGATCTGA GCAACTTGTC
    AGACGAGAGA GTTGTGGCAG CAGCGTGTTG GCTGATTTTG AGGGGAAGGA TGTGGCCACC
    AAGGTCGGAG AGGCCTGGCA GGACAGGCCT GGAGCCCCAA GAGGTGGCCA AGGAGACCCA
    GCTGTACCCA CTCAGCAACC TGCAGATCCC AGCACCCCAG AACAGCAGAA CAGCCCCAGC
    GGATCTGAGC AATTCGTCAG ACGAGAGAGC TGCACCAGCA GGGTGAGGAG CCCCTCGAGC
    TGCATGGTCA CTGTTACTGT CACTGCCACA TCTGAGCAGC CTCACATTTA TATTCCAGCC
    CCCGCAAGTG AATTGGACTC CAGCTCTACC ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC
    GTGAATGCTA GTGAAGTGTC TTCTGGGAAG CCAGTATCTG CACGCTATAG CAACGTCAGC
    AGCATTGAGG ACTCATTCGC CATGGAGAAG AAGCCTCCAT GTGGCAGCAC TCCATACTCT
    GAGAGGACAA CTGGAGGGAT CTGTACTTAC TGCAACCGTG AGATCCGAGA CTGTCCAAAG
    ATTACCCTAG AACATCTTGG TATCTGCTGC CATGAATATT GCTTTAAGTG TGGGATTTGC
    AGTAAACCGA TGGGTGATCT CCTGGATCAG ATCTTCATTC ACCGTGACAC CATTCACTGT
    GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76602
    Clone ID Related Accession (Same CDS sequence) XM_008965848.2 , XM_008965848.1
    Accession Version XM_008965848.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1806bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X15
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008965848.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGCAGTCC TACCCAGGAG
    ACACAGGCAC CGTTTATCGC GAAGAGGGTG GAGGTGGTGG AAGAGGACGG GCCTTCTGAG
    AAGAGCCAGG ACCCACCTGC TCTGGCAAGA TCCACTCCTG GCTCAAACAG GTCTTCCCCA
    GGCAACAAAG ACAAGGAGGC CCCCTGCTCC AGAGAGCTCC AGAGGGACTT GGCTGGTGAG
    GAGGCTTTCA GGGGCCCCAA CACAGATGCT GCAAGGTCAA GTGCACAGTT GAGTGATGGC
    AATGTGGGAT CCGGAGCCAC GGGCTCCCGG CCTGAAGGCT TGGCTGCAGT AGACATCGGC
    TCCGAGAGAG GAAGCTCCAG TGCCACTTCA GTCTCTGCTG TCCCTGCTGA TAGGAAGAGC
    AACAGCACAG CAGCCCAGGA GGATGCAAAG GCAGACCCAA AGGGGGCCTT GGCTGATTAT
    GAGGGGAAGA ATGTGGCCAC CAGGGTCGGA GAGGCCTGGC AGGAGAGGCC TGGAGCTCCA
    AGAGGTGGCC AAGGAGACCC AGCTGTACCC ACTCAGCAAC CTGCAGATCC CAGCACCCCA
    GAGCGGCAGA GCAGCCCCAG CGGATCTGAG CAACTTGTCA GACGAGAGAG TTGTGGCAGC
    AGCGTGTTGG CTGATTTTGA GGGGAAGGAT GTGGCCACCA AGGTCGGAGA GGCCTGGCAG
    GACAGGCCTG GAGCCCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA ACAGCAGAAC AGCCCCAGCG GATCTGAGCA ATTCGTCAGA
    CGAGAGAGCT GCACCAGCAG GGTGAGGAGC CCCTCGAGCT GCATGGTCAC TGTTACTGTC
    ACTGCCACAT CTGAGCAGCC TCACATTTAT ATTCCAGCCC CCGCAAGTGA ATTGGACTCC
    AGCTCTACCA CCAAAGGGAT TCTCTTCGTG AAGGAGTACG TGAATGCTAG TGAAGTGTCT
    TCTGGGAAGC CAGTATCTGC ACGCTATAGC AACGTCAGCA GCATTGAGGA CTCATTCGCC
    ATGGAGAAGA AGCCTCCATG TGGCAGCACT CCATACTCTG AGAGGACAAC TGGAGGGATC
    TGTACTTACT GCAACCGTGA GATCCGAGAC TGTCCAAAGA TTACCCTAGA ACATCTTGGT
    ATCTGCTGCC ATGAATATTG CTTTAAGTGT GGGATTTGCA GTAAACCGAT GGGTGATCTC
    CTGGATCAGA TCTTCATTCA CCGTGACACC ATTCACTGTG GGAAATGCTA TGAAAAGCTC
    TTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964096.1
    CDS123..1928
    Translation

    Target ORF information:

    RefSeq Version XM_008965848.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X16, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965848.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGCAGTCC TACCCAGGAG
    ACACAGGCAC CGTTTATCGC GAAGAGGGTG GAGGTGGTGG AAGAGGACGG GCCTTCTGAG
    AAGAGCCAGG ACCCACCTGC TCTGGCAAGA TCCACTCCTG GCTCAAACAG GTCTTCCCCA
    GGCAACAAAG ACAAGGAGGC CCCCTGCTCC AGAGAGCTCC AGAGGGACTT GGCTGGTGAG
    GAGGCTTTCA GGGGCCCCAA CACAGATGCT GCAAGGTCAA GTGCACAGTT GAGTGATGGC
    AATGTGGGAT CCGGAGCCAC GGGCTCCCGG CCTGAAGGCT TGGCTGCAGT AGACATCGGC
    TCCGAGAGAG GAAGCTCCAG TGCCACTTCA GTCTCTGCTG TCCCTGCTGA TAGGAAGAGC
    AACAGCACAG CAGCCCAGGA GGATGCAAAG GCAGACCCAA AGGGGGCCTT GGCTGATTAT
    GAGGGGAAGA ATGTGGCCAC CAGGGTCGGA GAGGCCTGGC AGGAGAGGCC TGGAGCTCCA
    AGAGGTGGCC AAGGAGACCC AGCTGTACCC ACTCAGCAAC CTGCAGATCC CAGCACCCCA
    GAGCGGCAGA GCAGCCCCAG CGGATCTGAG CAACTTGTCA GACGAGAGAG TTGTGGCAGC
    AGCGTGTTGG CTGATTTTGA GGGGAAGGAT GTGGCCACCA AGGTCGGAGA GGCCTGGCAG
    GACAGGCCTG GAGCCCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA ACAGCAGAAC AGCCCCAGCG GATCTGAGCA ATTCGTCAGA
    CGAGAGAGCT GCACCAGCAG GGTGAGGAGC CCCTCGAGCT GCATGGTCAC TGTTACTGTC
    ACTGCCACAT CTGAGCAGCC TCACATTTAT ATTCCAGCCC CCGCAAGTGA ATTGGACTCC
    AGCTCTACCA CCAAAGGGAT TCTCTTCGTG AAGGAGTACG TGAATGCTAG TGAAGTGTCT
    TCTGGGAAGC CAGTATCTGC ACGCTATAGC AACGTCAGCA GCATTGAGGA CTCATTCGCC
    ATGGAGAAGA AGCCTCCATG TGGCAGCACT CCATACTCTG AGAGGACAAC TGGAGGGATC
    TGTACTTACT GCAACCGTGA GATCCGAGAC TGTCCAAAGA TTACCCTAGA ACATCTTGGT
    ATCTGCTGCC ATGAATATTG CTTTAAGTGT GGGATTTGCA GTAAACCGAT GGGTGATCTC
    CTGGATCAGA TCTTCATTCA CCGTGACACC ATTCACTGTG GGAAATGCTA TGAAAAGCTC
    TTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76602
    Clone ID Related Accession (Same CDS sequence) XM_008965848.2 , XM_008965848.1
    Accession Version XM_008965848.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1806bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X13
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014477.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGCAGTCC TACCCAGGAG
    ACACAGGCAC CGTTTATCGC GAAGAGGGTG GAGGTGGTGG AAGAGGACGG GCCTTCTGAG
    AAGAGCCAGG ACCCACCTGC TCTGGCAAGA TCCACTCCTG GCTCAAACAG GTCTTCCCCA
    GGCAACAAAG ACAAGGAGGC CCCCTGCTCC AGAGAGCTCC AGAGGGACTT GGCTGGTGAG
    GAGGCTTTCA GGGGCCCCAA CACAGATGCT GCAAGGTCAA GTGCACAGTT GAGTGATGGC
    AATGTGGGAT CCGGAGCCAC GGGCTCCCGG CCTGAAGGCT TGGCTGCAGT AGACATCGGC
    TCCGAGAGAG GAAGCTCCAG TGCCACTTCA GTCTCTGCTG TCCCTGCTGA TAGGAAGAGC
    AACAGCACAG CAGCCCAGGA GGATGCAAAG GCAGACCCAA AGGGGGCCTT GGCTGATTAT
    GAGGGGAAGA ATGTGGCCAC CAGGGTCGGA GAGGCCTGGC AGGAGAGGCC TGGAGCTCCA
    AGAGGTGGCC AAGGAGACCC AGCTGTACCC ACTCAGCAAC CTGCAGATCC CAGCACCCCA
    GAGCGGCAGA GCAGCCCCAG CGGATCTGAG CAACTTGTCA GACGAGAGAG TTGTGGCAGC
    AGCGTGTTGG CTGATTTTGA GGGGAAGGAT GTGGCCACCA AGGTCGGAGA GGCCTGGCAG
    GACAGGCCTG GAGCCCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA ACAGCAGAAC AGCCCCAGCG GATCTGAGCA ATTCGTCAGA
    CGAGAGAGCT GCACCAGCAG GGTGAGGAGC CCCTCGAGCT GCATGGTCAC TGTTACTGTC
    ACTGCCACAT CTGAGCAGCC TCACATTTAT ATTCCAGCCC CCGCAAGTGA ATTGGACTCC
    AGCTCTACCA CCAAAGGGAT TCTCTTCGTG AAGGAGTACG TGAATGCTAG TGAAGTGTCT
    TCTGGGAAGC CAGTATCTGC ACGCTATAGC AACGTCAGCA GCATTGAGGA CTCATTCGCC
    ATGGAGAAGA AGCCTCCATG TGGCAGCACT CCATACTCTG AGAGGACAAC TGGAGGGATC
    TGTACTTACT GCAACCGTGA GATCCGAGAC TGTCCAAAGA TTACCCTAGA ACATCTTGGT
    ATCTGCTGCC ATGAATATTG CTTTAAGTGT GGGATTTGCA GTAAACCGAT GGGTGATCTC
    CTGGATCAGA TCTTCATTCA CCGTGACACC ATTCACTGTG GGAAATGCTA TGAAAAGCTC
    TTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964096.1
    CDS123..1928
    Translation

    Target ORF information:

    RefSeq Version XM_008965848.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X14, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965848.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGCAGTCC TACCCAGGAG
    ACACAGGCAC CGTTTATCGC GAAGAGGGTG GAGGTGGTGG AAGAGGACGG GCCTTCTGAG
    AAGAGCCAGG ACCCACCTGC TCTGGCAAGA TCCACTCCTG GCTCAAACAG GTCTTCCCCA
    GGCAACAAAG ACAAGGAGGC CCCCTGCTCC AGAGAGCTCC AGAGGGACTT GGCTGGTGAG
    GAGGCTTTCA GGGGCCCCAA CACAGATGCT GCAAGGTCAA GTGCACAGTT GAGTGATGGC
    AATGTGGGAT CCGGAGCCAC GGGCTCCCGG CCTGAAGGCT TGGCTGCAGT AGACATCGGC
    TCCGAGAGAG GAAGCTCCAG TGCCACTTCA GTCTCTGCTG TCCCTGCTGA TAGGAAGAGC
    AACAGCACAG CAGCCCAGGA GGATGCAAAG GCAGACCCAA AGGGGGCCTT GGCTGATTAT
    GAGGGGAAGA ATGTGGCCAC CAGGGTCGGA GAGGCCTGGC AGGAGAGGCC TGGAGCTCCA
    AGAGGTGGCC AAGGAGACCC AGCTGTACCC ACTCAGCAAC CTGCAGATCC CAGCACCCCA
    GAGCGGCAGA GCAGCCCCAG CGGATCTGAG CAACTTGTCA GACGAGAGAG TTGTGGCAGC
    AGCGTGTTGG CTGATTTTGA GGGGAAGGAT GTGGCCACCA AGGTCGGAGA GGCCTGGCAG
    GACAGGCCTG GAGCCCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA ACAGCAGAAC AGCCCCAGCG GATCTGAGCA ATTCGTCAGA
    CGAGAGAGCT GCACCAGCAG GGTGAGGAGC CCCTCGAGCT GCATGGTCAC TGTTACTGTC
    ACTGCCACAT CTGAGCAGCC TCACATTTAT ATTCCAGCCC CCGCAAGTGA ATTGGACTCC
    AGCTCTACCA CCAAAGGGAT TCTCTTCGTG AAGGAGTACG TGAATGCTAG TGAAGTGTCT
    TCTGGGAAGC CAGTATCTGC ACGCTATAGC AACGTCAGCA GCATTGAGGA CTCATTCGCC
    ATGGAGAAGA AGCCTCCATG TGGCAGCACT CCATACTCTG AGAGGACAAC TGGAGGGATC
    TGTACTTACT GCAACCGTGA GATCCGAGAC TGTCCAAAGA TTACCCTAGA ACATCTTGGT
    ATCTGCTGCC ATGAATATTG CTTTAAGTGT GGGATTTGCA GTAAACCGAT GGGTGATCTC
    CTGGATCAGA TCTTCATTCA CCGTGACACC ATTCACTGTG GGAAATGCTA TGAAAAGCTC
    TTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76603
    Clone ID Related Accession (Same CDS sequence) XM_008965857.1
    Accession Version XM_008965857.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1791bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X16
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGGTCTTC CCCAGGCAAC AAAGACAAGG AGGCCCCCTG CTCCAGAGAG
    CTCCAGAGGG ACTTGGCTGG TGAGGAGGCT TTCAGGGGCC CCAACACAGA TGCTGCAAGC
    TCCAGTGCCA CTTCAGTCTC TGCTGTCCCT GCTGATAGGA AGAGCAACAG CACAGCAGCC
    CAGGAGGATG CAAAGGCAGA CCCAAAGGGG GCCTTGGCTG ATTATGAGGG GAAGAATGTG
    GCCACCAGGG TCGGAGAGGC CTGGCAGGAG AGGCCTGGAG CTCCAAGAGG TGGCCAAGGA
    GACCCAGCTG TACCCACTCA GCAACCTGCA GATCCCAGCA CCCCAGAGCG GCAGAGCAGC
    CCCAGCGGAT CTGAGCAACT TGTCAGACGA GAGAGTTGTG GCAGCAGCGT GTTGGCTGAT
    TTTGAGGGGA AGGATGTGGC CACCAAGGTC GGAGAGGCCT GGCAGGACAG GCCTGGAGCC
    CCAAGAGGTG GCCAAGGAGA CCCAGCTGTA CCCACTCAGC AACCTGCAGA TCCCAGCACC
    CCAGAACAGC AGAACAGCCC CAGCGGATCT GAGCAATTCG TCAGACGAGA GAGCTGCACC
    AGCAGGGTGA GGAGCCCCTC GAGCTGCATG GTCACTGTTA CTGTCACTGC CACATCTGAG
    CAGCCTCACA TTTATATTCC AGCCCCCGCA AGTGAATTGG ACTCCAGCTC TACCACCAAA
    GGGATTCTCT TCGTGAAGGA GTACGTGAAT GCTAGTGAAG TGTCTTCTGG GAAGCCAGTA
    TCTGCACGCT ATAGCAACGT CAGCAGCATT GAGGACTCAT TCGCCATGGA GAAGAAGCCT
    CCATGTGGCA GCACTCCATA CTCTGAGAGG ACAACTGGAG GGATCTGTAC TTACTGCAAC
    CGTGAGATCC GAGACTGTCC AAAGATTACC CTAGAACATC TTGGTATCTG CTGCCATGAA
    TATTGCTTTA AGTGTGGGAT TTGCAGTAAA CCGATGGGTG ATCTCCTGGA TCAGATCTTC
    ATTCACCGTG ACACCATTCA CTGTGGGAAA TGCTATGAAA AGCTCTTCTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964105.1
    CDS123..1913
    Translation

    Target ORF information:

    RefSeq Version XM_008965857.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X17, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965857.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGGTCTTC CCCAGGCAAC AAAGACAAGG AGGCCCCCTG CTCCAGAGAG
    CTCCAGAGGG ACTTGGCTGG TGAGGAGGCT TTCAGGGGCC CCAACACAGA TGCTGCAAGC
    TCCAGTGCCA CTTCAGTCTC TGCTGTCCCT GCTGATAGGA AGAGCAACAG CACAGCAGCC
    CAGGAGGATG CAAAGGCAGA CCCAAAGGGG GCCTTGGCTG ATTATGAGGG GAAGAATGTG
    GCCACCAGGG TCGGAGAGGC CTGGCAGGAG AGGCCTGGAG CTCCAAGAGG TGGCCAAGGA
    GACCCAGCTG TACCCACTCA GCAACCTGCA GATCCCAGCA CCCCAGAGCG GCAGAGCAGC
    CCCAGCGGAT CTGAGCAACT TGTCAGACGA GAGAGTTGTG GCAGCAGCGT GTTGGCTGAT
    TTTGAGGGGA AGGATGTGGC CACCAAGGTC GGAGAGGCCT GGCAGGACAG GCCTGGAGCC
    CCAAGAGGTG GCCAAGGAGA CCCAGCTGTA CCCACTCAGC AACCTGCAGA TCCCAGCACC
    CCAGAACAGC AGAACAGCCC CAGCGGATCT GAGCAATTCG TCAGACGAGA GAGCTGCACC
    AGCAGGGTGA GGAGCCCCTC GAGCTGCATG GTCACTGTTA CTGTCACTGC CACATCTGAG
    CAGCCTCACA TTTATATTCC AGCCCCCGCA AGTGAATTGG ACTCCAGCTC TACCACCAAA
    GGGATTCTCT TCGTGAAGGA GTACGTGAAT GCTAGTGAAG TGTCTTCTGG GAAGCCAGTA
    TCTGCACGCT ATAGCAACGT CAGCAGCATT GAGGACTCAT TCGCCATGGA GAAGAAGCCT
    CCATGTGGCA GCACTCCATA CTCTGAGAGG ACAACTGGAG GGATCTGTAC TTACTGCAAC
    CGTGAGATCC GAGACTGTCC AAAGATTACC CTAGAACATC TTGGTATCTG CTGCCATGAA
    TATTGCTTTA AGTGTGGGAT TTGCAGTAAA CCGATGGGTG ATCTCCTGGA TCAGATCTTC
    ATTCACCGTG ACACCATTCA CTGTGGGAAA TGCTATGAAA AGCTCTTCTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76604
    Clone ID Related Accession (Same CDS sequence) XM_008965866.2 , XM_008965866.1
    Accession Version XM_008965866.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 984bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X17
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008965866.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    ATGGCCGCCC GGGACGAGCT CGGCTTCGGC GGGGATTCTC TTGAGTCCAT GCCCGTGCCG 
    GCCGCCAGAG GTCGCCCGAG GATCACGAAT GGGCCCGAGG AGCTGGCTGC CCCTTCCCCC
    GCGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT GATTTTGAGG GGAAGGATGT GGCCACCAAG
    GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA GCCCCAAGAG GTGGCCAAGG AGACCCAGCT
    GTACCCACTC AGCAACCTGC AGATCCCAGC ACCCCAGAAC AGCAGAACAG CCCCAGCGGA
    TCTGAGCAAT TCGTCAGACG AGAGAGCTGC ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC
    ATGGTCACTG TTACTGTCAC TGCCACATCT GAGCAGCCTC ACATTTATAT TCCAGCCCCC
    GCAAGTGAAT TGGACTCCAG CTCTACCACC AAAGGGATTC TCTTCGTGAA GGAGTACGTG
    AATGCTAGTG AAGTGTCTTC TGGGAAGCCA GTATCTGCAC GCTATAGCAA CGTCAGCAGC
    ATTGAGGACT CATTCGCCAT GGAGAAGAAG CCTCCATGTG GCAGCACTCC ATACTCTGAG
    AGGACAACTG GAGGGATCTG TACTTACTGC AACCGTGAGA TCCGAGACTG TCCAAAGATT
    ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT GAATATTGCT TTAAGTGTGG GATTTGCAGT
    AAACCGATGG GTGATCTCCT GGATCAGATC TTCATTCACC GTGACACCAT TCACTGTGGG
    AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964114.1
    CDS33..1016
    Translation

    Target ORF information:

    RefSeq Version XM_008965866.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X18, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965866.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    ATGGCCGCCC GGGACGAGCT CGGCTTCGGC GGGGATTCTC TTGAGTCCAT GCCCGTGCCG 
    GCCGCCAGAG GTCGCCCGAG GATCACGAAT GGGCCCGAGG AGCTGGCTGC CCCTTCCCCC
    GCGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT GATTTTGAGG GGAAGGATGT GGCCACCAAG
    GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA GCCCCAAGAG GTGGCCAAGG AGACCCAGCT
    GTACCCACTC AGCAACCTGC AGATCCCAGC ACCCCAGAAC AGCAGAACAG CCCCAGCGGA
    TCTGAGCAAT TCGTCAGACG AGAGAGCTGC ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC
    ATGGTCACTG TTACTGTCAC TGCCACATCT GAGCAGCCTC ACATTTATAT TCCAGCCCCC
    GCAAGTGAAT TGGACTCCAG CTCTACCACC AAAGGGATTC TCTTCGTGAA GGAGTACGTG
    AATGCTAGTG AAGTGTCTTC TGGGAAGCCA GTATCTGCAC GCTATAGCAA CGTCAGCAGC
    ATTGAGGACT CATTCGCCAT GGAGAAGAAG CCTCCATGTG GCAGCACTCC ATACTCTGAG
    AGGACAACTG GAGGGATCTG TACTTACTGC AACCGTGAGA TCCGAGACTG TCCAAAGATT
    ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT GAATATTGCT TTAAGTGTGG GATTTGCAGT
    AAACCGATGG GTGATCTCCT GGATCAGATC TTCATTCACC GTGACACCAT TCACTGTGGG
    AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76604
    Clone ID Related Accession (Same CDS sequence) XM_008965866.2 , XM_008965866.1
    Accession Version XM_008965866.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 984bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X15
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014477.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    ATGGCCGCCC GGGACGAGCT CGGCTTCGGC GGGGATTCTC TTGAGTCCAT GCCCGTGCCG 
    GCCGCCAGAG GTCGCCCGAG GATCACGAAT GGGCCCGAGG AGCTGGCTGC CCCTTCCCCC
    GCGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT GATTTTGAGG GGAAGGATGT GGCCACCAAG
    GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA GCCCCAAGAG GTGGCCAAGG AGACCCAGCT
    GTACCCACTC AGCAACCTGC AGATCCCAGC ACCCCAGAAC AGCAGAACAG CCCCAGCGGA
    TCTGAGCAAT TCGTCAGACG AGAGAGCTGC ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC
    ATGGTCACTG TTACTGTCAC TGCCACATCT GAGCAGCCTC ACATTTATAT TCCAGCCCCC
    GCAAGTGAAT TGGACTCCAG CTCTACCACC AAAGGGATTC TCTTCGTGAA GGAGTACGTG
    AATGCTAGTG AAGTGTCTTC TGGGAAGCCA GTATCTGCAC GCTATAGCAA CGTCAGCAGC
    ATTGAGGACT CATTCGCCAT GGAGAAGAAG CCTCCATGTG GCAGCACTCC ATACTCTGAG
    AGGACAACTG GAGGGATCTG TACTTACTGC AACCGTGAGA TCCGAGACTG TCCAAAGATT
    ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT GAATATTGCT TTAAGTGTGG GATTTGCAGT
    AAACCGATGG GTGATCTCCT GGATCAGATC TTCATTCACC GTGACACCAT TCACTGTGGG
    AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964114.1
    CDS33..1016
    Translation

    Target ORF information:

    RefSeq Version XM_008965866.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 (LIM domain) (ZNF185), transcript variant X16, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965866.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    ATGGCCGCCC GGGACGAGCT CGGCTTCGGC GGGGATTCTC TTGAGTCCAT GCCCGTGCCG 
    GCCGCCAGAG GTCGCCCGAG GATCACGAAT GGGCCCGAGG AGCTGGCTGC CCCTTCCCCC
    GCGGCCTTGG CTGATTATGA GGGGAAGAAT GTGGCCACCA GGGTCGGAGA GGCCTGGCAG
    GAGAGGCCTG GAGCTCCAAG AGGTGGCCAA GGAGACCCAG CTGTACCCAC TCAGCAACCT
    GCAGATCCCA GCACCCCAGA GCGGCAGAGC AGCCCCAGCG GATCTGAGCA ACTTGTCAGA
    CGAGAGAGTT GTGGCAGCAG CGTGTTGGCT GATTTTGAGG GGAAGGATGT GGCCACCAAG
    GTCGGAGAGG CCTGGCAGGA CAGGCCTGGA GCCCCAAGAG GTGGCCAAGG AGACCCAGCT
    GTACCCACTC AGCAACCTGC AGATCCCAGC ACCCCAGAAC AGCAGAACAG CCCCAGCGGA
    TCTGAGCAAT TCGTCAGACG AGAGAGCTGC ACCAGCAGGG TGAGGAGCCC CTCGAGCTGC
    ATGGTCACTG TTACTGTCAC TGCCACATCT GAGCAGCCTC ACATTTATAT TCCAGCCCCC
    GCAAGTGAAT TGGACTCCAG CTCTACCACC AAAGGGATTC TCTTCGTGAA GGAGTACGTG
    AATGCTAGTG AAGTGTCTTC TGGGAAGCCA GTATCTGCAC GCTATAGCAA CGTCAGCAGC
    ATTGAGGACT CATTCGCCAT GGAGAAGAAG CCTCCATGTG GCAGCACTCC ATACTCTGAG
    AGGACAACTG GAGGGATCTG TACTTACTGC AACCGTGAGA TCCGAGACTG TCCAAAGATT
    ACCCTAGAAC ATCTTGGTAT CTGCTGCCAT GAATATTGCT TTAAGTGTGG GATTTGCAGT
    AAACCGATGG GTGATCTCCT GGATCAGATC TTCATTCACC GTGACACCAT TCACTGTGGG
    AAATGCTATG AAAAGCTCTT CTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa76605
    Clone ID Related Accession (Same CDS sequence) XM_008965811.1
    Accession Version XM_008965811.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1977bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 185 isoform X18
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027891.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGCTCAAG AGGTGAGGAA ATTGTCCGCC TGCAGATCCT GACACCCAGG
    GCAGGACTCC GCCTGGTGGC CCCAGACCTG GAAGGCATGA GGTCTTCCCC AGGCAACAAA
    GACAAGGAGG CCCCCTGCTC CAGAGAGCTC CAGAGGGACT TGGCTGGTGA GGAGGCTTTC
    AGGGGCCCCA ACACAGATGC TGCAAGGTCA AGTGCACAGT TGAGTGATGG CAATGTGGGA
    TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC TTGGCTGCAG TAGACATCGG CTCCGAGAGA
    GGAAGCTCCA GTGCCACTTC AGTCTCTGCT GTCCCTGCTG ATAGGAAGAG CAACAGCACA
    GCAGCCCAGG AGGATGCAAA GGCAGACCCA AAGGGGGCCT TGGCTGATTA TGAGGGGAAG
    AATGTGGCCA CCAGGGTCGG AGAGGCCTGG CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAGCGGCAG
    AGCAGCCCCA GCGGATCTGA GCAACTTGTC AGACGAGAGA GTTGTGGCAG CAGCGTGTTG
    GCTGATTTTG AGGGGAAGGA TGTGGCCACC AAGGTCGGAG AGGCCTGGCA GGACAGGCCT
    GGAGCCCCAA GAGGTGGCCA AGGAGACCCA GCTGTACCCA CTCAGCAACC TGCAGATCCC
    AGCACCCCAG AACAGCAGAA CAGCCCCAGC GGATCTGAGC AATTCGTCAG ACGAGAGAGC
    TGCACCAGCA GGGTGAGGAG CCCCTCGAGC TGCATGGTCA CTGTTACTGT CACTGCCACA
    TCTGAGCAGC CTCACATTTA TATTCCAGCC CCCGCAAGTG AATTGGACTC CAGCTCTACC
    ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC GTGAATGCTA GTGAAGTGTC TTCTGGGAAG
    CCAGTATCTG CACGCTATAG CAACGTCAGC AGCATTGAGG ACTCATTCGC CATGGAGAAG
    AAGCCTCCAT GTGGCAGCAC TCCATACTCT GAGAGGACAA CTGGAGGGAT CTGTACTTAC
    TGCAACCGTG AGATCCGAGA CTGTCCAAAG ATTACCCTAG AACATCTTGG TATCTGCTGC
    CATGAATATT GCTTTAAGTG TGGGATTTGC AGTAAACCGA TGGGTGATCT CCTGGATCAG
    ATCTTCATTC ACCGTGACAC CATTCACTGT GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008964059.1
    CDS123..2099
    Translation

    Target ORF information:

    RefSeq Version XM_008965811.1
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 185 with LIM domain (ZNF185), transcript variant X19, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008965811.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    ATGAGTATCT CAGCGCTTGG AGGCCGCACC AAAGGGAAGC CTCTGCCACC AGGCGAGGAG 
    GAGCGCAATA ACGTTCTCAA GCAGATGAAA GTGCGAACCA CGCTGAAGGG GGACAAGAGC
    TGGATTACCA AGCAGGATGA ATCGGAGGGT CGCACCATAG AGCTGCCCTC AGGCCGGAGT
    CGCGCCACAT CCTTTTCATC AGCTGGGGAG GTTCCGAAGC CTAGGCCTCC GAGCACAAGG
    GCTCCCACTG GCTACATCAT CCGGGGAGTG TTCACCAAGC CCATAGACAG CTCTTCCCAG
    CCCCAGCAGC AGTTCCCCAA GGCCAATGGG ACTCCAAAAA GTGCTGCCAG TCTGGTGAGA
    ACAGCTAACA CTGGTCCTCC CCGCCCCTCC TCCTCTGGCT ACAAGATGAC CACTGAGGAT
    TACAAGAAGC TGGCACCCTA CAATATCAGG CGCAGCTCTA CATCAGGGGA CACCGAGGAG
    GAGGAGGAGG TGGTGCCTTT CTCCTCAGAT GAACAGAAAC GGAGGTCAGA GGCTGCAAGC
    AGTGTTCTGA GGAGGACAGC TCCCCGGGAG CACTCCTACG TCCTGTCAGC GGCCAAGAAG
    AGCACTGGCA GTCCTACCCA GGAGACACAG GCACCGTTTA TCGCGAAGAG GGTGGAGGTG
    GTGGAAGAGG ACGGGCCTTC TGAGAAGAGC CAGGACCCAC CTGCTCTGGC AAGATCCACT
    CCTGGCTCAA ACAGCTCAAG AGGTGAGGAA ATTGTCCGCC TGCAGATCCT GACACCCAGG
    GCAGGACTCC GCCTGGTGGC CCCAGACCTG GAAGGCATGA GGTCTTCCCC AGGCAACAAA
    GACAAGGAGG CCCCCTGCTC CAGAGAGCTC CAGAGGGACT TGGCTGGTGA GGAGGCTTTC
    AGGGGCCCCA ACACAGATGC TGCAAGGTCA AGTGCACAGT TGAGTGATGG CAATGTGGGA
    TCCGGAGCCA CGGGCTCCCG GCCTGAAGGC TTGGCTGCAG TAGACATCGG CTCCGAGAGA
    GGAAGCTCCA GTGCCACTTC AGTCTCTGCT GTCCCTGCTG ATAGGAAGAG CAACAGCACA
    GCAGCCCAGG AGGATGCAAA GGCAGACCCA AAGGGGGCCT TGGCTGATTA TGAGGGGAAG
    AATGTGGCCA CCAGGGTCGG AGAGGCCTGG CAGGAGAGGC CTGGAGCTCC AAGAGGTGGC
    CAAGGAGACC CAGCTGTACC CACTCAGCAA CCTGCAGATC CCAGCACCCC AGAGCGGCAG
    AGCAGCCCCA GCGGATCTGA GCAACTTGTC AGACGAGAGA GTTGTGGCAG CAGCGTGTTG
    GCTGATTTTG AGGGGAAGGA TGTGGCCACC AAGGTCGGAG AGGCCTGGCA GGACAGGCCT
    GGAGCCCCAA GAGGTGGCCA AGGAGACCCA GCTGTACCCA CTCAGCAACC TGCAGATCCC
    AGCACCCCAG AACAGCAGAA CAGCCCCAGC GGATCTGAGC AATTCGTCAG ACGAGAGAGC
    TGCACCAGCA GGGTGAGGAG CCCCTCGAGC TGCATGGTCA CTGTTACTGT CACTGCCACA
    TCTGAGCAGC CTCACATTTA TATTCCAGCC CCCGCAAGTG AATTGGACTC CAGCTCTACC
    ACCAAAGGGA TTCTCTTCGT GAAGGAGTAC GTGAATGCTA GTGAAGTGTC TTCTGGGAAG
    CCAGTATCTG CACGCTATAG CAACGTCAGC AGCATTGAGG ACTCATTCGC CATGGAGAAG
    AAGCCTCCAT GTGGCAGCAC TCCATACTCT GAGAGGACAA CTGGAGGGAT CTGTACTTAC
    TGCAACCGTG AGATCCGAGA CTGTCCAAAG ATTACCCTAG AACATCTTGG TATCTGCTGC
    CATGAATATT GCTTTAAGTG TGGGATTTGC AGTAAACCGA TGGGTGATCT CCTGGATCAG
    ATCTTCATTC ACCGTGACAC CATTCACTGT GGGAAATGCT ATGAAAAGCT CTTCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.