FNIP1 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

The following FNIP1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the FNIP1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs14646 XM_014253155.1
Latest version!
Pseudopodoces humilis folliculin interacting protein 1 (FNIP1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00
OPs14647 XM_014253156.1
Latest version!
Pseudopodoces humilis folliculin interacting protein 1 (FNIP1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs14646
    Clone ID Related Accession (Same CDS sequence) XM_014253155.1
    Accession Version XM_014253155.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3510bp)
    Protein sequence
    SNP
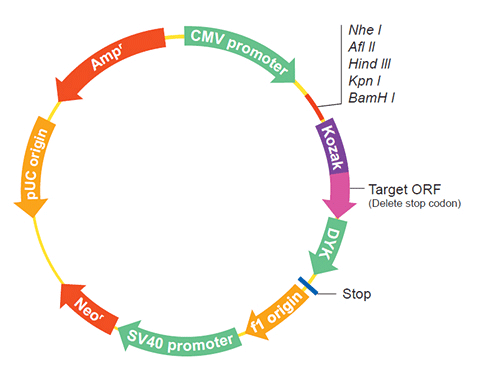
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product folliculin-interacting protein 1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087571.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGCCGCCTA CCCTCTTCCA GAAGCTCTTC AACAAGAAGC ATGGGCTGAT CTCCCCCGCC 
    AGGGATGCCC GCGACGACTG TATCTTCAGC TGGCCTTTGC CGGAGTTTGA CCCAAGTCAG
    ATCCGACTAA TTGTGTATCA GGACTGTGAA AGAAGAGGAC GGAATGTCTT ATTTGATTCC
    AGTGCTAAAA GAAAAATAGA GGATGTTTCA GTGTCGAAAC TCTGCAGTGA TGCTCAAGTG
    AGAGTTTTTG GGAAATGTTG CCAACTAAAG CCTGGAGGAG ACAGTTCTTC TTCCTTGGAT
    AGTTCAATCA ATTCATCTTC CTCGTTCTCT GATCAAAAAG AGCAATGCCC AAAATACCAG
    GGTTCTCGGT GCTCCTCAGA TGCCAGCATG CTTGGAGAGA TGATGTTTGG CTCTGTGGCT
    ATGAGCTACA AGGGCTCCAC ACTGAAAATT CATCAGATCC GCTCCCCTCC CCAGCTCATG
    CTCAGCAAGG TGTTCACAGC TCGCACGGGA AGCAGCATCT ATGGCAGTCT GAACACGTTG
    CAGGACAGTC TTGAGTTCAT TAATCAAGAC AGCAATACAT TAAAGCCTGA CCACAGTACA
    ATTATGAATG GACTTCTTGG GAACATAGGT CTTTCCCAGC TTTGCAGCCC CAGGCGGGCA
    TTCTCAGAGC AAGGTCCGCT CCGCCTCATC CGGAGCGCCT CTTTCTTTGC AGTTCATAGC
    AACCCTATGG ATATGCCTGG GAGGGAGCAG AATGAGGACA GAGACAGCGG TATAGCAAGA
    TCTGCATCTC TTAGCAGTCT GCTCATCACT CCGTTTCCAT CTCCGGGCTC CTCATTTAAC
    AAGAGCTGTG CCAGCAGCTA CCAGCGGCGT TGGCGTCGCA GCCAGACGAC CAGCTTGGAG
    AATGGGGTCT TCCCTCGATG GTCCATGGAT GAAAGCTTCA GCTTGTCAGA TGACAGCTCT
    GGTCCAAACC CAGGAATTGT TAGGAAGAAA AAGATAGCAA TTGGGGTTAT TTTTTCACTC
    TCAAGAGATG AAGATGAAAA CAACAAATTT AACGAGTTCT TTTTTTCACA CTTCCCTCTT
    TTTGAAAGTC ACATGAACAA ACTGAAGAGT GCAATAGAAC AGGCCATGAA AATGAGTCGG
    AGATCAGCTG ATGCCAGCCA GCGGAGTTTG GCATATAACA GAATTGTGGA TGCCCTAAAT
    GAGTTTAGAA CAACTATTTG CAATCTCTAC ACAATGCCAC GGATTGGGGA GCCTGTCTGG
    CTCACCATGA TGTCAGGGAC ACCAGAGAAG AACCAGCTAT GCCATCGCTT CATGAAGGAG
    TTCACTTTCT TGATGGAAAA TGCTTCTAAA AATCAGTTTT TACCAGCTTT GCTGACTGCA
    GTGCTGACTA ACCACCTGGC CTGGGTCCCC ACTGTCATGC CCAATGGCCA ACCACCCATA
    AGAATCTTCC TGGAGAAGCA TTCTTCCCAG AGTGTGGACA TGCTGGCCAA AACTCATCCC
    TACAACCCAC TGTGGGCTCA GCTCGGTGAC CTCTATGGGG CCATTGGATC ACCTGTGAGA
    TTAGCAAAAA CGGTCGTGGT TGGCAAAAGA CATGACCTGG TCCAGAGATT GCTTTATTTC
    CTCACTTACT TCATCAGATG CTCTGAACTT CAAGAGACAC ATCTTCTGGA AAACGGGGAA
    GATGAGGCCA TCGTCATGCC TGGCACTGTT ATCACTACCA CACTGGAGAA AGGAGAAGTG
    GAAGAGTCTG AGTATGTGCT TGTCACAATG CACAAAAACA GGGGCAACTT GCTACCCACG
    GAGTCAGAAG AGATGAGAGT TCCCAACTGC AGCTGTAAAT ATTGCAAATG TCCTGTTTCC
    CTCGCACAGA ACATAGAAGG TGTTGCACAG CAAGAGAGAG AAGACATGCA AAGCACTCCT
    AAGGTAGAGC TAGATTCTTC TTCAGATGAG AACAGAACCA TCATTCCTGA AGGCCAGGAA
    GATGCTGTGG ATGTGACACA ACCAAGGCCC TGCCTGGATA CCAAACTAGA GACTGTGGTG
    TGTACAGGGT CAGCTTCGCC TGAGAAATGC GTGGGGACAG AATCTTGTTT GGAGCCAGCG
    GCAGGCACGT GGAGGAGTGA GGATGTGCTG GAGCCGGGCA GCCAGGCGGG AGGTGGGACA
    AGGACACCCG GGGTTGCTGT GGAGAAGAAG CCACCCGATA AGCTCTTCAT GGACACGTTT
    CCATGCAGCG CTGCCGAGGC TCAGACAAAG GTGACTTTCC TCATCGGAGA TTCCATGTCA
    CCTGACTCAG ACATTGAACT GAGAAGTCAG GCAGTAGTGG AACAAATTGC CAGGCATCAC
    AGCCCGCCAG CAGCAGAGGC AGGAGTGTCT GCTGATCAGA ACTGTGAAGC TAAACAAACT
    GTTGAGGACC AAAATAGAGA CTGTGGTACA GCTGAACCCT TTCCTCAAGT TGCTAGTGAG
    CATCAGAGCT GGAACCCAAA CCCATACAGT GCTGAGAGCA TGAGTCTGTT TGATGAATAT
    TTCACTGATG ACAGTGCAGT TGAAACCCGG ACTACTGATG ATATTCCAGG GCAAGCAGCT
    ACAAACCTTC TTGCTCACAA CAGTAGTTTA GAATTTTCTA AAAAGCTGTG TACAAAGGCT
    TGCAAACCAC CTAGTGAATT TTGTAAATTT ATGGACTGTG TTCAACAAGA CACCTACAAA
    AACTGCTTTA ATGAGCAGGA CCAAAGAGAG AAAATCTCTG TTCGCATCCC CCATGGGGAC
    AGAGAAAACA TAGAGAAAAA AGTTGCCCCA GGAATTGACT GGGACATTCC AAGAAATGAG
    AGTTCAGATA GTGCCCTGGG TGACAGTGAA AGTGAGGATA CAGGCCATGA TCTAACTAGA
    CTGGGCAGTA ACTATTACGG AGGAGAGCAA GAAGATTGGG CAGAGGAATA TGAGATTCCC
    TTCCCTGGGT CAAAATTAGT TGAAGTCAAC TCTGTCCAGC CCAGTATTGC TAATTTTGGA
    AGATCCTTAC TAGGAGGCTA CTGTTCATCT TACGTCCCTG ACTTTGTTTT GCAAGGAATA
    GGAAGTGATG AAAAGCTGAG GCACTGTTTG GTGTCAGATT TATCTCATGC TGTGCAGCAC
    CCTGTTCTGG ATGAGCCCAT TGCAGAAGCT GTCTGCATTA TTGCAGACAC GGACAAATGG
    ACGGTGCAAG TGGCCAGTAG CCAGAGGCGA ATGACTGAGA ATAAACTAGG AAAAGAAGTG
    TTAGTCTCCA GTCTCGTCTC CAACCTGCTT CATTCCACTC TTCAGCTTTA CAAGCATAAT
    TTATCTCCAA ACTTTTGTGT GATGCACCTG GAAGATCGGC TGCAGGAGCT CTACTTCAAA
    AGCAAGATGC TGTCTGAGTA TCTCAAGGGC CAGATGAGAG TCCATGTCAA GGAGCTGGGT
    GTGGTGCTGG GGATTGAATC CAGCGACCTC CCCTTGCTGG CAGCTGTAGC AAGCACTCAC
    TCTCCATATG TTGCCCAGAT TCTACTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014108630.1
    CDS78..3587
    Translation

    Target ORF information:

    RefSeq Version XM_014253155.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis folliculin interacting protein 1 (FNIP1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014253155.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGCCGCCTA CCCTCTTCCA GAAGCTCTTC AACAAGAAGC ATGGGCTGAT CTCCCCCGCC 
    AGGGATGCCC GCGACGACTG TATCTTCAGC TGGCCTTTGC CGGAGTTTGA CCCAAGTCAG
    ATCCGACTAA TTGTGTATCA GGACTGTGAA AGAAGAGGAC GGAATGTCTT ATTTGATTCC
    AGTGCTAAAA GAAAAATAGA GGATGTTTCA GTGTCGAAAC TCTGCAGTGA TGCTCAAGTG
    AGAGTTTTTG GGAAATGTTG CCAACTAAAG CCTGGAGGAG ACAGTTCTTC TTCCTTGGAT
    AGTTCAATCA ATTCATCTTC CTCGTTCTCT GATCAAAAAG AGCAATGCCC AAAATACCAG
    GGTTCTCGGT GCTCCTCAGA TGCCAGCATG CTTGGAGAGA TGATGTTTGG CTCTGTGGCT
    ATGAGCTACA AGGGCTCCAC ACTGAAAATT CATCAGATCC GCTCCCCTCC CCAGCTCATG
    CTCAGCAAGG TGTTCACAGC TCGCACGGGA AGCAGCATCT ATGGCAGTCT GAACACGTTG
    CAGGACAGTC TTGAGTTCAT TAATCAAGAC AGCAATACAT TAAAGCCTGA CCACAGTACA
    ATTATGAATG GACTTCTTGG GAACATAGGT CTTTCCCAGC TTTGCAGCCC CAGGCGGGCA
    TTCTCAGAGC AAGGTCCGCT CCGCCTCATC CGGAGCGCCT CTTTCTTTGC AGTTCATAGC
    AACCCTATGG ATATGCCTGG GAGGGAGCAG AATGAGGACA GAGACAGCGG TATAGCAAGA
    TCTGCATCTC TTAGCAGTCT GCTCATCACT CCGTTTCCAT CTCCGGGCTC CTCATTTAAC
    AAGAGCTGTG CCAGCAGCTA CCAGCGGCGT TGGCGTCGCA GCCAGACGAC CAGCTTGGAG
    AATGGGGTCT TCCCTCGATG GTCCATGGAT GAAAGCTTCA GCTTGTCAGA TGACAGCTCT
    GGTCCAAACC CAGGAATTGT TAGGAAGAAA AAGATAGCAA TTGGGGTTAT TTTTTCACTC
    TCAAGAGATG AAGATGAAAA CAACAAATTT AACGAGTTCT TTTTTTCACA CTTCCCTCTT
    TTTGAAAGTC ACATGAACAA ACTGAAGAGT GCAATAGAAC AGGCCATGAA AATGAGTCGG
    AGATCAGCTG ATGCCAGCCA GCGGAGTTTG GCATATAACA GAATTGTGGA TGCCCTAAAT
    GAGTTTAGAA CAACTATTTG CAATCTCTAC ACAATGCCAC GGATTGGGGA GCCTGTCTGG
    CTCACCATGA TGTCAGGGAC ACCAGAGAAG AACCAGCTAT GCCATCGCTT CATGAAGGAG
    TTCACTTTCT TGATGGAAAA TGCTTCTAAA AATCAGTTTT TACCAGCTTT GCTGACTGCA
    GTGCTGACTA ACCACCTGGC CTGGGTCCCC ACTGTCATGC CCAATGGCCA ACCACCCATA
    AGAATCTTCC TGGAGAAGCA TTCTTCCCAG AGTGTGGACA TGCTGGCCAA AACTCATCCC
    TACAACCCAC TGTGGGCTCA GCTCGGTGAC CTCTATGGGG CCATTGGATC ACCTGTGAGA
    TTAGCAAAAA CGGTCGTGGT TGGCAAAAGA CATGACCTGG TCCAGAGATT GCTTTATTTC
    CTCACTTACT TCATCAGATG CTCTGAACTT CAAGAGACAC ATCTTCTGGA AAACGGGGAA
    GATGAGGCCA TCGTCATGCC TGGCACTGTT ATCACTACCA CACTGGAGAA AGGAGAAGTG
    GAAGAGTCTG AGTATGTGCT TGTCACAATG CACAAAAACA GGGGCAACTT GCTACCCACG
    GAGTCAGAAG AGATGAGAGT TCCCAACTGC AGCTGTAAAT ATTGCAAATG TCCTGTTTCC
    CTCGCACAGA ACATAGAAGG TGTTGCACAG CAAGAGAGAG AAGACATGCA AAGCACTCCT
    AAGGTAGAGC TAGATTCTTC TTCAGATGAG AACAGAACCA TCATTCCTGA AGGCCAGGAA
    GATGCTGTGG ATGTGACACA ACCAAGGCCC TGCCTGGATA CCAAACTAGA GACTGTGGTG
    TGTACAGGGT CAGCTTCGCC TGAGAAATGC GTGGGGACAG AATCTTGTTT GGAGCCAGCG
    GCAGGCACGT GGAGGAGTGA GGATGTGCTG GAGCCGGGCA GCCAGGCGGG AGGTGGGACA
    AGGACACCCG GGGTTGCTGT GGAGAAGAAG CCACCCGATA AGCTCTTCAT GGACACGTTT
    CCATGCAGCG CTGCCGAGGC TCAGACAAAG GTGACTTTCC TCATCGGAGA TTCCATGTCA
    CCTGACTCAG ACATTGAACT GAGAAGTCAG GCAGTAGTGG AACAAATTGC CAGGCATCAC
    AGCCCGCCAG CAGCAGAGGC AGGAGTGTCT GCTGATCAGA ACTGTGAAGC TAAACAAACT
    GTTGAGGACC AAAATAGAGA CTGTGGTACA GCTGAACCCT TTCCTCAAGT TGCTAGTGAG
    CATCAGAGCT GGAACCCAAA CCCATACAGT GCTGAGAGCA TGAGTCTGTT TGATGAATAT
    TTCACTGATG ACAGTGCAGT TGAAACCCGG ACTACTGATG ATATTCCAGG GCAAGCAGCT
    ACAAACCTTC TTGCTCACAA CAGTAGTTTA GAATTTTCTA AAAAGCTGTG TACAAAGGCT
    TGCAAACCAC CTAGTGAATT TTGTAAATTT ATGGACTGTG TTCAACAAGA CACCTACAAA
    AACTGCTTTA ATGAGCAGGA CCAAAGAGAG AAAATCTCTG TTCGCATCCC CCATGGGGAC
    AGAGAAAACA TAGAGAAAAA AGTTGCCCCA GGAATTGACT GGGACATTCC AAGAAATGAG
    AGTTCAGATA GTGCCCTGGG TGACAGTGAA AGTGAGGATA CAGGCCATGA TCTAACTAGA
    CTGGGCAGTA ACTATTACGG AGGAGAGCAA GAAGATTGGG CAGAGGAATA TGAGATTCCC
    TTCCCTGGGT CAAAATTAGT TGAAGTCAAC TCTGTCCAGC CCAGTATTGC TAATTTTGGA
    AGATCCTTAC TAGGAGGCTA CTGTTCATCT TACGTCCCTG ACTTTGTTTT GCAAGGAATA
    GGAAGTGATG AAAAGCTGAG GCACTGTTTG GTGTCAGATT TATCTCATGC TGTGCAGCAC
    CCTGTTCTGG ATGAGCCCAT TGCAGAAGCT GTCTGCATTA TTGCAGACAC GGACAAATGG
    ACGGTGCAAG TGGCCAGTAG CCAGAGGCGA ATGACTGAGA ATAAACTAGG AAAAGAAGTG
    TTAGTCTCCA GTCTCGTCTC CAACCTGCTT CATTCCACTC TTCAGCTTTA CAAGCATAAT
    TTATCTCCAA ACTTTTGTGT GATGCACCTG GAAGATCGGC TGCAGGAGCT CTACTTCAAA
    AGCAAGATGC TGTCTGAGTA TCTCAAGGGC CAGATGAGAG TCCATGTCAA GGAGCTGGGT
    GTGGTGCTGG GGATTGAATC CAGCGACCTC CCCTTGCTGG CAGCTGTAGC AAGCACTCAC
    TCTCCATATG TTGCCCAGAT TCTACTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs14647
    Clone ID Related Accession (Same CDS sequence) XM_014253156.1
    Accession Version XM_014253156.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3426bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product folliculin-interacting protein 1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087571.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCGCCTA CCCTCTTCCA GAAGCTCTTC AACAAGAAGC ATGGGCTGAT CTCCCCCGCC 
    AGGGATGCCC GCGACGACTG TATCTTCAGC TGGCCTTTGC CGGAGTTTGA CCCAAGTCAG
    ATCCGACTAA TTGTGTATCA GGACTGTGAA AGAAGAGGAC GGAATGTCTT ATTTGATTCC
    AGTGCTAAAA GAAAAATAGA GGATGTTTCA GTGTCGAAAC TCTGCAGTGA TGCTCAAGTG
    AGAGTTTTTG GGAAATGTTG CCAACTAAAG CCTGGAGGAG ACAGTTCTTC TTCCTTGGAT
    AGTTCAATCA ATTCATCTTC CTCGTTCTCT GATCAAAAAG AGCAATGCCC AAAATACCAG
    GGTTCTCGGT GCTCCTCAGA TGCCAGCATG CTTGGAGAGA TGATGTTTGG CTCTGTGGCT
    ATGAGCTACA AGGGCTCCAC ACTGAAAATT CATCAGATCC GCTCCCCTCC CCAGCTCATG
    CTCAGCAAGG TGTTCACAGC TCGCACGGGA AGCAGCATCT ATGGCAGTCT GAACACGTTG
    CAGGACAGTC TTGAGTTCAT TAATCAAGAC AGCAATACAT TAAAGCCTGA CCACAGTACA
    ATTATGAATG GACTTCTTGG GAACATAGTT CATAGCAACC CTATGGATAT GCCTGGGAGG
    GAGCAGAATG AGGACAGAGA CAGCGGTATA GCAAGATCTG CATCTCTTAG CAGTCTGCTC
    ATCACTCCGT TTCCATCTCC GGGCTCCTCA TTTAACAAGA GCTGTGCCAG CAGCTACCAG
    CGGCGTTGGC GTCGCAGCCA GACGACCAGC TTGGAGAATG GGGTCTTCCC TCGATGGTCC
    ATGGATGAAA GCTTCAGCTT GTCAGATGAC AGCTCTGGTC CAAACCCAGG AATTGTTAGG
    AAGAAAAAGA TAGCAATTGG GGTTATTTTT TCACTCTCAA GAGATGAAGA TGAAAACAAC
    AAATTTAACG AGTTCTTTTT TTCACACTTC CCTCTTTTTG AAAGTCACAT GAACAAACTG
    AAGAGTGCAA TAGAACAGGC CATGAAAATG AGTCGGAGAT CAGCTGATGC CAGCCAGCGG
    AGTTTGGCAT ATAACAGAAT TGTGGATGCC CTAAATGAGT TTAGAACAAC TATTTGCAAT
    CTCTACACAA TGCCACGGAT TGGGGAGCCT GTCTGGCTCA CCATGATGTC AGGGACACCA
    GAGAAGAACC AGCTATGCCA TCGCTTCATG AAGGAGTTCA CTTTCTTGAT GGAAAATGCT
    TCTAAAAATC AGTTTTTACC AGCTTTGCTG ACTGCAGTGC TGACTAACCA CCTGGCCTGG
    GTCCCCACTG TCATGCCCAA TGGCCAACCA CCCATAAGAA TCTTCCTGGA GAAGCATTCT
    TCCCAGAGTG TGGACATGCT GGCCAAAACT CATCCCTACA ACCCACTGTG GGCTCAGCTC
    GGTGACCTCT ATGGGGCCAT TGGATCACCT GTGAGATTAG CAAAAACGGT CGTGGTTGGC
    AAAAGACATG ACCTGGTCCA GAGATTGCTT TATTTCCTCA CTTACTTCAT CAGATGCTCT
    GAACTTCAAG AGACACATCT TCTGGAAAAC GGGGAAGATG AGGCCATCGT CATGCCTGGC
    ACTGTTATCA CTACCACACT GGAGAAAGGA GAAGTGGAAG AGTCTGAGTA TGTGCTTGTC
    ACAATGCACA AAAACAGGGG CAACTTGCTA CCCACGGAGT CAGAAGAGAT GAGAGTTCCC
    AACTGCAGCT GTAAATATTG CAAATGTCCT GTTTCCCTCG CACAGAACAT AGAAGGTGTT
    GCACAGCAAG AGAGAGAAGA CATGCAAAGC ACTCCTAAGG TAGAGCTAGA TTCTTCTTCA
    GATGAGAACA GAACCATCAT TCCTGAAGGC CAGGAAGATG CTGTGGATGT GACACAACCA
    AGGCCCTGCC TGGATACCAA ACTAGAGACT GTGGTGTGTA CAGGGTCAGC TTCGCCTGAG
    AAATGCGTGG GGACAGAATC TTGTTTGGAG CCAGCGGCAG GCACGTGGAG GAGTGAGGAT
    GTGCTGGAGC CGGGCAGCCA GGCGGGAGGT GGGACAAGGA CACCCGGGGT TGCTGTGGAG
    AAGAAGCCAC CCGATAAGCT CTTCATGGAC ACGTTTCCAT GCAGCGCTGC CGAGGCTCAG
    ACAAAGGTGA CTTTCCTCAT CGGAGATTCC ATGTCACCTG ACTCAGACAT TGAACTGAGA
    AGTCAGGCAG TAGTGGAACA AATTGCCAGG CATCACAGCC CGCCAGCAGC AGAGGCAGGA
    GTGTCTGCTG ATCAGAACTG TGAAGCTAAA CAAACTGTTG AGGACCAAAA TAGAGACTGT
    GGTACAGCTG AACCCTTTCC TCAAGTTGCT AGTGAGCATC AGAGCTGGAA CCCAAACCCA
    TACAGTGCTG AGAGCATGAG TCTGTTTGAT GAATATTTCA CTGATGACAG TGCAGTTGAA
    ACCCGGACTA CTGATGATAT TCCAGGGCAA GCAGCTACAA ACCTTCTTGC TCACAACAGT
    AGTTTAGAAT TTTCTAAAAA GCTGTGTACA AAGGCTTGCA AACCACCTAG TGAATTTTGT
    AAATTTATGG ACTGTGTTCA ACAAGACACC TACAAAAACT GCTTTAATGA GCAGGACCAA
    AGAGAGAAAA TCTCTGTTCG CATCCCCCAT GGGGACAGAG AAAACATAGA GAAAAAAGTT
    GCCCCAGGAA TTGACTGGGA CATTCCAAGA AATGAGAGTT CAGATAGTGC CCTGGGTGAC
    AGTGAAAGTG AGGATACAGG CCATGATCTA ACTAGACTGG GCAGTAACTA TTACGGAGGA
    GAGCAAGAAG ATTGGGCAGA GGAATATGAG ATTCCCTTCC CTGGGTCAAA ATTAGTTGAA
    GTCAACTCTG TCCAGCCCAG TATTGCTAAT TTTGGAAGAT CCTTACTAGG AGGCTACTGT
    TCATCTTACG TCCCTGACTT TGTTTTGCAA GGAATAGGAA GTGATGAAAA GCTGAGGCAC
    TGTTTGGTGT CAGATTTATC TCATGCTGTG CAGCACCCTG TTCTGGATGA GCCCATTGCA
    GAAGCTGTCT GCATTATTGC AGACACGGAC AAATGGACGG TGCAAGTGGC CAGTAGCCAG
    AGGCGAATGA CTGAGAATAA ACTAGGAAAA GAAGTGTTAG TCTCCAGTCT CGTCTCCAAC
    CTGCTTCATT CCACTCTTCA GCTTTACAAG CATAATTTAT CTCCAAACTT TTGTGTGATG
    CACCTGGAAG ATCGGCTGCA GGAGCTCTAC TTCAAAAGCA AGATGCTGTC TGAGTATCTC
    AAGGGCCAGA TGAGAGTCCA TGTCAAGGAG CTGGGTGTGG TGCTGGGGAT TGAATCCAGC
    GACCTCCCCT TGCTGGCAGC TGTAGCAAGC ACTCACTCTC CATATGTTGC CCAGATTCTA
    CTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014108631.1
    CDS78..3503
    Translation

    Target ORF information:

    RefSeq Version XM_014253156.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis folliculin interacting protein 1 (FNIP1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014253156.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGCCGCCTA CCCTCTTCCA GAAGCTCTTC AACAAGAAGC ATGGGCTGAT CTCCCCCGCC 
    AGGGATGCCC GCGACGACTG TATCTTCAGC TGGCCTTTGC CGGAGTTTGA CCCAAGTCAG
    ATCCGACTAA TTGTGTATCA GGACTGTGAA AGAAGAGGAC GGAATGTCTT ATTTGATTCC
    AGTGCTAAAA GAAAAATAGA GGATGTTTCA GTGTCGAAAC TCTGCAGTGA TGCTCAAGTG
    AGAGTTTTTG GGAAATGTTG CCAACTAAAG CCTGGAGGAG ACAGTTCTTC TTCCTTGGAT
    AGTTCAATCA ATTCATCTTC CTCGTTCTCT GATCAAAAAG AGCAATGCCC AAAATACCAG
    GGTTCTCGGT GCTCCTCAGA TGCCAGCATG CTTGGAGAGA TGATGTTTGG CTCTGTGGCT
    ATGAGCTACA AGGGCTCCAC ACTGAAAATT CATCAGATCC GCTCCCCTCC CCAGCTCATG
    CTCAGCAAGG TGTTCACAGC TCGCACGGGA AGCAGCATCT ATGGCAGTCT GAACACGTTG
    CAGGACAGTC TTGAGTTCAT TAATCAAGAC AGCAATACAT TAAAGCCTGA CCACAGTACA
    ATTATGAATG GACTTCTTGG GAACATAGTT CATAGCAACC CTATGGATAT GCCTGGGAGG
    GAGCAGAATG AGGACAGAGA CAGCGGTATA GCAAGATCTG CATCTCTTAG CAGTCTGCTC
    ATCACTCCGT TTCCATCTCC GGGCTCCTCA TTTAACAAGA GCTGTGCCAG CAGCTACCAG
    CGGCGTTGGC GTCGCAGCCA GACGACCAGC TTGGAGAATG GGGTCTTCCC TCGATGGTCC
    ATGGATGAAA GCTTCAGCTT GTCAGATGAC AGCTCTGGTC CAAACCCAGG AATTGTTAGG
    AAGAAAAAGA TAGCAATTGG GGTTATTTTT TCACTCTCAA GAGATGAAGA TGAAAACAAC
    AAATTTAACG AGTTCTTTTT TTCACACTTC CCTCTTTTTG AAAGTCACAT GAACAAACTG
    AAGAGTGCAA TAGAACAGGC CATGAAAATG AGTCGGAGAT CAGCTGATGC CAGCCAGCGG
    AGTTTGGCAT ATAACAGAAT TGTGGATGCC CTAAATGAGT TTAGAACAAC TATTTGCAAT
    CTCTACACAA TGCCACGGAT TGGGGAGCCT GTCTGGCTCA CCATGATGTC AGGGACACCA
    GAGAAGAACC AGCTATGCCA TCGCTTCATG AAGGAGTTCA CTTTCTTGAT GGAAAATGCT
    TCTAAAAATC AGTTTTTACC AGCTTTGCTG ACTGCAGTGC TGACTAACCA CCTGGCCTGG
    GTCCCCACTG TCATGCCCAA TGGCCAACCA CCCATAAGAA TCTTCCTGGA GAAGCATTCT
    TCCCAGAGTG TGGACATGCT GGCCAAAACT CATCCCTACA ACCCACTGTG GGCTCAGCTC
    GGTGACCTCT ATGGGGCCAT TGGATCACCT GTGAGATTAG CAAAAACGGT CGTGGTTGGC
    AAAAGACATG ACCTGGTCCA GAGATTGCTT TATTTCCTCA CTTACTTCAT CAGATGCTCT
    GAACTTCAAG AGACACATCT TCTGGAAAAC GGGGAAGATG AGGCCATCGT CATGCCTGGC
    ACTGTTATCA CTACCACACT GGAGAAAGGA GAAGTGGAAG AGTCTGAGTA TGTGCTTGTC
    ACAATGCACA AAAACAGGGG CAACTTGCTA CCCACGGAGT CAGAAGAGAT GAGAGTTCCC
    AACTGCAGCT GTAAATATTG CAAATGTCCT GTTTCCCTCG CACAGAACAT AGAAGGTGTT
    GCACAGCAAG AGAGAGAAGA CATGCAAAGC ACTCCTAAGG TAGAGCTAGA TTCTTCTTCA
    GATGAGAACA GAACCATCAT TCCTGAAGGC CAGGAAGATG CTGTGGATGT GACACAACCA
    AGGCCCTGCC TGGATACCAA ACTAGAGACT GTGGTGTGTA CAGGGTCAGC TTCGCCTGAG
    AAATGCGTGG GGACAGAATC TTGTTTGGAG CCAGCGGCAG GCACGTGGAG GAGTGAGGAT
    GTGCTGGAGC CGGGCAGCCA GGCGGGAGGT GGGACAAGGA CACCCGGGGT TGCTGTGGAG
    AAGAAGCCAC CCGATAAGCT CTTCATGGAC ACGTTTCCAT GCAGCGCTGC CGAGGCTCAG
    ACAAAGGTGA CTTTCCTCAT CGGAGATTCC ATGTCACCTG ACTCAGACAT TGAACTGAGA
    AGTCAGGCAG TAGTGGAACA AATTGCCAGG CATCACAGCC CGCCAGCAGC AGAGGCAGGA
    GTGTCTGCTG ATCAGAACTG TGAAGCTAAA CAAACTGTTG AGGACCAAAA TAGAGACTGT
    GGTACAGCTG AACCCTTTCC TCAAGTTGCT AGTGAGCATC AGAGCTGGAA CCCAAACCCA
    TACAGTGCTG AGAGCATGAG TCTGTTTGAT GAATATTTCA CTGATGACAG TGCAGTTGAA
    ACCCGGACTA CTGATGATAT TCCAGGGCAA GCAGCTACAA ACCTTCTTGC TCACAACAGT
    AGTTTAGAAT TTTCTAAAAA GCTGTGTACA AAGGCTTGCA AACCACCTAG TGAATTTTGT
    AAATTTATGG ACTGTGTTCA ACAAGACACC TACAAAAACT GCTTTAATGA GCAGGACCAA
    AGAGAGAAAA TCTCTGTTCG CATCCCCCAT GGGGACAGAG AAAACATAGA GAAAAAAGTT
    GCCCCAGGAA TTGACTGGGA CATTCCAAGA AATGAGAGTT CAGATAGTGC CCTGGGTGAC
    AGTGAAAGTG AGGATACAGG CCATGATCTA ACTAGACTGG GCAGTAACTA TTACGGAGGA
    GAGCAAGAAG ATTGGGCAGA GGAATATGAG ATTCCCTTCC CTGGGTCAAA ATTAGTTGAA
    GTCAACTCTG TCCAGCCCAG TATTGCTAAT TTTGGAAGAT CCTTACTAGG AGGCTACTGT
    TCATCTTACG TCCCTGACTT TGTTTTGCAA GGAATAGGAA GTGATGAAAA GCTGAGGCAC
    TGTTTGGTGT CAGATTTATC TCATGCTGTG CAGCACCCTG TTCTGGATGA GCCCATTGCA
    GAAGCTGTCT GCATTATTGC AGACACGGAC AAATGGACGG TGCAAGTGGC CAGTAGCCAG
    AGGCGAATGA CTGAGAATAA ACTAGGAAAA GAAGTGTTAG TCTCCAGTCT CGTCTCCAAC
    CTGCTTCATT CCACTCTTCA GCTTTACAAG CATAATTTAT CTCCAAACTT TTGTGTGATG
    CACCTGGAAG ATCGGCTGCA GGAGCTCTAC TTCAAAAGCA AGATGCTGTC TGAGTATCTC
    AAGGGCCAGA TGAGAGTCCA TGTCAAGGAG CTGGGTGTGG TGCTGGGGAT TGAATCCAGC
    GACCTCCCCT TGCTGGCAGC TGTAGCAAGC ACTCACTCTC CATATGTTGC CCAGATTCTA
    CTTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.