LOC105625187 cDNA ORF clone, Atta cephalotes

The following LOC105625187 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105625187 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAt120075 XM_012206527.1
Latest version!
Atta cephalotes uncharacterized LOC105625187 (LOC105625187), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $629.30
$899.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAt120075
    Clone ID Related Accession (Same CDS sequence) XM_012206527.1
    Accession Version XM_012206527.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3243bp)
    Protein sequence
    SNP
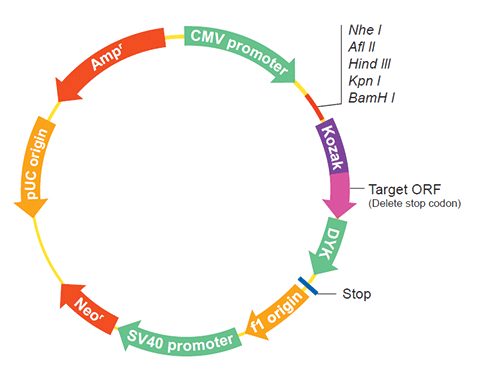
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-04-01
    Organism Atta cephalotes
    Product uncharacterized protein LOC105625187
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_012130304.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Atta cephalotes Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGTCAGCGG TATATCCGAA GCTAGCAGTG AGAGACAATC TCGACGATGA TGATCTCACC 
    GACATCGATG ATGAAGTATT TATTAGGGAT GGGAGAAACG GTGGATTGAA ATTAGACGAC
    GATGGTGGAG TGAAACAGCC TCTCATGGCA CCTCGTAGAA AATGCAAAAA GCCCTGCAAC
    TTGGAGAATC ATAAGATCCC ATATAACATG CTTCTTGTGC CAGTGTGCTG TGGAACTACA
    GCATTGATTG TGCTATTAGG CTTAATTGTA GTTTGTATAT TTACTGCAAA TATATTCCCA
    ATGCCATTAA CTATACTGAA AAGCTGGATG TCACATGATT TAAAAAATCC TATAAATGAA
    TCTGAGATAA TTCCATGTAC CTCACTCTCG TCCAGTGTTT TATGGGCCAG ATCATTTCCA
    AAGTTAACAC CTGAGGCACC TCTTAGGAGT AATGATGTTA ACTCTGATGG AATTGAAGAC
    ATTATTGTAG GATTTAGTAC AGGTCTGGAT ATGATGGATA CAGAATATAT CTGTACTATA
    TATTTTGGGA ATCAAACGCC GTGTCTAGGC GGTGTACTAG CACTGAATGG TAAAACAGGT
    GAACCTATCT GGACACATTG GACTGCTCAT TCCATACTTT CTGTTGATTG CGATGCAGAT
    TTGACGAATG ATAAAGTTAA GGATTGTATC ATATCTGGAC GTGGTGGAAT ACTGCAAGCT
    ATTGATGGCC ATGATGGTTC CAATATATGG AAAATACCAC TTCAAGATCT AATTTCTGAG
    TTACAAATAA TTTCGGATGT CTATGATGCA AGATTTATAG CTGATATGGA TGGCGACGGT
    ATTGCCGATG TAATAGCATC GCATGTTGTA CAATCAGATA ATATTCAAGC AAGTAATGTA
    CTTGTAATAT CGGGTAAAAG TGGCAGTGTC ATACGCAATA TGAATTTACC AGATACTGAG
    CAATTGTTCG TAGCACCGCA AATTATAGTG CATCCTGATG GAGAAAATAT ATTCGTTCTA
    GCTACAACCA GTCAACAAGA TTCTGGAGGA TTATATATAG TGTCTCAAGC TAATATATTT
    TACGGTGATT TGCAATTGCA AAAACTCAAT CATAACACTG GCAAAAATGC GCTGTTGCCA
    CCGATTTTAA TCGATATTAC ATCTGATGGA ATTGAAGACA TTGTCGCTGC TATGTTCAAT
    TCTACGATTA TAGCATACAA TGGAACTACG TTTGAGCCTA TCTGGAATTA CACAGTTCCC
    AATTCCGAAG TAATTAGCAT TCCCATTCCC GGTTATTATA ATGACGACGA TATACCAGAC
    TTTATGGTGA AGCATCAGAT AGGAACTGGC TTATCCACAT ACTATTACAC TGTAGCTACA
    GTTATAGATG GTCGTAATGG GCAACCTTTG CTCGAGAAAC CAATGGAGGA TAGTTTAAGT
    GGGCAAATGT CTGGATTATC GGTCACTGTC GATGGGTTTG GCAATGATTG GTTTTTACAT
    TGGTCTACCG ACTGTTTAAA TTATGAAGGA ATCAAGGAAA AATATCAGTT CTTAAAAGGT
    CAGAGTTTCA TGTCGCAAAC TCGCACTGAT CTCTGCTCTC TAAGATTCAA TTCGACGCTT
    ACTATGAGAT TACTAGCTTT GAGTCAACAT GTCGGCCCGC CTGGATTGTC GTTATACTTC
    TCGGAGGACT GGAAGTCGGT AGAGTTCAAT AATTCAGTCG ATCTACGAAA AGAAGAGGAA
    AAGAATCTGA AATCCCATTC GCGATTAAAG GTCACGGATA CTTATTCAAA CATACCACTC
    GTTTCCGAGA GATCGCCAAA AATTCATAAA AATCATCGGA AAGATAGCAT TTTCAAACAC
    AAAGATAGTC TACTCGAAAT TGGCAAATAT GATTCGGACG CGATATATGA GAACTTCGAC
    GAATTCAAGA GCCATAAGAA ACATAATCCC GAAGACATTG TAGAGAATTT GAACGTAGAT
    CAAGCATGGA AACAAGATAA CAAATGGATG GAGGATGATG TGCAGCCGGA TAAAGAGTAT
    GATAGTATAT ACGAAAATGA TAACGGTAAC AATGAAGACA GACAGAGTGT AGATTATTCG
    CAAGGTGAAG TGCGAGAACA GAGAAGTGTC ATTCCCGTGG TTAAAAATAT ATATTCGATA
    AATATTTCTC ATAAAGAAAT TAATTCAACA CCTGAATCGA CGCGACATAG TTTACGACTG
    AATGAAGAAA TTAACACAGA AAAAAAGAGA AAAATGGAAG AAATCAATAA AAAAAATAGC
    TCAATGAACG AAGCTGATGA TATAATGAAT ATATCAATGA CATCAACTTC CCAATTTTCA
    GAGTTATCAT TAATTATGTC AAATAAATCA AATATCGAAA AGAGTACTAC AATACAGAAT
    GTATTAAAGA CGAGCGAATT AATAGAAATA AAGAGCATAA ATATAAGTAC AGAATTGCCT
    GAGGACACAC ATACTGAAGC ATCAAATGTT ACTAAAAATC AAATAATCAC TGGTCCAGAT
    GCAACTTCCA CTATTAAGAA AGTCGTAGAC ATACCTCAGC GAAGACACAT TTATAAACAT
    AGTTTCCCTA GTATTGTCCA AGACGCGGAT GATGATGCTA GTATAGAAAA AGTATTTAAA
    CGGGAATCAC TGAAAAATCA AAGTAAAGGC AAGATTAATA AGAAGCAATT ACTAATATTA
    TCGTCAACTG ATAAAGTTGT TAAAACACGA CAGAAACGAA GAACGAAACG AAACTCGGAA
    ATTAACAACA ACCAGTCGAA CGGTATCAAT GGTATTCAAA AGCAGGCACC AACCGGTATT
    CTGCTACCGT CTATTATCGA ATCCAAAGAA AAGACATCGA TAGATTTAGT GTTTCCTACG
    TTCTGGTTAC CGTCGTCTGA AGTGTCTCTG ATCTTGTCTC GAGCAGATGT GGAGTGCATT
    GACAAGAAGA AAGCATTATT AGAGGATAAA CTAGAGTACA AAAAAGATGA CGACATTATC
    AGCGAATGTT TATCCGAGCG AGGCATTAAT TACAGATTAT ATCAAGAGGC AATGGATAGA
    GAAAATACCA AAATCGCATT TGGTCAAATG ACAATATACA GGATGAAACT AGAATGCGTA
    TGTCCAGAGG ATATGCTACC TAATCAAACA TGCAAAAATA TTTCAATACA TCAAAGCTGG
    CCAGAATATT TAGGATCTTC TGGAAATGGC TACTTTAAGC CATTACATAA ATTAAATATT
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012061917.1
    CDS1..3243
    Translation

    Target ORF information:

    RefSeq Version XM_012206527.1
    Organism Atta cephalotes
    Definition Atta cephalotes uncharacterized LOC105625187 (LOC105625187), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012206527.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    ATGTCAGCGG TATATCCGAA GCTAGCAGTG AGAGACAATC TCGACGATGA TGATCTCACC 
    GACATCGATG ATGAAGTATT TATTAGGGAT GGGAGAAACG GTGGATTGAA ATTAGACGAC
    GATGGTGGAG TGAAACAGCC TCTCATGGCA CCTCGTAGAA AATGCAAAAA GCCCTGCAAC
    TTGGAGAATC ATAAGATCCC ATATAACATG CTTCTTGTGC CAGTGTGCTG TGGAACTACA
    GCATTGATTG TGCTATTAGG CTTAATTGTA GTTTGTATAT TTACTGCAAA TATATTCCCA
    ATGCCATTAA CTATACTGAA AAGCTGGATG TCACATGATT TAAAAAATCC TATAAATGAA
    TCTGAGATAA TTCCATGTAC CTCACTCTCG TCCAGTGTTT TATGGGCCAG ATCATTTCCA
    AAGTTAACAC CTGAGGCACC TCTTAGGAGT AATGATGTTA ACTCTGATGG AATTGAAGAC
    ATTATTGTAG GATTTAGTAC AGGTCTGGAT ATGATGGATA CAGAATATAT CTGTACTATA
    TATTTTGGGA ATCAAACGCC GTGTCTAGGC GGTGTACTAG CACTGAATGG TAAAACAGGT
    GAACCTATCT GGACACATTG GACTGCTCAT TCCATACTTT CTGTTGATTG CGATGCAGAT
    TTGACGAATG ATAAAGTTAA GGATTGTATC ATATCTGGAC GTGGTGGAAT ACTGCAAGCT
    ATTGATGGCC ATGATGGTTC CAATATATGG AAAATACCAC TTCAAGATCT AATTTCTGAG
    TTACAAATAA TTTCGGATGT CTATGATGCA AGATTTATAG CTGATATGGA TGGCGACGGT
    ATTGCCGATG TAATAGCATC GCATGTTGTA CAATCAGATA ATATTCAAGC AAGTAATGTA
    CTTGTAATAT CGGGTAAAAG TGGCAGTGTC ATACGCAATA TGAATTTACC AGATACTGAG
    CAATTGTTCG TAGCACCGCA AATTATAGTG CATCCTGATG GAGAAAATAT ATTCGTTCTA
    GCTACAACCA GTCAACAAGA TTCTGGAGGA TTATATATAG TGTCTCAAGC TAATATATTT
    TACGGTGATT TGCAATTGCA AAAACTCAAT CATAACACTG GCAAAAATGC GCTGTTGCCA
    CCGATTTTAA TCGATATTAC ATCTGATGGA ATTGAAGACA TTGTCGCTGC TATGTTCAAT
    TCTACGATTA TAGCATACAA TGGAACTACG TTTGAGCCTA TCTGGAATTA CACAGTTCCC
    AATTCCGAAG TAATTAGCAT TCCCATTCCC GGTTATTATA ATGACGACGA TATACCAGAC
    TTTATGGTGA AGCATCAGAT AGGAACTGGC TTATCCACAT ACTATTACAC TGTAGCTACA
    GTTATAGATG GTCGTAATGG GCAACCTTTG CTCGAGAAAC CAATGGAGGA TAGTTTAAGT
    GGGCAAATGT CTGGATTATC GGTCACTGTC GATGGGTTTG GCAATGATTG GTTTTTACAT
    TGGTCTACCG ACTGTTTAAA TTATGAAGGA ATCAAGGAAA AATATCAGTT CTTAAAAGGT
    CAGAGTTTCA TGTCGCAAAC TCGCACTGAT CTCTGCTCTC TAAGATTCAA TTCGACGCTT
    ACTATGAGAT TACTAGCTTT GAGTCAACAT GTCGGCCCGC CTGGATTGTC GTTATACTTC
    TCGGAGGACT GGAAGTCGGT AGAGTTCAAT AATTCAGTCG ATCTACGAAA AGAAGAGGAA
    AAGAATCTGA AATCCCATTC GCGATTAAAG GTCACGGATA CTTATTCAAA CATACCACTC
    GTTTCCGAGA GATCGCCAAA AATTCATAAA AATCATCGGA AAGATAGCAT TTTCAAACAC
    AAAGATAGTC TACTCGAAAT TGGCAAATAT GATTCGGACG CGATATATGA GAACTTCGAC
    GAATTCAAGA GCCATAAGAA ACATAATCCC GAAGACATTG TAGAGAATTT GAACGTAGAT
    CAAGCATGGA AACAAGATAA CAAATGGATG GAGGATGATG TGCAGCCGGA TAAAGAGTAT
    GATAGTATAT ACGAAAATGA TAACGGTAAC AATGAAGACA GACAGAGTGT AGATTATTCG
    CAAGGTGAAG TGCGAGAACA GAGAAGTGTC ATTCCCGTGG TTAAAAATAT ATATTCGATA
    AATATTTCTC ATAAAGAAAT TAATTCAACA CCTGAATCGA CGCGACATAG TTTACGACTG
    AATGAAGAAA TTAACACAGA AAAAAAGAGA AAAATGGAAG AAATCAATAA AAAAAATAGC
    TCAATGAACG AAGCTGATGA TATAATGAAT ATATCAATGA CATCAACTTC CCAATTTTCA
    GAGTTATCAT TAATTATGTC AAATAAATCA AATATCGAAA AGAGTACTAC AATACAGAAT
    GTATTAAAGA CGAGCGAATT AATAGAAATA AAGAGCATAA ATATAAGTAC AGAATTGCCT
    GAGGACACAC ATACTGAAGC ATCAAATGTT ACTAAAAATC AAATAATCAC TGGTCCAGAT
    GCAACTTCCA CTATTAAGAA AGTCGTAGAC ATACCTCAGC GAAGACACAT TTATAAACAT
    AGTTTCCCTA GTATTGTCCA AGACGCGGAT GATGATGCTA GTATAGAAAA AGTATTTAAA
    CGGGAATCAC TGAAAAATCA AAGTAAAGGC AAGATTAATA AGAAGCAATT ACTAATATTA
    TCGTCAACTG ATAAAGTTGT TAAAACACGA CAGAAACGAA GAACGAAACG AAACTCGGAA
    ATTAACAACA ACCAGTCGAA CGGTATCAAT GGTATTCAAA AGCAGGCACC AACCGGTATT
    CTGCTACCGT CTATTATCGA ATCCAAAGAA AAGACATCGA TAGATTTAGT GTTTCCTACG
    TTCTGGTTAC CGTCGTCTGA AGTGTCTCTG ATCTTGTCTC GAGCAGATGT GGAGTGCATT
    GACAAGAAGA AAGCATTATT AGAGGATAAA CTAGAGTACA AAAAAGATGA CGACATTATC
    AGCGAATGTT TATCCGAGCG AGGCATTAAT TACAGATTAT ATCAAGAGGC AATGGATAGA
    GAAAATACCA AAATCGCATT TGGTCAAATG ACAATATACA GGATGAAACT AGAATGCGTA
    TGTCCAGAGG ATATGCTACC TAATCAAACA TGCAAAAATA TTTCAATACA TCAAAGCTGG
    CCAGAATATT TAGGATCTTC TGGAAATGGC TACTTTAAGC CATTACATAA ATTAAATATT
    TGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.