LOC105621875 cDNA ORF clone, Atta cephalotes

The following LOC105621875 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC105621875 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OAt117303 XM_012203314.1
Latest version!
Atta cephalotes kinesin heavy chain (LOC105621875), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OAt117303
    Clone ID Related Accession (Same CDS sequence) XM_012203314.1
    Accession Version XM_012203314.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2976bp)
    Protein sequence
    SNP
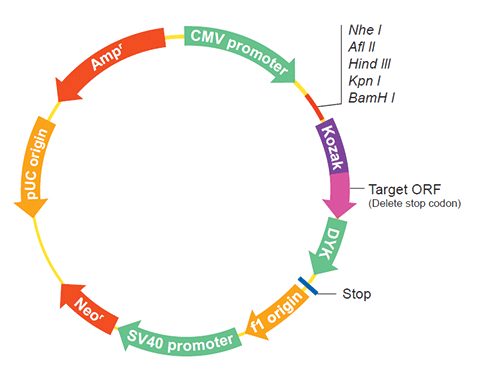
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-04-01
    Organism Atta cephalotes
    Product kinesin heavy chain
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_012130102.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Atta cephalotes Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGGCAATGG AGACGCCGAG GGAACGAGAG ATCGCCGCCG AGGACAGCAT CAAGGTGGTC 
    TGCAGGTTCC GGCCGCTCAA CGATTCCGAG GAGAAGGCCG GCTCCAAGTT CATCGTCAAG
    TTCCCGTCCG GCGGTGACGA GAACTGCATC TCCATCGGGG GCAAAGTATA CCTCTTTGAC
    AAAGTATTTA AACCGAATGC TACACAAGAC AAAGTCTACA ATGAAGCCGC AAAGTCTATC
    GTCACGGATG TTTTGGCAGG ATATAACGGA ACCATTTTTG CATATGGTCA AACATCGTCA
    GGTAAAACGC ACACAATGGA AGGAGTCATC GGCGATCCTA ACAAACAGGG CATTATCCCA
    AGAATCGTCA ATGACATCTT TAATCATATT TATGGTATGG AAGAGAACCT GGAATTCCAT
    ATCAAAGTAT CTTATTTTGA GATTTACATG GATAAAATCA GGGATCTTCT TGATGTATCT
    AAAGTTAACT TAAGCGTACA TGAAGACAAG AACCGGGTGC CGTTCGTGAA GGGCGCGACC
    GAGCGGTTTG TTTCTAGTCC TGAGGAGGTG TTCGAGGTGA TAGAGGAGGG CAAGTCAAAC
    CGGCACATCG CCGTGACCAA CATGAACGAG CACAGCTCAC GTTCTCATTC CGTTTTTCTC
    ATAAACGTTA AACAAGAGAA TTTGGAGAAT CAAAAAAAGC TCTCCGGCAA ATTGTATCTC
    GTTGATTTAG CCGGTTCTGA AAAGGTTTCT AAAACCGGTG CAGAAGGAAC GGTGTTAGAC
    GAAGCAAAAA ACATCAACAA GTCTCTGTCT GCACTTGGTA ATGTAATTTC GGCCTTGGCT
    GACGGCAATA AGACTCACAT TCCTTATCGT GACTCAAAGC TAACGAGAAT CCTGCAAGAA
    TCCTTGGGTG GCAATGCCAG AACTACAATT ATCATCTGTT GCTCTCCTGC TAGCTTTAAT
    GAATCCGAAA CAAAATCAAC TTTAGATTTC GGTAAACGCG CCAAGACTAT CAAGAATGTC
    GTGTGCGTGA ACGAAGAGCT AACAGCCGAA GAATGGAAAC GTCGCTACGA ACGCGAGAAA
    GAGAAAGTGG CAAGATGGAA GGGCAAAGTG GACAAATTGG AGGCGGAATT GTCGCGTTGG
    CGGCAGGGTG AGACTGTCAA ACCGGAAGAG CAGGTCAGTT TGATTGAAGG ACCTGATGTT
    ACTACACCGA TTACCGCATC CATTGAAGGC AAGCTGGACG ACAGTCCGAT GCCTGCTACT
    CCCGGCGGTG GTCTCATGAT CGGTTCCCTT TCGAACGAAG AGAGGCAGAA GCTCGAGGAG
    GAACGCGAGA GGCTGTACCA ACAATTGGAT GACAAGGATG AGGAAATTAA TCAGCAATCG
    CAGTACGTTG AAAAGCTGAA GGAGCAGATG GAGGAACAGG AGGAACTTAT CGCCAGTGCA
    AGGCGAGATT ATGAGCAATT GCAGCAAGAG ATGAATCGAA TACAACAAGA GAACGAGAGT
    GCTAAAGAGG AGGTGAAAGA GGTGTTGCAA GCGCTGGAAG AGCTTGCGGT CAATTATGAC
    CAAAAATCAC AAGAGGTCGA GCTGAAGAAC AAGGAGCAGG AATCAATGAC AGAGGAGCTC
    CTGGCTAAAC AAGTAACTCT AAACAACACT GCATCTGAGT TGCAACAGTT ACGTGATATG
    TCAGCTCATC AAAGAAAACG CATCGCGGAG ATGTTAGCAA ACTTCTTGAA AGACCTAGGA
    GAAATTGGCG TAGCTATCGG TGGCGAGTCT AACGAAAATC TAAAAATCGC TCCGCCGGAG
    AGCAATGGTA AACTGGAGGA GGAGTTCACA GTGGCGCGGT TATTTATCAG CAAGATGAAA
    TCCGAAGTGA AGAATTTAGT GCAACGATGT CAGGGATTGG AAAGCTTCCA AGTAGACTGC
    AATAAGAAAG TTTCCGAGTA CGAGAAAGAC TTGGCCGAAT GCCGATTGTT GATCTCGCAA
    CACGAAGCTC GTATGCAAAC GCTGACGGAA TCTATGAAAG AGGCTGAAAC GCGCAAACGA
    GCCTTAGAAG AAGATGTAGA TGCGTTACGC GAAGAATGCG CCAAGTTGAA GGCCGCTGAA
    CAGGTGCAGG CAGTTACCAA CAAGGAGAAA GCCGAGGAGA AAGAGGCGGC GACGAAGATG
    CGGGTGGCTT TAGAGGAGCA GATGGATCAG CTGAGGGATG CGCATCAAAA ACAGGTTGCT
    GCGCTGAGGG ACGAACTGTC TGAGAAGCAG GAACTGATCA GCGAACTTAA AGACCTTAAT
    CAGAAATTTA CTCTGGCACA TCAGCAGATG CAGGCCGATT ATGAACGATT GAAGCAAGAG
    GAGGCTAACA AATCAGTCAA GCTGCAGGAG CTTATGTTGT TGAACGAGCG CCGAGAACAA
    GCAAGGAAAG ATCTCAAAGG ATTGGAGGAC ACAGTAGCCA AAGAACTGCA GACTTTGCAC
    AATTTACGCA AATTGTTCGT TCAGGATCTG CAGGCTAGAA TAAAGAAGAC CATCAATGCA
    GAGGATAATG AGGATGACGG TGGTTCTCTT GCACAGAAAC AGAAAATATC CTTCTTGGAA
    AACAATCTGG ACCAGTTGAC AAAGGTGCAT AAACAACTCG TCAGAGATAA CGCAGATCTC
    CGCTGCGAGT TGCCTAAACT GGAGAAACGA TTACGGGCGA CAATGGAGCG CGTCAAGGCC
    CTAGAGACGG CGCTTCGCGA CGCTAAGGAA GGTGCGATGC GAGACCGTAA GCGCTATCAA
    TACGAAGTGG ACCGAATCAA GGAGGCAGTC AGGCAAAAGA ATCTGGCGCG TCGTGGACCG
    AGCGCGCAGA TAGCGAAGCC GATTCGGGCC GGTCAGCATC ATTTGAGTAA CGTCAACATC
    ATCAGAACCG GCAATCGTGA AAACGAATGC AAGAACGCTT TCATCGACAA AAACAAAAGA
    ATTCCAGCGG TTCTTATGTA TAACGGATAT GCATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_012058704.1
    CDS1..2976
    Translation

    Target ORF information:

    RefSeq Version XM_012203314.1
    Organism Atta cephalotes
    Definition Atta cephalotes kinesin heavy chain (LOC105621875), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_012203314.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGGCAATGG AGACGCCGAG GGAACGAGAG ATCGCCGCCG AGGACAGCAT CAAGGTGGTC 
    TGCAGGTTCC GGCCGCTCAA CGATTCCGAG GAGAAGGCCG GCTCCAAGTT CATCGTCAAG
    TTCCCGTCCG GCGGTGACGA GAACTGCATC TCCATCGGGG GCAAAGTATA CCTCTTTGAC
    AAAGTATTTA AACCGAATGC TACACAAGAC AAAGTCTACA ATGAAGCCGC AAAGTCTATC
    GTCACGGATG TTTTGGCAGG ATATAACGGA ACCATTTTTG CATATGGTCA AACATCGTCA
    GGTAAAACGC ACACAATGGA AGGAGTCATC GGCGATCCTA ACAAACAGGG CATTATCCCA
    AGAATCGTCA ATGACATCTT TAATCATATT TATGGTATGG AAGAGAACCT GGAATTCCAT
    ATCAAAGTAT CTTATTTTGA GATTTACATG GATAAAATCA GGGATCTTCT TGATGTATCT
    AAAGTTAACT TAAGCGTACA TGAAGACAAG AACCGGGTGC CGTTCGTGAA GGGCGCGACC
    GAGCGGTTTG TTTCTAGTCC TGAGGAGGTG TTCGAGGTGA TAGAGGAGGG CAAGTCAAAC
    CGGCACATCG CCGTGACCAA CATGAACGAG CACAGCTCAC GTTCTCATTC CGTTTTTCTC
    ATAAACGTTA AACAAGAGAA TTTGGAGAAT CAAAAAAAGC TCTCCGGCAA ATTGTATCTC
    GTTGATTTAG CCGGTTCTGA AAAGGTTTCT AAAACCGGTG CAGAAGGAAC GGTGTTAGAC
    GAAGCAAAAA ACATCAACAA GTCTCTGTCT GCACTTGGTA ATGTAATTTC GGCCTTGGCT
    GACGGCAATA AGACTCACAT TCCTTATCGT GACTCAAAGC TAACGAGAAT CCTGCAAGAA
    TCCTTGGGTG GCAATGCCAG AACTACAATT ATCATCTGTT GCTCTCCTGC TAGCTTTAAT
    GAATCCGAAA CAAAATCAAC TTTAGATTTC GGTAAACGCG CCAAGACTAT CAAGAATGTC
    GTGTGCGTGA ACGAAGAGCT AACAGCCGAA GAATGGAAAC GTCGCTACGA ACGCGAGAAA
    GAGAAAGTGG CAAGATGGAA GGGCAAAGTG GACAAATTGG AGGCGGAATT GTCGCGTTGG
    CGGCAGGGTG AGACTGTCAA ACCGGAAGAG CAGGTCAGTT TGATTGAAGG ACCTGATGTT
    ACTACACCGA TTACCGCATC CATTGAAGGC AAGCTGGACG ACAGTCCGAT GCCTGCTACT
    CCCGGCGGTG GTCTCATGAT CGGTTCCCTT TCGAACGAAG AGAGGCAGAA GCTCGAGGAG
    GAACGCGAGA GGCTGTACCA ACAATTGGAT GACAAGGATG AGGAAATTAA TCAGCAATCG
    CAGTACGTTG AAAAGCTGAA GGAGCAGATG GAGGAACAGG AGGAACTTAT CGCCAGTGCA
    AGGCGAGATT ATGAGCAATT GCAGCAAGAG ATGAATCGAA TACAACAAGA GAACGAGAGT
    GCTAAAGAGG AGGTGAAAGA GGTGTTGCAA GCGCTGGAAG AGCTTGCGGT CAATTATGAC
    CAAAAATCAC AAGAGGTCGA GCTGAAGAAC AAGGAGCAGG AATCAATGAC AGAGGAGCTC
    CTGGCTAAAC AAGTAACTCT AAACAACACT GCATCTGAGT TGCAACAGTT ACGTGATATG
    TCAGCTCATC AAAGAAAACG CATCGCGGAG ATGTTAGCAA ACTTCTTGAA AGACCTAGGA
    GAAATTGGCG TAGCTATCGG TGGCGAGTCT AACGAAAATC TAAAAATCGC TCCGCCGGAG
    AGCAATGGTA AACTGGAGGA GGAGTTCACA GTGGCGCGGT TATTTATCAG CAAGATGAAA
    TCCGAAGTGA AGAATTTAGT GCAACGATGT CAGGGATTGG AAAGCTTCCA AGTAGACTGC
    AATAAGAAAG TTTCCGAGTA CGAGAAAGAC TTGGCCGAAT GCCGATTGTT GATCTCGCAA
    CACGAAGCTC GTATGCAAAC GCTGACGGAA TCTATGAAAG AGGCTGAAAC GCGCAAACGA
    GCCTTAGAAG AAGATGTAGA TGCGTTACGC GAAGAATGCG CCAAGTTGAA GGCCGCTGAA
    CAGGTGCAGG CAGTTACCAA CAAGGAGAAA GCCGAGGAGA AAGAGGCGGC GACGAAGATG
    CGGGTGGCTT TAGAGGAGCA GATGGATCAG CTGAGGGATG CGCATCAAAA ACAGGTTGCT
    GCGCTGAGGG ACGAACTGTC TGAGAAGCAG GAACTGATCA GCGAACTTAA AGACCTTAAT
    CAGAAATTTA CTCTGGCACA TCAGCAGATG CAGGCCGATT ATGAACGATT GAAGCAAGAG
    GAGGCTAACA AATCAGTCAA GCTGCAGGAG CTTATGTTGT TGAACGAGCG CCGAGAACAA
    GCAAGGAAAG ATCTCAAAGG ATTGGAGGAC ACAGTAGCCA AAGAACTGCA GACTTTGCAC
    AATTTACGCA AATTGTTCGT TCAGGATCTG CAGGCTAGAA TAAAGAAGAC CATCAATGCA
    GAGGATAATG AGGATGACGG TGGTTCTCTT GCACAGAAAC AGAAAATATC CTTCTTGGAA
    AACAATCTGG ACCAGTTGAC AAAGGTGCAT AAACAACTCG TCAGAGATAA CGCAGATCTC
    CGCTGCGAGT TGCCTAAACT GGAGAAACGA TTACGGGCGA CAATGGAGCG CGTCAAGGCC
    CTAGAGACGG CGCTTCGCGA CGCTAAGGAA GGTGCGATGC GAGACCGTAA GCGCTATCAA
    TACGAAGTGG ACCGAATCAA GGAGGCAGTC AGGCAAAAGA ATCTGGCGCG TCGTGGACCG
    AGCGCGCAGA TAGCGAAGCC GATTCGGGCC GGTCAGCATC ATTTGAGTAA CGTCAACATC
    ATCAGAACCG GCAATCGTGA AAACGAATGC AAGAACGCTT TCATCGACAA AAACAAAAGA
    ATTCCAGCGG TTCTTATGTA TAACGGATAT GCATAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.