SPARCL1 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

The following SPARCL1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the SPARCL1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa48946 XM_003811263.2
Latest version!
Pan paniscus SPARC like 1 (SPARCL1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPa48946 XM_003811264.2
Latest version!
Pan paniscus SPARC like 1 (SPARCL1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa48946
    Clone ID Related Accession (Same CDS sequence) XM_003811263.2 , XM_003811264.2
    Accession Version XM_003811263.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1995bp)
    Protein sequence
    SNP
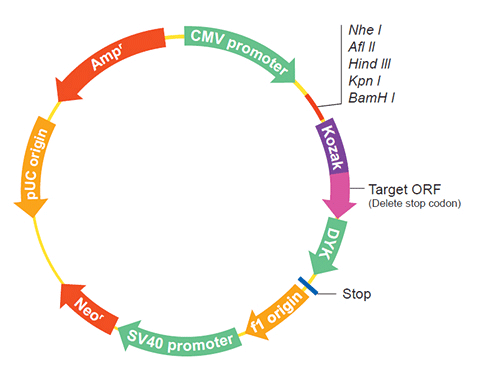
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product SPARC-like protein 1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027872.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 2, 2014 this sequence version replaced XM_003811263.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAAGACTG GGCTTTTTTT CCTATGTCTC TTGGGAACTG CAGCTGCAAT CCCGACAAAT 
    GCAAGATTAT TATCTGATCA TTCAAAACCA ACTGCTGAAA CGGTAGCACC CGACAACACT
    GCAATCCCCA GTTTAAGGGC TGAAGATGAA GAAAATGAAA AAGAAACAGC AGTATCCACA
    GAAGACGATT CCCAACGTAA GGCTGAAAAA TCATCAGTAC TAAAGTCAAA AGAGGAAAGC
    CATGAACAGT CAGCAGAACA GGGCAAGAGT TCTAGCCAAG AGCTGGGATT GAAGGATCAA
    GAGGACAGTG ATGGTGACTT AAGTGTGAAT TTGGAGTATG CACCAACTGA AGGTACATTG
    GACATAAAAG AAGATATGAG TGAGCCTCAG GAGAAAAAAC TCTCAGAGAA CACTGATTTT
    TTGGCTCCTG GTGTTAGTTC CTTCACAGAT TCTAACCAAC AAGAAAGTAT CACAAAGAGA
    GAGGAAAACC AAGAACAACC TAGAAATTAT TCACATCATC AGTTGAACAG GAGCAGTAAA
    CATAGCCAAG GCCTAAGGGA TCAAGGAAAC CAAGAGCAGG ATCCAAATAT TTCCAATGGA
    GAAGAGGAAG AAGAAAAAGG GCCAGGTGAA GTTGGTACCC ACAATGATAA CCAAGAAAGA
    AAGACAGAAT TGCCCAGGGA GCATGCTAAC AGCAAGCAGG AGGAAGACAA TACCCAATCT
    GATGATATTT TGGAAGAGTC TGATCAACCA ACTCAAGTAA GCAAGATGCA GGAGGATGAA
    TTTGATCAGG GTAACCAAGA ACAAGAAGAT AACTCCAATG CAGAAATGGA AGAGGAAAAT
    GCATCGAACG TCAATAAGCA CATTCAAGAA ACTGAATGGC AGAGTCAAGA GGGTAAAACT
    GGCCTGGAAG CTATCAGCAA CCACAAAGAG ACAGATGAAA AGACTGTTTC TGAGGCTCTG
    CTCATGGAAC CTACTGATGA TGGTAATACC ACGCCCAGAA ATCATGGAGT TGATGATGAT
    GGCAATGATG ATGGCGATGA TGGCGGCACT GATGGCCCCA GGCACAGTGC AAGTGATGAC
    TACTTCATCC CAAGCCAGGC CTTTCTGGAG GCCGAGAGAG CTCAATCCAT TGCCTATCAC
    CTCAAAATTG AGGAGCAAAG AGAAAAAGTA CATGAAAATG AAAATATAGG TACCAGTGAG
    CCTGGAGAGC ACCAAGAGGC CAAGAAAGCA GAGAACTCAT CAAATGAGGA GGAAACGTCA
    AGTGAAGGCA ACATGAGGGT GCATGGTGTG GATTCTTGCA TGAGCTTCCA GTGTAAAAGA
    GGCCACATCT GTAAGGCAGA CCAACAGGGA AAACCTCACT GTGTCTGCCA GGATCCAGTG
    ACTTGTCCTC CAACAAAACC CCTTGATCAA GTTTGTGGCA CTGACAATCA GACCTATGCT
    AGCTCCTGTC ATCTATTCGC TACTAAATGC AGACTGGAGG GGACCAAAAA GGGGCATCAA
    CTCCAGCTGG ATTATTTTGG AGCCTGCAAA TCTATTCCTA CTTGTACGGA CTTTGAAGTG
    ATTCAGTTTC CTCTACGGAT GAGAGACTGG CTCAAGAATA TCCTCATGCA GCTTTATGAA
    GCCAACTCTG AACACGCTGG TTATCTAAAT GAGAAGCAGA GAAATAAAGT CAAGAAAATT
    TACCTGGATG AAAAGAGGCT CTTGGCTGGG GACCATCCCA TTGACCTTCT CTTAAGGGAC
    TTTAAGAAAA ACTACCACAT GTATGTGTAT CCTGTGCACT GGCAGTTTAG TGAACTTGAC
    CAACACCCTA TGGATAGAGT CTTGACACAT TCTGAACTTG CTCCTCTGCG AGCATCTCTG
    GTGCCCATGG AACACTGCAT AACCCGTTTC TTTGAGGAGT GTGACCCCAA CAAGGATAAG
    CACATCACCC TGAAGGAGTG GGGCCACTGC TTTGGAATTA AAGAAGAGGA CATAGATGAA
    AATCTCTTGT TTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003811311.1
    CDS591..2585
    Translation

    Target ORF information:

    RefSeq Version XM_003811263.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SPARC like 1 (SPARCL1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003811263.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAAGACTG GGCTTTTTTT CCTATGTCTC TTGGGAACTG CAGCTGCAAT CCCGACAAAT 
    GCAAGATTAT TATCTGATCA TTCAAAACCA ACTGCTGAAA CGGTAGCACC CGACAACACT
    GCAATCCCCA GTTTAAGGGC TGAAGATGAA GAAAATGAAA AAGAAACAGC AGTATCCACA
    GAAGACGATT CCCAACGTAA GGCTGAAAAA TCATCAGTAC TAAAGTCAAA AGAGGAAAGC
    CATGAACAGT CAGCAGAACA GGGCAAGAGT TCTAGCCAAG AGCTGGGATT GAAGGATCAA
    GAGGACAGTG ATGGTGACTT AAGTGTGAAT TTGGAGTATG CACCAACTGA AGGTACATTG
    GACATAAAAG AAGATATGAG TGAGCCTCAG GAGAAAAAAC TCTCAGAGAA CACTGATTTT
    TTGGCTCCTG GTGTTAGTTC CTTCACAGAT TCTAACCAAC AAGAAAGTAT CACAAAGAGA
    GAGGAAAACC AAGAACAACC TAGAAATTAT TCACATCATC AGTTGAACAG GAGCAGTAAA
    CATAGCCAAG GCCTAAGGGA TCAAGGAAAC CAAGAGCAGG ATCCAAATAT TTCCAATGGA
    GAAGAGGAAG AAGAAAAAGG GCCAGGTGAA GTTGGTACCC ACAATGATAA CCAAGAAAGA
    AAGACAGAAT TGCCCAGGGA GCATGCTAAC AGCAAGCAGG AGGAAGACAA TACCCAATCT
    GATGATATTT TGGAAGAGTC TGATCAACCA ACTCAAGTAA GCAAGATGCA GGAGGATGAA
    TTTGATCAGG GTAACCAAGA ACAAGAAGAT AACTCCAATG CAGAAATGGA AGAGGAAAAT
    GCATCGAACG TCAATAAGCA CATTCAAGAA ACTGAATGGC AGAGTCAAGA GGGTAAAACT
    GGCCTGGAAG CTATCAGCAA CCACAAAGAG ACAGATGAAA AGACTGTTTC TGAGGCTCTG
    CTCATGGAAC CTACTGATGA TGGTAATACC ACGCCCAGAA ATCATGGAGT TGATGATGAT
    GGCAATGATG ATGGCGATGA TGGCGGCACT GATGGCCCCA GGCACAGTGC AAGTGATGAC
    TACTTCATCC CAAGCCAGGC CTTTCTGGAG GCCGAGAGAG CTCAATCCAT TGCCTATCAC
    CTCAAAATTG AGGAGCAAAG AGAAAAAGTA CATGAAAATG AAAATATAGG TACCAGTGAG
    CCTGGAGAGC ACCAAGAGGC CAAGAAAGCA GAGAACTCAT CAAATGAGGA GGAAACGTCA
    AGTGAAGGCA ACATGAGGGT GCATGGTGTG GATTCTTGCA TGAGCTTCCA GTGTAAAAGA
    GGCCACATCT GTAAGGCAGA CCAACAGGGA AAACCTCACT GTGTCTGCCA GGATCCAGTG
    ACTTGTCCTC CAACAAAACC CCTTGATCAA GTTTGTGGCA CTGACAATCA GACCTATGCT
    AGCTCCTGTC ATCTATTCGC TACTAAATGC AGACTGGAGG GGACCAAAAA GGGGCATCAA
    CTCCAGCTGG ATTATTTTGG AGCCTGCAAA TCTATTCCTA CTTGTACGGA CTTTGAAGTG
    ATTCAGTTTC CTCTACGGAT GAGAGACTGG CTCAAGAATA TCCTCATGCA GCTTTATGAA
    GCCAACTCTG AACACGCTGG TTATCTAAAT GAGAAGCAGA GAAATAAAGT CAAGAAAATT
    TACCTGGATG AAAAGAGGCT CTTGGCTGGG GACCATCCCA TTGACCTTCT CTTAAGGGAC
    TTTAAGAAAA ACTACCACAT GTATGTGTAT CCTGTGCACT GGCAGTTTAG TGAACTTGAC
    CAACACCCTA TGGATAGAGT CTTGACACAT TCTGAACTTG CTCCTCTGCG AGCATCTCTG
    GTGCCCATGG AACACTGCAT AACCCGTTTC TTTGAGGAGT GTGACCCCAA CAAGGATAAG
    CACATCACCC TGAAGGAGTG GGGCCACTGC TTTGGAATTA AAGAAGAGGA CATAGATGAA
    AATCTCTTGT TTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa48946
    Clone ID Related Accession (Same CDS sequence) XM_003811263.2 , XM_003811264.2
    Accession Version XM_003811264.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1995bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product SPARC-like protein 1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027872.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 2, 2014 this sequence version replaced XM_003811264.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAAGACTG GGCTTTTTTT CCTATGTCTC TTGGGAACTG CAGCTGCAAT CCCGACAAAT 
    GCAAGATTAT TATCTGATCA TTCAAAACCA ACTGCTGAAA CGGTAGCACC CGACAACACT
    GCAATCCCCA GTTTAAGGGC TGAAGATGAA GAAAATGAAA AAGAAACAGC AGTATCCACA
    GAAGACGATT CCCAACGTAA GGCTGAAAAA TCATCAGTAC TAAAGTCAAA AGAGGAAAGC
    CATGAACAGT CAGCAGAACA GGGCAAGAGT TCTAGCCAAG AGCTGGGATT GAAGGATCAA
    GAGGACAGTG ATGGTGACTT AAGTGTGAAT TTGGAGTATG CACCAACTGA AGGTACATTG
    GACATAAAAG AAGATATGAG TGAGCCTCAG GAGAAAAAAC TCTCAGAGAA CACTGATTTT
    TTGGCTCCTG GTGTTAGTTC CTTCACAGAT TCTAACCAAC AAGAAAGTAT CACAAAGAGA
    GAGGAAAACC AAGAACAACC TAGAAATTAT TCACATCATC AGTTGAACAG GAGCAGTAAA
    CATAGCCAAG GCCTAAGGGA TCAAGGAAAC CAAGAGCAGG ATCCAAATAT TTCCAATGGA
    GAAGAGGAAG AAGAAAAAGG GCCAGGTGAA GTTGGTACCC ACAATGATAA CCAAGAAAGA
    AAGACAGAAT TGCCCAGGGA GCATGCTAAC AGCAAGCAGG AGGAAGACAA TACCCAATCT
    GATGATATTT TGGAAGAGTC TGATCAACCA ACTCAAGTAA GCAAGATGCA GGAGGATGAA
    TTTGATCAGG GTAACCAAGA ACAAGAAGAT AACTCCAATG CAGAAATGGA AGAGGAAAAT
    GCATCGAACG TCAATAAGCA CATTCAAGAA ACTGAATGGC AGAGTCAAGA GGGTAAAACT
    GGCCTGGAAG CTATCAGCAA CCACAAAGAG ACAGATGAAA AGACTGTTTC TGAGGCTCTG
    CTCATGGAAC CTACTGATGA TGGTAATACC ACGCCCAGAA ATCATGGAGT TGATGATGAT
    GGCAATGATG ATGGCGATGA TGGCGGCACT GATGGCCCCA GGCACAGTGC AAGTGATGAC
    TACTTCATCC CAAGCCAGGC CTTTCTGGAG GCCGAGAGAG CTCAATCCAT TGCCTATCAC
    CTCAAAATTG AGGAGCAAAG AGAAAAAGTA CATGAAAATG AAAATATAGG TACCAGTGAG
    CCTGGAGAGC ACCAAGAGGC CAAGAAAGCA GAGAACTCAT CAAATGAGGA GGAAACGTCA
    AGTGAAGGCA ACATGAGGGT GCATGGTGTG GATTCTTGCA TGAGCTTCCA GTGTAAAAGA
    GGCCACATCT GTAAGGCAGA CCAACAGGGA AAACCTCACT GTGTCTGCCA GGATCCAGTG
    ACTTGTCCTC CAACAAAACC CCTTGATCAA GTTTGTGGCA CTGACAATCA GACCTATGCT
    AGCTCCTGTC ATCTATTCGC TACTAAATGC AGACTGGAGG GGACCAAAAA GGGGCATCAA
    CTCCAGCTGG ATTATTTTGG AGCCTGCAAA TCTATTCCTA CTTGTACGGA CTTTGAAGTG
    ATTCAGTTTC CTCTACGGAT GAGAGACTGG CTCAAGAATA TCCTCATGCA GCTTTATGAA
    GCCAACTCTG AACACGCTGG TTATCTAAAT GAGAAGCAGA GAAATAAAGT CAAGAAAATT
    TACCTGGATG AAAAGAGGCT CTTGGCTGGG GACCATCCCA TTGACCTTCT CTTAAGGGAC
    TTTAAGAAAA ACTACCACAT GTATGTGTAT CCTGTGCACT GGCAGTTTAG TGAACTTGAC
    CAACACCCTA TGGATAGAGT CTTGACACAT TCTGAACTTG CTCCTCTGCG AGCATCTCTG
    GTGCCCATGG AACACTGCAT AACCCGTTTC TTTGAGGAGT GTGACCCCAA CAAGGATAAG
    CACATCACCC TGAAGGAGTG GGGCCACTGC TTTGGAATTA AAGAAGAGGA CATAGATGAA
    AATCTCTTGT TTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_003811312.1
    CDS680..2674
    Translation

    Target ORF information:

    RefSeq Version XM_003811264.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SPARC like 1 (SPARCL1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_003811264.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    ATGAAGACTG GGCTTTTTTT CCTATGTCTC TTGGGAACTG CAGCTGCAAT CCCGACAAAT 
    GCAAGATTAT TATCTGATCA TTCAAAACCA ACTGCTGAAA CGGTAGCACC CGACAACACT
    GCAATCCCCA GTTTAAGGGC TGAAGATGAA GAAAATGAAA AAGAAACAGC AGTATCCACA
    GAAGACGATT CCCAACGTAA GGCTGAAAAA TCATCAGTAC TAAAGTCAAA AGAGGAAAGC
    CATGAACAGT CAGCAGAACA GGGCAAGAGT TCTAGCCAAG AGCTGGGATT GAAGGATCAA
    GAGGACAGTG ATGGTGACTT AAGTGTGAAT TTGGAGTATG CACCAACTGA AGGTACATTG
    GACATAAAAG AAGATATGAG TGAGCCTCAG GAGAAAAAAC TCTCAGAGAA CACTGATTTT
    TTGGCTCCTG GTGTTAGTTC CTTCACAGAT TCTAACCAAC AAGAAAGTAT CACAAAGAGA
    GAGGAAAACC AAGAACAACC TAGAAATTAT TCACATCATC AGTTGAACAG GAGCAGTAAA
    CATAGCCAAG GCCTAAGGGA TCAAGGAAAC CAAGAGCAGG ATCCAAATAT TTCCAATGGA
    GAAGAGGAAG AAGAAAAAGG GCCAGGTGAA GTTGGTACCC ACAATGATAA CCAAGAAAGA
    AAGACAGAAT TGCCCAGGGA GCATGCTAAC AGCAAGCAGG AGGAAGACAA TACCCAATCT
    GATGATATTT TGGAAGAGTC TGATCAACCA ACTCAAGTAA GCAAGATGCA GGAGGATGAA
    TTTGATCAGG GTAACCAAGA ACAAGAAGAT AACTCCAATG CAGAAATGGA AGAGGAAAAT
    GCATCGAACG TCAATAAGCA CATTCAAGAA ACTGAATGGC AGAGTCAAGA GGGTAAAACT
    GGCCTGGAAG CTATCAGCAA CCACAAAGAG ACAGATGAAA AGACTGTTTC TGAGGCTCTG
    CTCATGGAAC CTACTGATGA TGGTAATACC ACGCCCAGAA ATCATGGAGT TGATGATGAT
    GGCAATGATG ATGGCGATGA TGGCGGCACT GATGGCCCCA GGCACAGTGC AAGTGATGAC
    TACTTCATCC CAAGCCAGGC CTTTCTGGAG GCCGAGAGAG CTCAATCCAT TGCCTATCAC
    CTCAAAATTG AGGAGCAAAG AGAAAAAGTA CATGAAAATG AAAATATAGG TACCAGTGAG
    CCTGGAGAGC ACCAAGAGGC CAAGAAAGCA GAGAACTCAT CAAATGAGGA GGAAACGTCA
    AGTGAAGGCA ACATGAGGGT GCATGGTGTG GATTCTTGCA TGAGCTTCCA GTGTAAAAGA
    GGCCACATCT GTAAGGCAGA CCAACAGGGA AAACCTCACT GTGTCTGCCA GGATCCAGTG
    ACTTGTCCTC CAACAAAACC CCTTGATCAA GTTTGTGGCA CTGACAATCA GACCTATGCT
    AGCTCCTGTC ATCTATTCGC TACTAAATGC AGACTGGAGG GGACCAAAAA GGGGCATCAA
    CTCCAGCTGG ATTATTTTGG AGCCTGCAAA TCTATTCCTA CTTGTACGGA CTTTGAAGTG
    ATTCAGTTTC CTCTACGGAT GAGAGACTGG CTCAAGAATA TCCTCATGCA GCTTTATGAA
    GCCAACTCTG AACACGCTGG TTATCTAAAT GAGAAGCAGA GAAATAAAGT CAAGAAAATT
    TACCTGGATG AAAAGAGGCT CTTGGCTGGG GACCATCCCA TTGACCTTCT CTTAAGGGAC
    TTTAAGAAAA ACTACCACAT GTATGTGTAT CCTGTGCACT GGCAGTTTAG TGAACTTGAC
    CAACACCCTA TGGATAGAGT CTTGACACAT TCTGAACTTG CTCCTCTGCG AGCATCTCTG
    GTGCCCATGG AACACTGCAT AACCCGTTTC TTTGAGGAGT GTGACCCCAA CAAGGATAAG
    CACATCACCC TGAAGGAGTG GGGCCACTGC TTTGGAATTA AAGAAGAGGA CATAGATGAA
    AATCTCTTGT TTTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.