RGMA cDNA ORF clone, Python bivittatus(Burmese python)

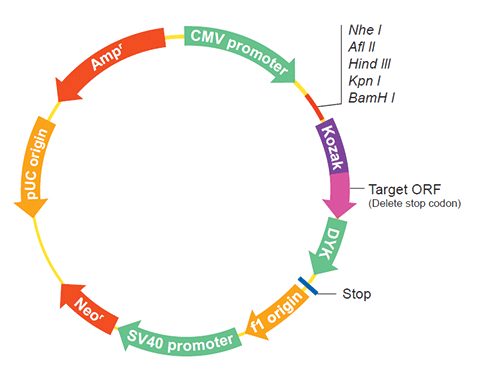
The following RGMA gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the RGMA cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPy02225 XM_007422336.2
Latest version!
Python bivittatus repulsive guidance molecule BMP co-receptor a (RGMA), mRNA. pcDNA3.1-C-(k)DYK or customized vector 9-11 $258.30
$369.00
OPy02226 XM_007422337.1
Latest version!
Python bivittatus repulsive guidance molecule family member a (RGMA), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 9-11 $258.30
$369.00
View Old Accession Versions >>
OPy02225 XM_007422336.1 Python bivittatus repulsive guidance molecule family member a (RGMA), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 9-11 $258.30
$369.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPy02225
    Clone ID Related Accession (Same CDS sequence) XM_007422336.1 , XM_007422336.2
    Accession Version XM_007422336.1 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1308bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-03-10
    Organism Python bivittatus(Burmese python)
    Product repulsive guidance molecule A isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_006532202.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Python bivittatus Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    ATGGTTATGG GGAAAGGGGC AAGCGCGAAA GCCCTCGGAC TGATCCCGTT CCTCCTCGCC 
    TGGCTCTGCA TCTTCCCCGC AGTGATGTCT CCATGCAAGA TCATGAAGTG CAACTCTGAA
    TTTTTGGCCG CCACATCGGG GACACAGCCC CCAGGCCCTG AGGAAGCTCC TGAGTTCTGT
    ACTGCCCTGC GGGCCTACGC TCTCTGCACC CACCACACGG CTCGCACCTG CCGGGGAGAC
    CTCTTCTACC ATTCTGCAGT CCATGGCATC GATGATCTCA TGACCCAACA CAACTGCTCC
    AAAGATGGGC CCACCTCCCA GCCCCGCCTC CCCCCGCTGC CCCGGGGTGA CAGCCAGGAG
    CGCTCTGACA GCCCGGAGAG CTGTCATTAT GAACGTAGCT TCCACAAACA TTCCTTGCGT
    CCCAACTACA CCCACTGCGG GCTGTTTGGA GACCCGCACC TGCGGACGTT TTCAGACAGC
    TTCCAGACAT GCAAAGTCCA GGGGGCCTGG CCGCTCATTG ACAACAACTA CCTGAATGTG
    CAGGTCACCA ACACCCCTGT CTTGCCTGGC TCCCTGGCAA CAGCCACCAC CAAGCTCACT
    ATCATTTTCA AGAGCTTCCA GGAGTGTGTG GATCAAAAGG TGTACCAGGC AGAGATGGAT
    GAACTCCCAG CAGCCTTTGC TGATGGCTCC AAGAATGGCG GTGACAAGCA TGGTGCTAAC
    AGCCTGAAGA TCACCGAGAA GGTGTCTGGC CAACACATTG AAATTCAGGC CAAATACATT
    GGCACCACCA TCGTGGTGAG GCAAGTCGGC CGCTACCTCA CCTTTGCCGT CCGGATGCCA
    GAGGAGGTCG TGAAAGCTGT GGAGGATGGA GACAACCAGG GCCTCTATCT CTGCCTCCGG
    GGTTGTCCAC TCAACCAGCA GATAGACTTC CATGCCTTCC ATTCCACCCC AAAGGCTACT
    GAAAACCGCC CCCACCGGAA AGGCTCAAAC CTACCTTCTT CACCAGAGGC ATTCACCTAC
    GAAACAGCCA CAGCCAAATG CAAAGAGAAA CTTCCAGTAG AGGACTTGTA CTTCCAGTCC
    TGTGTCTTTG ACCTCTTGAC TACAGGCGAC GTCAACTTTA CCCTTGCTGC TTATTATGCT
    TTTGAAGATG TCAAGATGCT CCACTCCAAC AAAGACAAGC TTCATCTGTT TGAAAGGACA
    CGACACTTGG AGTCAGGCAA TATGGCCAGC TTAGAGCCTT CCGTGGCTCT GTTTCTTTCA
    CTCTTGGCAT TCCTATGCTT GAATCAAAGT CCAGCCCTTT TCTTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_007422398.1
    CDS10..1317
    Translation

    Target ORF information:

    RefSeq Version XM_007422336.1
    Organism Python bivittatus(Burmese python)
    Definition Python bivittatus repulsive guidance molecule family member a (RGMA), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_007422336.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    ATGGTTATGG GGAAAGGGGC AAGCGCGAAA GCCCTCGGAC TGATCCCGTT CCTCCTCGCC 
    TGGCTCTGCA TCTTCCCCGC AGTGATGTCT CCATGCAAGA TCATGAAGTG CAACTCTGAA
    TTTTTGGCCG CCACATCGGG GACACAGCCC CCAGGCCCTG AGGAAGCTCC TGAGTTCTGT
    ACTGCCCTGC GGGCCTACGC TCTCTGCACC CACCACACGG CTCGCACCTG CCGGGGAGAC
    CTCTTCTACC ATTCTGCAGT CCATGGCATC GATGATCTCA TGACCCAACA CAACTGCTCC
    AAAGATGGGC CCACCTCCCA GCCCCGCCTC CCCCCGCTGC CCCGGGGTGA CAGCCAGGAG
    CGCTCTGACA GCCCGGAGAG CTGTCATTAT GAACGTAGCT TCCACAAACA TTCCTTGCGT
    CCCAACTACA CCCACTGCGG GCTGTTTGGA GACCCGCACC TGCGGACGTT TTCAGACAGC
    TTCCAGACAT GCAAAGTCCA GGGGGCCTGG CCGCTCATTG ACAACAACTA CCTGAATGTG
    CAGGTCACCA ACACCCCTGT CTTGCCTGGC TCCCTGGCAA CAGCCACCAC CAAGCTCACT
    ATCATTTTCA AGAGCTTCCA GGAGTGTGTG GATCAAAAGG TGTACCAGGC AGAGATGGAT
    GAACTCCCAG CAGCCTTTGC TGATGGCTCC AAGAATGGCG GTGACAAGCA TGGTGCTAAC
    AGCCTGAAGA TCACCGAGAA GGTGTCTGGC CAACACATTG AAATTCAGGC CAAATACATT
    GGCACCACCA TCGTGGTGAG GCAAGTCGGC CGCTACCTCA CCTTTGCCGT CCGGATGCCA
    GAGGAGGTCG TGAAAGCTGT GGAGGATGGA GACAACCAGG GCCTCTATCT CTGCCTCCGG
    GGTTGTCCAC TCAACCAGCA GATAGACTTC CATGCCTTCC ATTCCACCCC AAAGGCTACT
    GAAAACCGCC CCCACCGGAA AGGCTCAAAC CTACCTTCTT CACCAGAGGC ATTCACCTAC
    GAAACAGCCA CAGCCAAATG CAAAGAGAAA CTTCCAGTAG AGGACTTGTA CTTCCAGTCC
    TGTGTCTTTG ACCTCTTGAC TACAGGCGAC GTCAACTTTA CCCTTGCTGC TTATTATGCT
    TTTGAAGATG TCAAGATGCT CCACTCCAAC AAAGACAAGC TTCATCTGTT TGAAAGGACA
    CGACACTTGG AGTCAGGCAA TATGGCCAGC TTAGAGCCTT CCGTGGCTCT GTTTCTTTCA
    CTCTTGGCAT TCCTATGCTT GAATCAAAGT CCAGCCCTTT TCTTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPy02225
    Clone ID Related Accession (Same CDS sequence) XM_007422336.1 , XM_007422336.2
    Accession Version XM_007422336.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1308bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-05-23
    Organism Python bivittatus(Burmese python)
    Product repulsive guidance molecule A
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_006532202.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process On May 24, 2018 this sequence version replaced XM_007422336.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Python bivittatus Annotation Release 102 Annotation Version :: 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    ATGGTTATGG GGAAAGGGGC AAGCGCGAAA GCCCTCGGAC TGATCCCGTT CCTCCTCGCC 
    TGGCTCTGCA TCTTCCCCGC AGTGATGTCT CCATGCAAGA TCATGAAGTG CAACTCTGAA
    TTTTTGGCCG CCACATCGGG GACACAGCCC CCAGGCCCTG AGGAAGCTCC TGAGTTCTGT
    ACTGCCCTGC GGGCCTACGC TCTCTGCACC CACCACACGG CTCGCACCTG CCGGGGAGAC
    CTCTTCTACC ATTCTGCAGT CCATGGCATC GATGATCTCA TGACCCAACA CAACTGCTCC
    AAAGATGGGC CCACCTCCCA GCCCCGCCTC CCCCCGCTGC CCCGGGGTGA CAGCCAGGAG
    CGCTCTGACA GCCCGGAGAG CTGTCATTAT GAACGTAGCT TCCACAAACA TTCCTTGCGT
    CCCAACTACA CCCACTGCGG GCTGTTTGGA GACCCGCACC TGCGGACGTT TTCAGACAGC
    TTCCAGACAT GCAAAGTCCA GGGGGCCTGG CCGCTCATTG ACAACAACTA CCTGAATGTG
    CAGGTCACCA ACACCCCTGT CTTGCCTGGC TCCCTGGCAA CAGCCACCAC CAAGCTCACT
    ATCATTTTCA AGAGCTTCCA GGAGTGTGTG GATCAAAAGG TGTACCAGGC AGAGATGGAT
    GAACTCCCAG CAGCCTTTGC TGATGGCTCC AAGAATGGCG GTGACAAGCA TGGTGCTAAC
    AGCCTGAAGA TCACCGAGAA GGTGTCTGGC CAACACATTG AAATTCAGGC CAAATACATT
    GGCACCACCA TCGTGGTGAG GCAAGTCGGC CGCTACCTCA CCTTTGCCGT CCGGATGCCA
    GAGGAGGTCG TGAAAGCTGT GGAGGATGGA GACAACCAGG GCCTCTATCT CTGCCTCCGG
    GGTTGTCCAC TCAACCAGCA GATAGACTTC CATGCCTTCC ATTCCACCCC AAAGGCTACT
    GAAAACCGCC CCCACCGGAA AGGCTCAAAC CTACCTTCTT CACCAGAGGC ATTCACCTAC
    GAAACAGCCA CAGCCAAATG CAAAGAGAAA CTTCCAGTAG AGGACTTGTA CTTCCAGTCC
    TGTGTCTTTG ACCTCTTGAC TACAGGCGAC GTCAACTTTA CCCTTGCTGC TTATTATGCT
    TTTGAAGATG TCAAGATGCT CCACTCCAAC AAAGACAAGC TTCATCTGTT TGAAAGGACA
    CGACACTTGG AGTCAGGCAA TATGGCCAGC TTAGAGCCTT CCGTGGCTCT GTTTCTTTCA
    CTCTTGGCAT TCCTATGCTT GAATCAAAGT CCAGCCCTTT TCTTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_007422398.1
    CDS68..1375
    Translation

    Target ORF information:

    RefSeq Version XM_007422336.2
    Organism Python bivittatus(Burmese python)
    Definition Python bivittatus repulsive guidance molecule BMP co-receptor a (RGMA), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_007422336.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    ATGGTTATGG GGAAAGGGGC AAGCGCGAAA GCCCTCGGAC TGATCCCGTT CCTCCTCGCC 
    TGGCTCTGCA TCTTCCCCGC AGTGATGTCT CCATGCAAGA TCATGAAGTG CAACTCTGAA
    TTTTTGGCCG CCACATCGGG GACACAGCCC CCAGGCCCTG AGGAAGCTCC TGAGTTCTGT
    ACTGCCCTGC GGGCCTACGC TCTCTGCACC CACCACACGG CTCGCACCTG CCGGGGAGAC
    CTCTTCTACC ATTCTGCAGT CCATGGCATC GATGATCTCA TGACCCAACA CAACTGCTCC
    AAAGATGGGC CCACCTCCCA GCCCCGCCTC CCCCCGCTGC CCCGGGGTGA CAGCCAGGAG
    CGCTCTGACA GCCCGGAGAG CTGTCATTAT GAACGTAGCT TCCACAAACA TTCCTTGCGT
    CCCAACTACA CCCACTGCGG GCTGTTTGGA GACCCGCACC TGCGGACGTT TTCAGACAGC
    TTCCAGACAT GCAAAGTCCA GGGGGCCTGG CCGCTCATTG ACAACAACTA CCTGAATGTG
    CAGGTCACCA ACACCCCTGT CTTGCCTGGC TCCCTGGCAA CAGCCACCAC CAAGCTCACT
    ATCATTTTCA AGAGCTTCCA GGAGTGTGTG GATCAAAAGG TGTACCAGGC AGAGATGGAT
    GAACTCCCAG CAGCCTTTGC TGATGGCTCC AAGAATGGCG GTGACAAGCA TGGTGCTAAC
    AGCCTGAAGA TCACCGAGAA GGTGTCTGGC CAACACATTG AAATTCAGGC CAAATACATT
    GGCACCACCA TCGTGGTGAG GCAAGTCGGC CGCTACCTCA CCTTTGCCGT CCGGATGCCA
    GAGGAGGTCG TGAAAGCTGT GGAGGATGGA GACAACCAGG GCCTCTATCT CTGCCTCCGG
    GGTTGTCCAC TCAACCAGCA GATAGACTTC CATGCCTTCC ATTCCACCCC AAAGGCTACT
    GAAAACCGCC CCCACCGGAA AGGCTCAAAC CTACCTTCTT CACCAGAGGC ATTCACCTAC
    GAAACAGCCA CAGCCAAATG CAAAGAGAAA CTTCCAGTAG AGGACTTGTA CTTCCAGTCC
    TGTGTCTTTG ACCTCTTGAC TACAGGCGAC GTCAACTTTA CCCTTGCTGC TTATTATGCT
    TTTGAAGATG TCAAGATGCT CCACTCCAAC AAAGACAAGC TTCATCTGTT TGAAAGGACA
    CGACACTTGG AGTCAGGCAA TATGGCCAGC TTAGAGCCTT CCGTGGCTCT GTTTCTTTCA
    CTCTTGGCAT TCCTATGCTT GAATCAAAGT CCAGCCCTTT TCTTATAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPy02226
    Clone ID Related Accession (Same CDS sequence) XM_007422337.1
    Accession Version XM_007422337.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1233bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-03-10
    Organism Python bivittatus(Burmese python)
    Product repulsive guidance molecule A isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_006532202.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Python bivittatus Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.5 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    ATGTGGGTGA TGTCTCCATG CAAGATCATG AAGTGCAACT CTGAATTTTT GGCCGCCACA 
    TCGGGGACAC AGCCCCCAGG CCCTGAGGAA GCTCCTGAGT TCTGTACTGC CCTGCGGGCC
    TACGCTCTCT GCACCCACCA CACGGCTCGC ACCTGCCGGG GAGACCTCTT CTACCATTCT
    GCAGTCCATG GCATCGATGA TCTCATGACC CAACACAACT GCTCCAAAGA TGGGCCCACC
    TCCCAGCCCC GCCTCCCCCC GCTGCCCCGG GGTGACAGCC AGGAGCGCTC TGACAGCCCG
    GAGAGCTGTC ATTATGAACG TAGCTTCCAC AAACATTCCT TGCGTCCCAA CTACACCCAC
    TGCGGGCTGT TTGGAGACCC GCACCTGCGG ACGTTTTCAG ACAGCTTCCA GACATGCAAA
    GTCCAGGGGG CCTGGCCGCT CATTGACAAC AACTACCTGA ATGTGCAGGT CACCAACACC
    CCTGTCTTGC CTGGCTCCCT GGCAACAGCC ACCACCAAGC TCACTATCAT TTTCAAGAGC
    TTCCAGGAGT GTGTGGATCA AAAGGTGTAC CAGGCAGAGA TGGATGAACT CCCAGCAGCC
    TTTGCTGATG GCTCCAAGAA TGGCGGTGAC AAGCATGGTG CTAACAGCCT GAAGATCACC
    GAGAAGGTGT CTGGCCAACA CATTGAAATT CAGGCCAAAT ACATTGGCAC CACCATCGTG
    GTGAGGCAAG TCGGCCGCTA CCTCACCTTT GCCGTCCGGA TGCCAGAGGA GGTCGTGAAA
    GCTGTGGAGG ATGGAGACAA CCAGGGCCTC TATCTCTGCC TCCGGGGTTG TCCACTCAAC
    CAGCAGATAG ACTTCCATGC CTTCCATTCC ACCCCAAAGG CTACTGAAAA CCGCCCCCAC
    CGGAAAGGCT CAAACCTACC TTCTTCACCA GAGGCATTCA CCTACGAAAC AGCCACAGCC
    AAATGCAAAG AGAAACTTCC AGTAGAGGAC TTGTACTTCC AGTCCTGTGT CTTTGACCTC
    TTGACTACAG GCGACGTCAA CTTTACCCTT GCTGCTTATT ATGCTTTTGA AGATGTCAAG
    ATGCTCCACT CCAACAAAGA CAAGCTTCAT CTGTTTGAAA GGACACGACA CTTGGAGTCA
    GGCAATATGG CCAGCTTAGA GCCTTCCGTG GCTCTGTTTC TTTCACTCTT GGCATTCCTA
    TGCTTGAATC AAAGTCCAGC CCTTTTCTTA TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_007422399.1
    CDS111..1343
    Translation

    Target ORF information:

    RefSeq Version XM_007422337.1
    Organism Python bivittatus(Burmese python)
    Definition Python bivittatus repulsive guidance molecule family member a (RGMA), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_007422337.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    ATGTGGGTGA TGTCTCCATG CAAGATCATG AAGTGCAACT CTGAATTTTT GGCCGCCACA 
    TCGGGGACAC AGCCCCCAGG CCCTGAGGAA GCTCCTGAGT TCTGTACTGC CCTGCGGGCC
    TACGCTCTCT GCACCCACCA CACGGCTCGC ACCTGCCGGG GAGACCTCTT CTACCATTCT
    GCAGTCCATG GCATCGATGA TCTCATGACC CAACACAACT GCTCCAAAGA TGGGCCCACC
    TCCCAGCCCC GCCTCCCCCC GCTGCCCCGG GGTGACAGCC AGGAGCGCTC TGACAGCCCG
    GAGAGCTGTC ATTATGAACG TAGCTTCCAC AAACATTCCT TGCGTCCCAA CTACACCCAC
    TGCGGGCTGT TTGGAGACCC GCACCTGCGG ACGTTTTCAG ACAGCTTCCA GACATGCAAA
    GTCCAGGGGG CCTGGCCGCT CATTGACAAC AACTACCTGA ATGTGCAGGT CACCAACACC
    CCTGTCTTGC CTGGCTCCCT GGCAACAGCC ACCACCAAGC TCACTATCAT TTTCAAGAGC
    TTCCAGGAGT GTGTGGATCA AAAGGTGTAC CAGGCAGAGA TGGATGAACT CCCAGCAGCC
    TTTGCTGATG GCTCCAAGAA TGGCGGTGAC AAGCATGGTG CTAACAGCCT GAAGATCACC
    GAGAAGGTGT CTGGCCAACA CATTGAAATT CAGGCCAAAT ACATTGGCAC CACCATCGTG
    GTGAGGCAAG TCGGCCGCTA CCTCACCTTT GCCGTCCGGA TGCCAGAGGA GGTCGTGAAA
    GCTGTGGAGG ATGGAGACAA CCAGGGCCTC TATCTCTGCC TCCGGGGTTG TCCACTCAAC
    CAGCAGATAG ACTTCCATGC CTTCCATTCC ACCCCAAAGG CTACTGAAAA CCGCCCCCAC
    CGGAAAGGCT CAAACCTACC TTCTTCACCA GAGGCATTCA CCTACGAAAC AGCCACAGCC
    AAATGCAAAG AGAAACTTCC AGTAGAGGAC TTGTACTTCC AGTCCTGTGT CTTTGACCTC
    TTGACTACAG GCGACGTCAA CTTTACCCTT GCTGCTTATT ATGCTTTTGA AGATGTCAAG
    ATGCTCCACT CCAACAAAGA CAAGCTTCAT CTGTTTGAAA GGACACGACA CTTGGAGTCA
    GGCAATATGG CCAGCTTAGA GCCTTCCGTG GCTCTGTTTC TTTCACTCTT GGCATTCCTA
    TGCTTGAATC AAAGTCCAGC CCTTTTCTTA TAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.