IRS2 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

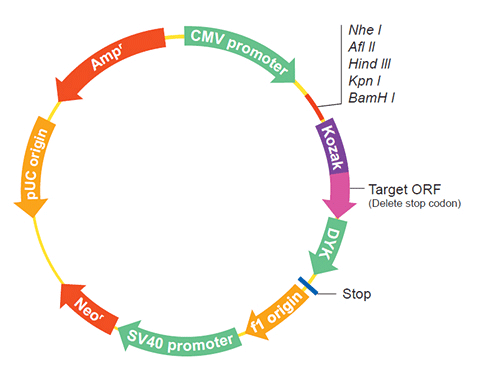
The following IRS2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the IRS2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs05387 XM_005516839.2
Latest version!
Pseudopodoces humilis insulin receptor substrate 2 (IRS2), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OPs05388 XM_014249282.1
Latest version!
Pseudopodoces humilis insulin receptor substrate 2 (IRS2), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OPs05389 XM_014249291.1
Latest version!
Pseudopodoces humilis insulin receptor substrate 2 (IRS2), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs05387
    Clone ID Related Accession (Same CDS sequence) XM_005516839.2
    Accession Version XM_005516839.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3627bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product insulin receptor substrate 2 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087554.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 21, 2015 this sequence version replaced XM_005516839.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGCGAGCC CCGCTGTGCT GGGGCTGCTG CCCCCCCTGA GCTCCCCGCC CGGCCCCAAC 
    CTGAACAACA ACAATAACAA CAACCAGGGC GTCAGGAAGT GCGGGTACCT GCGCAAGCAG
    AAGCACGGCC ACAAGCGCTT CTTCGTGCTT CGCGGCCCGG GCGGCGGCGG GGAGGAGGCG
    GGGGGCGCCC GGCTGGAGTA CTACGAGAGC GAGAAGAAAT GGAGGAACAA GTCCGGGGCG
    CCCAAGCGGG TGATCTCCCT GGACTCCTGC CTCAACATCA ACAAGCGGGC GGACGCCAAG
    CACAAGTACC TCATCGCCCT CTACACCAAG GACGAGTACT TCGCTGTGGC TGCCGAGAAC
    GAGCAGGAGC AGGAGGGCTG GTACAGGGCT CTCACCGACC TGCTCAACGA AGGCAAGGCG
    GCCTGCCAAG GGTCCCCCTA CCGCCACCTC GCCTCCCCCT TTTCCGCCTC CTGCGGCGCG
    GCCGCCGCCT CCCTGGCCGC CGCCGGCGAA GACCTTAACT ACGGGCTGAT CACGCCCGCC
    ACCGCTGCCT ACCGAGAGGT CTGGCAGGTG ACGCTGAAGC CCAAGGGCTT GGGGCAGAGT
    AAAAACCTCA CCGGCGTCCA CCGGCTCTGC CTCTCGGCCC GCACCATTGG GTTCGTGCGC
    CTCAATTGCG AGCTGCCCTC TGTCACGCTG CAGCTGATGA ACATCCGCCG CTGCGGCCAC
    TCCGACAGTT TCTTCTTCAT CGAGGTGGGG CGCTCGGCCG CCACCGGTCC CGGCGAGCTC
    TGGATGCAAG CGGACGACTC GGTGGTGGCC CAGAACATCC ACGAGACCAT CCTGGAGGCC
    ATGAAGGCGC TGAAGGAGCT GTCCGAGTTC CGGCCCCGCA GCAAGAGCCA GTCCTCTTCC
    TCCTCTTCCT CCGGCGGGGC CGGCGGGCCC GGCGGCAGCG GCGCCTCCGC CACCCACCCC
    ATCACCGTGC CCGGTCGCCG GCACCACCAC CTGGTCAACC TGCCTCCCAG CCAGACCGGC
    CTCCTCCGCC GTTCCCGCAC CGACAGCCTC GCCGCCGGCG CCGGCACCAA GTGCACGCCG
    TGCCGGGTGA GAACGGCCAG CGAGGGCGAC GGCTGCCGGG TGGGCTCTGC GGCCGGCAGC
    CCCATGAGCC CGGGCCCCGT GCGGACCCCC TTGAGCCGCT CGCACACGCT CAGCGGCGGC
    GGGGGGCGGC AGGCGGGGAA GCTGCTCCCG GTTCTGGCCG GCAGTGGCGG GCTGCAGAGC
    AGCCGTTCCA TGTCCATGCC CGCCTCCCAC TCGCCCCCCT CCGCCACCAG CCCCATCAGC
    CTCTCCTCCA GTAGCGGCCT CGGCTCCGAG ACTGCCCATC CGCATCACCC GCAGCGCCCG
    TCCAGCGGCA GCGCCTCCGT GTCCGGCTCC CCCAGCGACG CCGGCTTTAT GTCCTTCGAT
    GAGTACGGCT CCAGCCCAGG CGGCGACCTC CGGCCCTTCT CCTCCTCCTC CACTGCCAGC
    AATCGCAGCA ACACCCCCGA GTCGGTGGCC GAGACTCCCC CGGTGCGGGA CCCGGGGGGC
    GGCACCGACC TCTACGGCTA CATGGCGATG GAGCGGCCTC CGAGTGGCCG CCTCTGCTAC
    CGGCCCTGTC CCGACGCTGC CAGCGACAGG TGCCATCGGA AGCGGACCTA CTCCCTGACC
    ACGCCGTGCC GGCAGCGACC CGCCGCGCCG CAGGTTTCCT CCGCCTCCCT TGACGAGTAC
    ACGCTGATGC GCGCCACCTT CGCCGGCAGC GCCGGCCGCC TCTTCCCCTC CTGCCAAGCT
    GGGGCTTCCC CCAAAGTGAC CTACACCCCC TACCCCGAGG ACTACGGGGA CATCGAGATC
    GGTTCTCACC GCAGCTCCGG CAGCAGCAGC ACCAATCTGG GCCCGCCGGC AGTGGGGGGA
    GGAGGGGGAG ATGATGACGG CTACATGCCC ATGACCCCCG GTGTGGCCGC ATCCTTAGGG
    CAGGGAAGCC GGGGCAGCGA TGATTACATG CCCATGAGCC CCACCAGCGT GTCTGCCCCC
    AAGCAGATCC TGCAGCCCCG GGCAGGGGTG GGTAGTGGGT CCCCGGGGAA CGGGAGCAGC
    TACAAGACCA GCTCGCCTGG GGAGAGCTCC CCTGACGATA GCGGGTACAT GCGGATGTGG
    TGCGGCTCCA AGCTGTCAGT GGAGAGCTCA GATGGAAGGC TGAGTAACGG CGACTATATC
    AATATGTCCC CTCGAGACCC CCAGAACGGG CCCCACGCTC CCTCCCTCAC CCCCCCAGAC
    TTCTTTTTTG CCCCTTCAGA GCACGGGTCT AGTGAGCCCC CAAAGCCCAG CTGCTATTCA
    TACAGCTCCT TACCCCGCTC CTACAAGAGC CAGGGCTTGG CAAAGGACAG TGACCAGTAT
    GTGTTCATGA ACTCCCCGGG GAGGATGATC CCGGAGGAGG CGGTGTGTGG AGCGAGCCAG
    CTGCCTGCAG GCACCTTCGC CCCCTCCAGC CACACGGTGC CTTCGCCCCT GCGGCACAGC
    CGGACCGAGA GCTTCCTTAG CCAGCGGTGC CAGCGGGTGG CCCGGCCCAG CCGCCTTTCT
    TTGGAGACCT TGCGGACGAT GCTGCCCAGC ATGAACGAGC ACCCTCTGCC GCCTGAGCCC
    AAGAGCCCTG GTGAATACAT CAACATTGAC TTTGGGGATG CTGCTGTGTA TTCTCCCCCC
    TCGCTGCCTG CTGACAGCCC AGCCTCCTCC CTGGGCTCAG GCACGGGGCA GAGGCGCTCC
    CCTCTCTCCG ACTACATGAA CATTGACTTC GGGTCACAGT CACCCTCCCA GTCGGGCACG
    GTCTCAGTGG GCTCCTTGGA AGCTCTCTCT CCGGGTTCTT CCTCCAGCAC CAGCCAGCCC
    AACGGGTGCT ACCTGAAGGC GGCTGTGGGG GTTGCTTGTT CGTCCAGCCC ATCGGATGGC
    GGTGATTACA CCGAGATGAC CTTTGGCATG GCCACTACCC CACCTCAACC CATCGTTCAG
    AAACCAGAAA GTGCCCGGGT CACCAGCCCC ACATCTGGCG TGAAGAGGCT CACCCTTTCT
    GGGGTGGAGG CTTTCATTCT CTCCAGCCCT CCCCCAGACC CGAATCGGGG GGCGAAAGTA
    ATCCGGGCAG ATCCCCAGGG GCGGAGGAGG CACAGCTCAG AAACTTTCTC CTCCACCACC
    ACTGTGACCC CAGTGTCCCC CTCCTTCGCA CACAACCCCA AACGACACAA CTCGGCCTCG
    GTGGAGAACG TGTCCCTCAG GAAAAGCGAA GGCCTGGAGG AGGAGCAGGG TAGCAGTCCC
    ATGTGCCGGG AGACCTCGGC TGGCTTCCAG AATGGCCTCA ACTACATCGC CATTGATGTA
    GTGGATGGGT CCCAGGCAAA CTGTGACAAA TCCAGGTTGA AAGCTAGGCA CCTCCTGAAT
    GGGGGCATCA ATGGAGTAGA GATGAGCACC TATGCCAGCA TAGACTTCCT GTCTCACAAC
    CTGAAAGAAG CCAGTGCTGT GAAAGCTTCT AAACGCAGAT CACATGGAGG AATGGTGCGG
    GGAGGCTCGT TGGGATTGAC CCTATCTGTA GGAGGTGGGC TGTCTTCTCC AGCACCTCGC
    TTCCCTGAGA AGGGTGCCAG CCTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005516896.2
    CDS335..3961
    Translation

    Target ORF information:

    RefSeq Version XM_005516839.2
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis insulin receptor substrate 2 (IRS2), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005516839.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGGCGAGCC CCGCTGTGCT GGGGCTGCTG CCCCCCCTGA GCTCCCCGCC CGGCCCCAAC 
    CTGAACAACA ACAATAACAA CAACCAGGGC GTCAGGAAGT GCGGGTACCT GCGCAAGCAG
    AAGCACGGCC ACAAGCGCTT CTTCGTGCTT CGCGGCCCGG GCGGCGGCGG GGAGGAGGCG
    GGGGGCGCCC GGCTGGAGTA CTACGAGAGC GAGAAGAAAT GGAGGAACAA GTCCGGGGCG
    CCCAAGCGGG TGATCTCCCT GGACTCCTGC CTCAACATCA ACAAGCGGGC GGACGCCAAG
    CACAAGTACC TCATCGCCCT CTACACCAAG GACGAGTACT TCGCTGTGGC TGCCGAGAAC
    GAGCAGGAGC AGGAGGGCTG GTACAGGGCT CTCACCGACC TGCTCAACGA AGGCAAGGCG
    GCCTGCCAAG GGTCCCCCTA CCGCCACCTC GCCTCCCCCT TTTCCGCCTC CTGCGGCGCG
    GCCGCCGCCT CCCTGGCCGC CGCCGGCGAA GACCTTAACT ACGGGCTGAT CACGCCCGCC
    ACCGCTGCCT ACCGAGAGGT CTGGCAGGTG ACGCTGAAGC CCAAGGGCTT GGGGCAGAGT
    AAAAACCTCA CCGGCGTCCA CCGGCTCTGC CTCTCGGCCC GCACCATTGG GTTCGTGCGC
    CTCAATTGCG AGCTGCCCTC TGTCACGCTG CAGCTGATGA ACATCCGCCG CTGCGGCCAC
    TCCGACAGTT TCTTCTTCAT CGAGGTGGGG CGCTCGGCCG CCACCGGTCC CGGCGAGCTC
    TGGATGCAAG CGGACGACTC GGTGGTGGCC CAGAACATCC ACGAGACCAT CCTGGAGGCC
    ATGAAGGCGC TGAAGGAGCT GTCCGAGTTC CGGCCCCGCA GCAAGAGCCA GTCCTCTTCC
    TCCTCTTCCT CCGGCGGGGC CGGCGGGCCC GGCGGCAGCG GCGCCTCCGC CACCCACCCC
    ATCACCGTGC CCGGTCGCCG GCACCACCAC CTGGTCAACC TGCCTCCCAG CCAGACCGGC
    CTCCTCCGCC GTTCCCGCAC CGACAGCCTC GCCGCCGGCG CCGGCACCAA GTGCACGCCG
    TGCCGGGTGA GAACGGCCAG CGAGGGCGAC GGCTGCCGGG TGGGCTCTGC GGCCGGCAGC
    CCCATGAGCC CGGGCCCCGT GCGGACCCCC TTGAGCCGCT CGCACACGCT CAGCGGCGGC
    GGGGGGCGGC AGGCGGGGAA GCTGCTCCCG GTTCTGGCCG GCAGTGGCGG GCTGCAGAGC
    AGCCGTTCCA TGTCCATGCC CGCCTCCCAC TCGCCCCCCT CCGCCACCAG CCCCATCAGC
    CTCTCCTCCA GTAGCGGCCT CGGCTCCGAG ACTGCCCATC CGCATCACCC GCAGCGCCCG
    TCCAGCGGCA GCGCCTCCGT GTCCGGCTCC CCCAGCGACG CCGGCTTTAT GTCCTTCGAT
    GAGTACGGCT CCAGCCCAGG CGGCGACCTC CGGCCCTTCT CCTCCTCCTC CACTGCCAGC
    AATCGCAGCA ACACCCCCGA GTCGGTGGCC GAGACTCCCC CGGTGCGGGA CCCGGGGGGC
    GGCACCGACC TCTACGGCTA CATGGCGATG GAGCGGCCTC CGAGTGGCCG CCTCTGCTAC
    CGGCCCTGTC CCGACGCTGC CAGCGACAGG TGCCATCGGA AGCGGACCTA CTCCCTGACC
    ACGCCGTGCC GGCAGCGACC CGCCGCGCCG CAGGTTTCCT CCGCCTCCCT TGACGAGTAC
    ACGCTGATGC GCGCCACCTT CGCCGGCAGC GCCGGCCGCC TCTTCCCCTC CTGCCAAGCT
    GGGGCTTCCC CCAAAGTGAC CTACACCCCC TACCCCGAGG ACTACGGGGA CATCGAGATC
    GGTTCTCACC GCAGCTCCGG CAGCAGCAGC ACCAATCTGG GCCCGCCGGC AGTGGGGGGA
    GGAGGGGGAG ATGATGACGG CTACATGCCC ATGACCCCCG GTGTGGCCGC ATCCTTAGGG
    CAGGGAAGCC GGGGCAGCGA TGATTACATG CCCATGAGCC CCACCAGCGT GTCTGCCCCC
    AAGCAGATCC TGCAGCCCCG GGCAGGGGTG GGTAGTGGGT CCCCGGGGAA CGGGAGCAGC
    TACAAGACCA GCTCGCCTGG GGAGAGCTCC CCTGACGATA GCGGGTACAT GCGGATGTGG
    TGCGGCTCCA AGCTGTCAGT GGAGAGCTCA GATGGAAGGC TGAGTAACGG CGACTATATC
    AATATGTCCC CTCGAGACCC CCAGAACGGG CCCCACGCTC CCTCCCTCAC CCCCCCAGAC
    TTCTTTTTTG CCCCTTCAGA GCACGGGTCT AGTGAGCCCC CAAAGCCCAG CTGCTATTCA
    TACAGCTCCT TACCCCGCTC CTACAAGAGC CAGGGCTTGG CAAAGGACAG TGACCAGTAT
    GTGTTCATGA ACTCCCCGGG GAGGATGATC CCGGAGGAGG CGGTGTGTGG AGCGAGCCAG
    CTGCCTGCAG GCACCTTCGC CCCCTCCAGC CACACGGTGC CTTCGCCCCT GCGGCACAGC
    CGGACCGAGA GCTTCCTTAG CCAGCGGTGC CAGCGGGTGG CCCGGCCCAG CCGCCTTTCT
    TTGGAGACCT TGCGGACGAT GCTGCCCAGC ATGAACGAGC ACCCTCTGCC GCCTGAGCCC
    AAGAGCCCTG GTGAATACAT CAACATTGAC TTTGGGGATG CTGCTGTGTA TTCTCCCCCC
    TCGCTGCCTG CTGACAGCCC AGCCTCCTCC CTGGGCTCAG GCACGGGGCA GAGGCGCTCC
    CCTCTCTCCG ACTACATGAA CATTGACTTC GGGTCACAGT CACCCTCCCA GTCGGGCACG
    GTCTCAGTGG GCTCCTTGGA AGCTCTCTCT CCGGGTTCTT CCTCCAGCAC CAGCCAGCCC
    AACGGGTGCT ACCTGAAGGC GGCTGTGGGG GTTGCTTGTT CGTCCAGCCC ATCGGATGGC
    GGTGATTACA CCGAGATGAC CTTTGGCATG GCCACTACCC CACCTCAACC CATCGTTCAG
    AAACCAGAAA GTGCCCGGGT CACCAGCCCC ACATCTGGCG TGAAGAGGCT CACCCTTTCT
    GGGGTGGAGG CTTTCATTCT CTCCAGCCCT CCCCCAGACC CGAATCGGGG GGCGAAAGTA
    ATCCGGGCAG ATCCCCAGGG GCGGAGGAGG CACAGCTCAG AAACTTTCTC CTCCACCACC
    ACTGTGACCC CAGTGTCCCC CTCCTTCGCA CACAACCCCA AACGACACAA CTCGGCCTCG
    GTGGAGAACG TGTCCCTCAG GAAAAGCGAA GGCCTGGAGG AGGAGCAGGG TAGCAGTCCC
    ATGTGCCGGG AGACCTCGGC TGGCTTCCAG AATGGCCTCA ACTACATCGC CATTGATGTA
    GTGGATGGGT CCCAGGCAAA CTGTGACAAA TCCAGGTTGA AAGCTAGGCA CCTCCTGAAT
    GGGGGCATCA ATGGAGTAGA GATGAGCACC TATGCCAGCA TAGACTTCCT GTCTCACAAC
    CTGAAAGAAG CCAGTGCTGT GAAAGCTTCT AAACGCAGAT CACATGGAGG AATGGTGCGG
    GGAGGCTCGT TGGGATTGAC CCTATCTGTA GGAGGTGGGC TGTCTTCTCC AGCACCTCGC
    TTCCCTGAGA AGGGTGCCAG CCTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs05388
    Clone ID Related Accession (Same CDS sequence) XM_014249282.1
    Accession Version XM_014249282.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3531bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product insulin receptor substrate 2 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087554.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGGCGAGCC CCGCTGTGCT GGGGCTGCTG CCCCCCCTGA GCTCCCCGCC CGGCCCCAAC 
    CTGAACAACA ACAATAACAA CAACCAGGGC GTCAGGAAGT GCGGGTACCT GCGCAAGCAG
    AAGCACGGCC ACAAGCGCTT CTTCGTGCTT CGCGGCCCGG GCGGCGGCGG GGAGGAGGCG
    GGGGGCGCCC GGCTGGAGTA CTACGAGAGC GAGAAGAAAT GGAGGAACAA GTCCGGGGCG
    CCCAAGCGGG TGATCTCCCT GGACTCCTGC CTCAACATCA ACAAGCGGGC GGACGCCAAG
    CACAAGTACC TCATCGCCCT CTACACCAAG GACGAGTACT TCGCTGTGGC TGCCGAGAAC
    GAGCAGGAGC AGGAGGGCTG GTACAGGGCT CTCACCGACC TGCTCAACGA AGGCAAGGCG
    GCCTGCCAAG GGTCCCCCTA CCGCCACCTC GCCTCCCCCT TTTCCGCCTC CTGCGGCGCG
    GCCGCCGCCT CCCTGGCCGC CGCCGGCGAA GACCTTAACT ACGGGCTGAT CACGCCCGCC
    ACCGCTGCCT ACCGAGAGGT CTGGCAGGTG ACGCTGAAGC CCAAGGGCTT GGGGCAGAGT
    AAAAACCTCA CCGGCGTCCA CCGGCTCTGC CTCTCGGCCC GCACCATTGG GTTCGTGCGC
    CTCAATTGCG AGCTGCCCTC TGTCACGCTG CAGCTGATGA ACATCCGCCG CTGCGGCCAC
    TCCGACAGTT TCTTCTTCAT CGAGGTGGGG CGCTCGGCCG CCACCGGTCC CGGCGAGCTC
    TGGATGCAAG CGGACGACTC GGTGGTGGCC CAGAACATCC ACGAGACCAT CCTGGAGGCC
    ATGAAGGCGC TGAAGGAGCT GTCCGAGTTC CGGCCCCGCA GCAAGAGCCA GTCCTCTTCC
    TCCTCTTCCT CCGGCGGGGC CGGCGGGCCC GGCGGCAGCG GCGCCTCCGC CACCCACCCC
    ATCACCGTGC CCGGTCGCCG GCACCACCAC CTGGTCAACC TGCCTCCCAG CCAGACCGGC
    CTCCTCCGCC GTTCCCGCAC CGACAGCCTC GCCGCCGGCG CCGGCACCAA GTGCACGCCG
    TGCCGGGTGA GAACGGCCAG CGAGGGCGAC GGCTGCCGGG TGGGCTCTGC GGCCGGCAGC
    CCCATGAGCC CGGGCCCCGT GCGGACCCCC TTGAGCCGCT CGCACACGCT CAGCGGCGGC
    GGGGGGCGGC AGGCGGGGAA GCTGCTCCCG GTTCTGGCCG GCAGTGGCGG GCTGCAGAGC
    AGCCGTTCCA TGTCCATGCC CGCCTCCCAC TCGCCCCCCT CCGCCACCAG CCCCATCAGC
    CTCTCCTCCA GTAGCGGCCT CGGCTCCGAG ACTGCCCATC CGCATCACCC GCAGCGCCCG
    TCCAGCGGCA GCGCCTCCGT GTCCGGCTCC CCCAGCGACG CCGGCTTTAT GTCCTTCGAT
    GAGTACGGCT CCAGCCCAGG CGGCGACCTC CGGCCCTTCT CCTCCTCCTC CACTGCCAGC
    AATCGCAGCA ACACCCCCGA GTCGGTGGCC GAGACTCCCC CGGTGCGGGA CCCGGGGGGC
    GGCACCGACC TCTACGGCTA CATGGCGATG GAGCGGCCTC CGAGTGGCCG CCTCTGCTAC
    CGGCCCTGTC CCGACGCTGC CAGCGACAGG TGCCATCGGA AGCGGACCTA CTCCCTGACC
    ACGCCGTGCC GGCAGCGACC CGCCGCGCCG CAGGTTTCCT CCGCCTCCCT TGACGAGTAC
    ACGCTGATGC GCGCCACCTT CGCCGGCAGC GCCGGCCGCC TCTTCCCCTC CTGCCAAGCT
    GGGGCTTCCC CCAAAGTGAC CTACACCCCC TACCCCGAGG ACTACGGGGA CATCGAGATC
    GGTTCTCACC GCAGCTCCGG CAGCAGCAGC ACCAATCTGG GCCCGCCGGC AGTGGGGGGA
    GGAGGGGGAG ATGATGACGG CTACATGCCC ATGACCCCCG GTGTGGCCGC ATCCTTAGGG
    CAGGGAAGCC GGGGCAGCGA TGATTACATG CCCATGAGCC CCACCAGCGT GTCTGCCCCC
    AAGCAGATCC TGCAGCCCCG GGCAGGGGTG GGTAGTGGGT CCCCGGGGAA CGGGAGCAGC
    TACAAGACCA GCTCGCCTGG GGAGAGCTCC CCTGACGATA GCGGGTACAT GCGGATGTGG
    TGCGGCTCCA AGCTGTCAGT GGAGAGCTCA GATGGAAGGC TGAGTAACGG CGACTATATC
    AATATGTCCC CTCGAGACCC CCAGAACGGG CCCCACGCTC CCTCCCTCAC CCCCCCAGAC
    TTCTTTTTTG CCCCTTCAGA GCACGGGTCT AGTGAGCCCC CAAAGCCCAG CTGCTATTCA
    TACAGCTCCT TACCCCGCTC CTACAAGAGC CAGGGCTTGG CAAAGGACAG TGACCAGTAT
    GTGTTCATGA ACTCCCCGGG GAGGATGATC CCGGAGGAGG CGGTGTGTGG AGCGAGCCAG
    CTGCCTGCAG GCACCTTCGC CCCCTCCAGC CACACGGTGC CTTCGCCCCT GCGGCACAGC
    CGGACCGAGA GCTTCCTTAG CCAGCGGTGC CAGCGGGTGG CCCGGCCCAG CCGCCTTTCT
    TTGGAGACCT TGCGGACGAT GCTGCCCAGC ATGAACGAGC ACCCTCTGCC GCCTGAGCCC
    AAGAGCCCTG GTGAATACAT CAACATTGAC TTTGGGGATG CTGCTGTGTA TTCTCCCCCC
    TCGCTGCCTG CTGACAGCCC AGCCTCCTCC CTGGGCTCAG GCACGGGGCA GAGGCGCTCC
    CCTCTCTCCG ACTACATGAA CATTGACTTC GGGTCACAGT CACCCTCCCA GTCGGGCACG
    GTCTCAGTGG GCTCCTTGGA AGCTCTCTCT CCGGGTTCTT CCTCCAGCAC CAGCCAGCCC
    AACGGGTGCT ACCTGAAGGC GGCTGTGGGG GTTGCTTGTT CGTCCAGCCC ATCGGATGGC
    GGTGATTACA CCGAGATGAC CTTTGGCATG GCCACTACCC CACCTCAACC CATCGTTCAG
    AAACCAGAAA GTGCCCGGGT CACCAGCCCC ACATCTGGCG TGAAGAGGCT CACCCTTTCT
    GGGGTGGAGG CTTTCATTCT CTCCAGCCCT CCCCCAGACC CGAATCGGGG GGCGAAAGTA
    ATCCGGGCAG ATCCCCAGGG GCGGAGGAGG CACAGCTCAG AAACTTTCTC CTCCACCACC
    ACTGTGACCC CAGTGTCCCC CTCCTTCGCA CACAACCCCA AACGACACAA CTCGGCCTCG
    GTGGAGAACG TGTCCCTCAG GAAAAGCGAA GGCCTGGAGG AGGAGCAGGG TAGCAGTCCC
    ATGTGCCGGG AGACCTCGGC TGGCTTCCAG AATGGCCTCA ACTACATCGC CATTGATGTA
    GTGGATGGGT CCCAGGCAAA CTGTGACAAA TCCAGGTTGA AAGCTAGGCA CCTCCTGAAT
    GGGGGCATCA ATGGAGTAGA GATGAGCACC TATGCCAGCA TAGACTTCCT GTCTCACAAC
    CTGAAAGAAG CCAGTGCTGT GAAAGGAAGT ACAGGAAGAT GGAAAAGATG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014104757.1
    CDS335..3865
    Translation

    Target ORF information:

    RefSeq Version XM_014249282.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis insulin receptor substrate 2 (IRS2), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014249282.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGGCGAGCC CCGCTGTGCT GGGGCTGCTG CCCCCCCTGA GCTCCCCGCC CGGCCCCAAC 
    CTGAACAACA ACAATAACAA CAACCAGGGC GTCAGGAAGT GCGGGTACCT GCGCAAGCAG
    AAGCACGGCC ACAAGCGCTT CTTCGTGCTT CGCGGCCCGG GCGGCGGCGG GGAGGAGGCG
    GGGGGCGCCC GGCTGGAGTA CTACGAGAGC GAGAAGAAAT GGAGGAACAA GTCCGGGGCG
    CCCAAGCGGG TGATCTCCCT GGACTCCTGC CTCAACATCA ACAAGCGGGC GGACGCCAAG
    CACAAGTACC TCATCGCCCT CTACACCAAG GACGAGTACT TCGCTGTGGC TGCCGAGAAC
    GAGCAGGAGC AGGAGGGCTG GTACAGGGCT CTCACCGACC TGCTCAACGA AGGCAAGGCG
    GCCTGCCAAG GGTCCCCCTA CCGCCACCTC GCCTCCCCCT TTTCCGCCTC CTGCGGCGCG
    GCCGCCGCCT CCCTGGCCGC CGCCGGCGAA GACCTTAACT ACGGGCTGAT CACGCCCGCC
    ACCGCTGCCT ACCGAGAGGT CTGGCAGGTG ACGCTGAAGC CCAAGGGCTT GGGGCAGAGT
    AAAAACCTCA CCGGCGTCCA CCGGCTCTGC CTCTCGGCCC GCACCATTGG GTTCGTGCGC
    CTCAATTGCG AGCTGCCCTC TGTCACGCTG CAGCTGATGA ACATCCGCCG CTGCGGCCAC
    TCCGACAGTT TCTTCTTCAT CGAGGTGGGG CGCTCGGCCG CCACCGGTCC CGGCGAGCTC
    TGGATGCAAG CGGACGACTC GGTGGTGGCC CAGAACATCC ACGAGACCAT CCTGGAGGCC
    ATGAAGGCGC TGAAGGAGCT GTCCGAGTTC CGGCCCCGCA GCAAGAGCCA GTCCTCTTCC
    TCCTCTTCCT CCGGCGGGGC CGGCGGGCCC GGCGGCAGCG GCGCCTCCGC CACCCACCCC
    ATCACCGTGC CCGGTCGCCG GCACCACCAC CTGGTCAACC TGCCTCCCAG CCAGACCGGC
    CTCCTCCGCC GTTCCCGCAC CGACAGCCTC GCCGCCGGCG CCGGCACCAA GTGCACGCCG
    TGCCGGGTGA GAACGGCCAG CGAGGGCGAC GGCTGCCGGG TGGGCTCTGC GGCCGGCAGC
    CCCATGAGCC CGGGCCCCGT GCGGACCCCC TTGAGCCGCT CGCACACGCT CAGCGGCGGC
    GGGGGGCGGC AGGCGGGGAA GCTGCTCCCG GTTCTGGCCG GCAGTGGCGG GCTGCAGAGC
    AGCCGTTCCA TGTCCATGCC CGCCTCCCAC TCGCCCCCCT CCGCCACCAG CCCCATCAGC
    CTCTCCTCCA GTAGCGGCCT CGGCTCCGAG ACTGCCCATC CGCATCACCC GCAGCGCCCG
    TCCAGCGGCA GCGCCTCCGT GTCCGGCTCC CCCAGCGACG CCGGCTTTAT GTCCTTCGAT
    GAGTACGGCT CCAGCCCAGG CGGCGACCTC CGGCCCTTCT CCTCCTCCTC CACTGCCAGC
    AATCGCAGCA ACACCCCCGA GTCGGTGGCC GAGACTCCCC CGGTGCGGGA CCCGGGGGGC
    GGCACCGACC TCTACGGCTA CATGGCGATG GAGCGGCCTC CGAGTGGCCG CCTCTGCTAC
    CGGCCCTGTC CCGACGCTGC CAGCGACAGG TGCCATCGGA AGCGGACCTA CTCCCTGACC
    ACGCCGTGCC GGCAGCGACC CGCCGCGCCG CAGGTTTCCT CCGCCTCCCT TGACGAGTAC
    ACGCTGATGC GCGCCACCTT CGCCGGCAGC GCCGGCCGCC TCTTCCCCTC CTGCCAAGCT
    GGGGCTTCCC CCAAAGTGAC CTACACCCCC TACCCCGAGG ACTACGGGGA CATCGAGATC
    GGTTCTCACC GCAGCTCCGG CAGCAGCAGC ACCAATCTGG GCCCGCCGGC AGTGGGGGGA
    GGAGGGGGAG ATGATGACGG CTACATGCCC ATGACCCCCG GTGTGGCCGC ATCCTTAGGG
    CAGGGAAGCC GGGGCAGCGA TGATTACATG CCCATGAGCC CCACCAGCGT GTCTGCCCCC
    AAGCAGATCC TGCAGCCCCG GGCAGGGGTG GGTAGTGGGT CCCCGGGGAA CGGGAGCAGC
    TACAAGACCA GCTCGCCTGG GGAGAGCTCC CCTGACGATA GCGGGTACAT GCGGATGTGG
    TGCGGCTCCA AGCTGTCAGT GGAGAGCTCA GATGGAAGGC TGAGTAACGG CGACTATATC
    AATATGTCCC CTCGAGACCC CCAGAACGGG CCCCACGCTC CCTCCCTCAC CCCCCCAGAC
    TTCTTTTTTG CCCCTTCAGA GCACGGGTCT AGTGAGCCCC CAAAGCCCAG CTGCTATTCA
    TACAGCTCCT TACCCCGCTC CTACAAGAGC CAGGGCTTGG CAAAGGACAG TGACCAGTAT
    GTGTTCATGA ACTCCCCGGG GAGGATGATC CCGGAGGAGG CGGTGTGTGG AGCGAGCCAG
    CTGCCTGCAG GCACCTTCGC CCCCTCCAGC CACACGGTGC CTTCGCCCCT GCGGCACAGC
    CGGACCGAGA GCTTCCTTAG CCAGCGGTGC CAGCGGGTGG CCCGGCCCAG CCGCCTTTCT
    TTGGAGACCT TGCGGACGAT GCTGCCCAGC ATGAACGAGC ACCCTCTGCC GCCTGAGCCC
    AAGAGCCCTG GTGAATACAT CAACATTGAC TTTGGGGATG CTGCTGTGTA TTCTCCCCCC
    TCGCTGCCTG CTGACAGCCC AGCCTCCTCC CTGGGCTCAG GCACGGGGCA GAGGCGCTCC
    CCTCTCTCCG ACTACATGAA CATTGACTTC GGGTCACAGT CACCCTCCCA GTCGGGCACG
    GTCTCAGTGG GCTCCTTGGA AGCTCTCTCT CCGGGTTCTT CCTCCAGCAC CAGCCAGCCC
    AACGGGTGCT ACCTGAAGGC GGCTGTGGGG GTTGCTTGTT CGTCCAGCCC ATCGGATGGC
    GGTGATTACA CCGAGATGAC CTTTGGCATG GCCACTACCC CACCTCAACC CATCGTTCAG
    AAACCAGAAA GTGCCCGGGT CACCAGCCCC ACATCTGGCG TGAAGAGGCT CACCCTTTCT
    GGGGTGGAGG CTTTCATTCT CTCCAGCCCT CCCCCAGACC CGAATCGGGG GGCGAAAGTA
    ATCCGGGCAG ATCCCCAGGG GCGGAGGAGG CACAGCTCAG AAACTTTCTC CTCCACCACC
    ACTGTGACCC CAGTGTCCCC CTCCTTCGCA CACAACCCCA AACGACACAA CTCGGCCTCG
    GTGGAGAACG TGTCCCTCAG GAAAAGCGAA GGCCTGGAGG AGGAGCAGGG TAGCAGTCCC
    ATGTGCCGGG AGACCTCGGC TGGCTTCCAG AATGGCCTCA ACTACATCGC CATTGATGTA
    GTGGATGGGT CCCAGGCAAA CTGTGACAAA TCCAGGTTGA AAGCTAGGCA CCTCCTGAAT
    GGGGGCATCA ATGGAGTAGA GATGAGCACC TATGCCAGCA TAGACTTCCT GTCTCACAAC
    CTGAAAGAAG CCAGTGCTGT GAAAGGAAGT ACAGGAAGAT GGAAAAGATG A

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs05389
    Clone ID Related Accession (Same CDS sequence) XM_014249291.1
    Accession Version XM_014249291.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3510bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product insulin receptor substrate 2 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087554.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGGCGAGCC CCGCTGTGCT GGGGCTGCTG CCCCCCCTGA GCTCCCCGCC CGGCCCCAAC 
    CTGAACAACA ACAATAACAA CAACCAGGGC GTCAGGAAGT GCGGGTACCT GCGCAAGCAG
    AAGCACGGCC ACAAGCGCTT CTTCGTGCTT CGCGGCCCGG GCGGCGGCGG GGAGGAGGCG
    GGGGGCGCCC GGCTGGAGTA CTACGAGAGC GAGAAGAAAT GGAGGAACAA GTCCGGGGCG
    CCCAAGCGGG TGATCTCCCT GGACTCCTGC CTCAACATCA ACAAGCGGGC GGACGCCAAG
    CACAAGTACC TCATCGCCCT CTACACCAAG GACGAGTACT TCGCTGTGGC TGCCGAGAAC
    GAGCAGGAGC AGGAGGGCTG GTACAGGGCT CTCACCGACC TGCTCAACGA AGGCAAGGCG
    GCCTGCCAAG GGTCCCCCTA CCGCCACCTC GCCTCCCCCT TTTCCGCCTC CTGCGGCGCG
    GCCGCCGCCT CCCTGGCCGC CGCCGGCGAA GACCTTAACT ACGGGCTGAT CACGCCCGCC
    ACCGCTGCCT ACCGAGAGGT CTGGCAGGTG ACGCTGAAGC CCAAGGGCTT GGGGCAGAGT
    AAAAACCTCA CCGGCGTCCA CCGGCTCTGC CTCTCGGCCC GCACCATTGG GTTCGTGCGC
    CTCAATTGCG AGCTGCCCTC TGTCACGCTG CAGCTGATGA ACATCCGCCG CTGCGGCCAC
    TCCGACAGTT TCTTCTTCAT CGAGGTGGGG CGCTCGGCCG CCACCGGTCC CGGCGAGCTC
    TGGATGCAAG CGGACGACTC GGTGGTGGCC CAGAACATCC ACGAGACCAT CCTGGAGGCC
    ATGAAGGCGC TGAAGGAGCT GTCCGAGTTC CGGCCCCGCA GCAAGAGCCA GTCCTCTTCC
    TCCTCTTCCT CCGGCGGGGC CGGCGGGCCC GGCGGCAGCG GCGCCTCCGC CACCCACCCC
    ATCACCGTGC CCGGTCGCCG GCACCACCAC CTGGTCAACC TGCCTCCCAG CCAGACCGGC
    CTCCTCCGCC GTTCCCGCAC CGACAGCCTC GCCGCCGGCG CCGGCACCAA GTGCACGCCG
    TGCCGGGTGA GAACGGCCAG CGAGGGCGAC GGCTGCCGGG TGGGCTCTGC GGCCGGCAGC
    CCCATGAGCC CGGGCCCCGT GCGGACCCCC TTGAGCCGCT CGCACACGCT CAGCGGCGGC
    GGGGGGCGGC AGGCGGGGAA GCTGCTCCCG GTTCTGGCCG GCAGTGGCGG GCTGCAGAGC
    AGCCGTTCCA TGTCCATGCC CGCCTCCCAC TCGCCCCCCT CCGCCACCAG CCCCATCAGC
    CTCTCCTCCA GTAGCGGCCT CGGCTCCGAG ACTGCCCATC CGCATCACCC GCAGCGCCCG
    TCCAGCGGCA GCGCCTCCGT GTCCGGCTCC CCCAGCGACG CCGGCTTTAT GTCCTTCGAT
    GAGTACGGCT CCAGCCCAGG CGGCGACCTC CGGCCCTTCT CCTCCTCCTC CACTGCCAGC
    AATCGCAGCA ACACCCCCGA GTCGGTGGCC GAGACTCCCC CGGTGCGGGA CCCGGGGGGC
    GGCACCGACC TCTACGGCTA CATGGCGATG GAGCGGCCTC CGAGTGGCCG CCTCTGCTAC
    CGGCCCTGTC CCGACGCTGC CAGCGACAGG TGCCATCGGA AGCGGACCTA CTCCCTGACC
    ACGCCGTGCC GGCAGCGACC CGCCGCGCCG CAGGTTTCCT CCGCCTCCCT TGACGAGTAC
    ACGCTGATGC GCGCCACCTT CGCCGGCAGC GCCGGCCGCC TCTTCCCCTC CTGCCAAGCT
    GGGGCTTCCC CCAAAGTGAC CTACACCCCC TACCCCGAGG ACTACGGGGA CATCGAGATC
    GGTTCTCACC GCAGCTCCGG CAGCAGCAGC ACCAATCTGG GCCCGCCGGC AGTGGGGGGA
    GGAGGGGGAG ATGATGACGG CTACATGCCC ATGACCCCCG GTGTGGCCGC ATCCTTAGGG
    CAGGGAAGCC GGGGCAGCGA TGATTACATG CCCATGAGCC CCACCAGCGT GTCTGCCCCC
    AAGCAGATCC TGCAGCCCCG GGCAGGGGTG GGTAGTGGGT CCCCGGGGAA CGGGAGCAGC
    TACAAGACCA GCTCGCCTGG GGAGAGCTCC CCTGACGATA GCGGGTACAT GCGGATGTGG
    TGCGGCTCCA AGCTGTCAGT GGAGAGCTCA GATGGAAGGC TGAGTAACGG CGACTATATC
    AATATGTCCC CTCGAGACCC CCAGAACGGG CCCCACGCTC CCTCCCTCAC CCCCCCAGAC
    TTCTTTTTTG CCCCTTCAGA GCACGGGTCT AGTGAGCCCC CAAAGCCCAG CTGCTATTCA
    TACAGCTCCT TACCCCGCTC CTACAAGAGC CAGGGCTTGG CAAAGGACAG TGACCAGTAT
    GTGTTCATGA ACTCCCCGGG GAGGATGATC CCGGAGGAGG CGGTGTGTGG AGCGAGCCAG
    CTGCCTGCAG GCACCTTCGC CCCCTCCAGC CACACGGTGC CTTCGCCCCT GCGGCACAGC
    CGGACCGAGA GCTTCCTTAG CCAGCGGTGC CAGCGGGTGG CCCGGCCCAG CCGCCTTTCT
    TTGGAGACCT TGCGGACGAT GCTGCCCAGC ATGAACGAGC ACCCTCTGCC GCCTGAGCCC
    AAGAGCCCTG GTGAATACAT CAACATTGAC TTTGGGGATG CTGCTGTGTA TTCTCCCCCC
    TCGCTGCCTG CTGACAGCCC AGCCTCCTCC CTGGGCTCAG GCACGGGGCA GAGGCGCTCC
    CCTCTCTCCG ACTACATGAA CATTGACTTC GGGTCACAGT CACCCTCCCA GTCGGGCACG
    GTCTCAGTGG GCTCCTTGGA AGCTCTCTCT CCGGGTTCTT CCTCCAGCAC CAGCCAGCCC
    AACGGGTGCT ACCTGAAGGC GGCTGTGGGG GTTGCTTGTT CGTCCAGCCC ATCGGATGGC
    GGTGATTACA CCGAGATGAC CTTTGGCATG GCCACTACCC CACCTCAACC CATCGTTCAG
    AAACCAGAAA GTGCCCGGGT CACCAGCCCC ACATCTGGCG TGAAGAGGCT CACCCTTTCT
    GGGGTGGAGG CTTTCATTCT CTCCAGCCCT CCCCCAGACC CGAATCGGGG GGCGAAAGTA
    ATCCGGGCAG ATCCCCAGGG GCGGAGGAGG CACAGCTCAG AAACTTTCTC CTCCACCACC
    ACTGTGACCC CAGTGTCCCC CTCCTTCGCA CACAACCCCA AACGACACAA CTCGGCCTCG
    GTGGAGAACG TGTCCCTCAG GAAAAGCGAA GGCCTGGAGG AGGAGCAGGG TAGCAGTCCC
    ATGTGCCGGG AGACCTCGGC TGGCTTCCAG AATGGCCTCA ACTACATCGC CATTGATGTA
    GTGGATGGGT CCCAGGCAAA CTGTGACAAA TCCAGGTTGA AAGCTAGGCA CCTCCTGAAT
    GGGGGCATCA ATGGAGTAGA GATGAGCACC TATGCCAGCA TAGACTTCCT GTCTCACAAC
    CTGAAAGAAG CCAGTGCTGT GAAAGAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014104766.1
    CDS335..3844
    Translation

    Target ORF information:

    RefSeq Version XM_014249291.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis insulin receptor substrate 2 (IRS2), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014249291.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    ATGGCGAGCC CCGCTGTGCT GGGGCTGCTG CCCCCCCTGA GCTCCCCGCC CGGCCCCAAC 
    CTGAACAACA ACAATAACAA CAACCAGGGC GTCAGGAAGT GCGGGTACCT GCGCAAGCAG
    AAGCACGGCC ACAAGCGCTT CTTCGTGCTT CGCGGCCCGG GCGGCGGCGG GGAGGAGGCG
    GGGGGCGCCC GGCTGGAGTA CTACGAGAGC GAGAAGAAAT GGAGGAACAA GTCCGGGGCG
    CCCAAGCGGG TGATCTCCCT GGACTCCTGC CTCAACATCA ACAAGCGGGC GGACGCCAAG
    CACAAGTACC TCATCGCCCT CTACACCAAG GACGAGTACT TCGCTGTGGC TGCCGAGAAC
    GAGCAGGAGC AGGAGGGCTG GTACAGGGCT CTCACCGACC TGCTCAACGA AGGCAAGGCG
    GCCTGCCAAG GGTCCCCCTA CCGCCACCTC GCCTCCCCCT TTTCCGCCTC CTGCGGCGCG
    GCCGCCGCCT CCCTGGCCGC CGCCGGCGAA GACCTTAACT ACGGGCTGAT CACGCCCGCC
    ACCGCTGCCT ACCGAGAGGT CTGGCAGGTG ACGCTGAAGC CCAAGGGCTT GGGGCAGAGT
    AAAAACCTCA CCGGCGTCCA CCGGCTCTGC CTCTCGGCCC GCACCATTGG GTTCGTGCGC
    CTCAATTGCG AGCTGCCCTC TGTCACGCTG CAGCTGATGA ACATCCGCCG CTGCGGCCAC
    TCCGACAGTT TCTTCTTCAT CGAGGTGGGG CGCTCGGCCG CCACCGGTCC CGGCGAGCTC
    TGGATGCAAG CGGACGACTC GGTGGTGGCC CAGAACATCC ACGAGACCAT CCTGGAGGCC
    ATGAAGGCGC TGAAGGAGCT GTCCGAGTTC CGGCCCCGCA GCAAGAGCCA GTCCTCTTCC
    TCCTCTTCCT CCGGCGGGGC CGGCGGGCCC GGCGGCAGCG GCGCCTCCGC CACCCACCCC
    ATCACCGTGC CCGGTCGCCG GCACCACCAC CTGGTCAACC TGCCTCCCAG CCAGACCGGC
    CTCCTCCGCC GTTCCCGCAC CGACAGCCTC GCCGCCGGCG CCGGCACCAA GTGCACGCCG
    TGCCGGGTGA GAACGGCCAG CGAGGGCGAC GGCTGCCGGG TGGGCTCTGC GGCCGGCAGC
    CCCATGAGCC CGGGCCCCGT GCGGACCCCC TTGAGCCGCT CGCACACGCT CAGCGGCGGC
    GGGGGGCGGC AGGCGGGGAA GCTGCTCCCG GTTCTGGCCG GCAGTGGCGG GCTGCAGAGC
    AGCCGTTCCA TGTCCATGCC CGCCTCCCAC TCGCCCCCCT CCGCCACCAG CCCCATCAGC
    CTCTCCTCCA GTAGCGGCCT CGGCTCCGAG ACTGCCCATC CGCATCACCC GCAGCGCCCG
    TCCAGCGGCA GCGCCTCCGT GTCCGGCTCC CCCAGCGACG CCGGCTTTAT GTCCTTCGAT
    GAGTACGGCT CCAGCCCAGG CGGCGACCTC CGGCCCTTCT CCTCCTCCTC CACTGCCAGC
    AATCGCAGCA ACACCCCCGA GTCGGTGGCC GAGACTCCCC CGGTGCGGGA CCCGGGGGGC
    GGCACCGACC TCTACGGCTA CATGGCGATG GAGCGGCCTC CGAGTGGCCG CCTCTGCTAC
    CGGCCCTGTC CCGACGCTGC CAGCGACAGG TGCCATCGGA AGCGGACCTA CTCCCTGACC
    ACGCCGTGCC GGCAGCGACC CGCCGCGCCG CAGGTTTCCT CCGCCTCCCT TGACGAGTAC
    ACGCTGATGC GCGCCACCTT CGCCGGCAGC GCCGGCCGCC TCTTCCCCTC CTGCCAAGCT
    GGGGCTTCCC CCAAAGTGAC CTACACCCCC TACCCCGAGG ACTACGGGGA CATCGAGATC
    GGTTCTCACC GCAGCTCCGG CAGCAGCAGC ACCAATCTGG GCCCGCCGGC AGTGGGGGGA
    GGAGGGGGAG ATGATGACGG CTACATGCCC ATGACCCCCG GTGTGGCCGC ATCCTTAGGG
    CAGGGAAGCC GGGGCAGCGA TGATTACATG CCCATGAGCC CCACCAGCGT GTCTGCCCCC
    AAGCAGATCC TGCAGCCCCG GGCAGGGGTG GGTAGTGGGT CCCCGGGGAA CGGGAGCAGC
    TACAAGACCA GCTCGCCTGG GGAGAGCTCC CCTGACGATA GCGGGTACAT GCGGATGTGG
    TGCGGCTCCA AGCTGTCAGT GGAGAGCTCA GATGGAAGGC TGAGTAACGG CGACTATATC
    AATATGTCCC CTCGAGACCC CCAGAACGGG CCCCACGCTC CCTCCCTCAC CCCCCCAGAC
    TTCTTTTTTG CCCCTTCAGA GCACGGGTCT AGTGAGCCCC CAAAGCCCAG CTGCTATTCA
    TACAGCTCCT TACCCCGCTC CTACAAGAGC CAGGGCTTGG CAAAGGACAG TGACCAGTAT
    GTGTTCATGA ACTCCCCGGG GAGGATGATC CCGGAGGAGG CGGTGTGTGG AGCGAGCCAG
    CTGCCTGCAG GCACCTTCGC CCCCTCCAGC CACACGGTGC CTTCGCCCCT GCGGCACAGC
    CGGACCGAGA GCTTCCTTAG CCAGCGGTGC CAGCGGGTGG CCCGGCCCAG CCGCCTTTCT
    TTGGAGACCT TGCGGACGAT GCTGCCCAGC ATGAACGAGC ACCCTCTGCC GCCTGAGCCC
    AAGAGCCCTG GTGAATACAT CAACATTGAC TTTGGGGATG CTGCTGTGTA TTCTCCCCCC
    TCGCTGCCTG CTGACAGCCC AGCCTCCTCC CTGGGCTCAG GCACGGGGCA GAGGCGCTCC
    CCTCTCTCCG ACTACATGAA CATTGACTTC GGGTCACAGT CACCCTCCCA GTCGGGCACG
    GTCTCAGTGG GCTCCTTGGA AGCTCTCTCT CCGGGTTCTT CCTCCAGCAC CAGCCAGCCC
    AACGGGTGCT ACCTGAAGGC GGCTGTGGGG GTTGCTTGTT CGTCCAGCCC ATCGGATGGC
    GGTGATTACA CCGAGATGAC CTTTGGCATG GCCACTACCC CACCTCAACC CATCGTTCAG
    AAACCAGAAA GTGCCCGGGT CACCAGCCCC ACATCTGGCG TGAAGAGGCT CACCCTTTCT
    GGGGTGGAGG CTTTCATTCT CTCCAGCCCT CCCCCAGACC CGAATCGGGG GGCGAAAGTA
    ATCCGGGCAG ATCCCCAGGG GCGGAGGAGG CACAGCTCAG AAACTTTCTC CTCCACCACC
    ACTGTGACCC CAGTGTCCCC CTCCTTCGCA CACAACCCCA AACGACACAA CTCGGCCTCG
    GTGGAGAACG TGTCCCTCAG GAAAAGCGAA GGCCTGGAGG AGGAGCAGGG TAGCAGTCCC
    ATGTGCCGGG AGACCTCGGC TGGCTTCCAG AATGGCCTCA ACTACATCGC CATTGATGTA
    GTGGATGGGT CCCAGGCAAA CTGTGACAAA TCCAGGTTGA AAGCTAGGCA CCTCCTGAAT
    GGGGGCATCA ATGGAGTAGA GATGAGCACC TATGCCAGCA TAGACTTCCT GTCTCACAAC
    CTGAAAGAAG CCAGTGCTGT GAAAGAGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.