AP5Z1 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

The following AP5Z1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the AP5Z1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs13695 XM_014252495.1
Latest version!
Pseudopodoces humilis adaptor-related protein complex 5, zeta 1 subunit (AP5Z1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00
OPs13696 XM_014252496.1
Latest version!
Pseudopodoces humilis adaptor-related protein complex 5, zeta 1 subunit (AP5Z1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs13695
    Clone ID Related Accession (Same CDS sequence) XM_014252495.1
    Accession Version XM_014252495.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2427bp)
    Protein sequence
    SNP
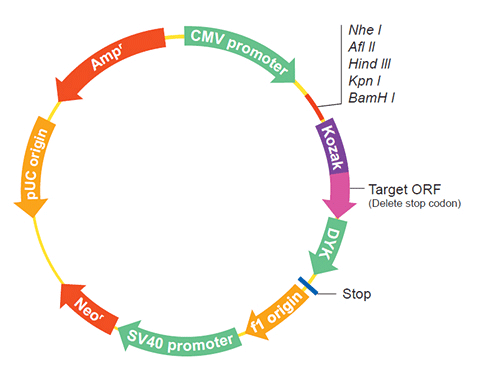
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product AP-5 complex subunit zeta-1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087569.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    ATGTTCACGG CGGCTGCCGA GAGCTTCCTC AGGCAGGCGA GGGAGATCCA GGACGAGGAG 
    CTGCGGAGAT TCGCCGCCCG TGTGTCCGCC CTGCTGCAGG GCCCCGAGCC GGGCCCCGAG
    GCCGTGGATG GGCTGCAGAG GCTGCACCTC ACCGTGGCCG CCACCAAGTA CCCCCGCAAG
    CTTGATGGCA AGTTTGTGGA GCTGTTGCAG ACAGTGCTGT GCTTACCCAA AAGTCCTGAG
    CAGATCCAGG TGTTATGTGC TGCCATCCTG AGAGAGATGT CACCTTGCCA TGATCTTATC
    CTCTCCTGTG ATGAGATTCA AGATACAAAG CTCTTGAGCC TGGTATCCTC CGTCCTTCTG
    GCTCAGGAAA GTAAGGGTGA AATGGCAGCT GTGGGGCAGC GTGTTGTGAA AGTCCTTGAA
    AGAAGACTGC CTGAGGGTCA GAGTGCTCGG TTCCTTCTTC CTGTCCTGGC AAATGTCATC
    AGCCTTTCAC CAGAATCTCT AACAGAAGAG CAGACCAATG TTGTCAGTAA AAAAATGGCT
    GACTGGCTGA GGTATGCAAG CATTCAGCAA GGAATGGCTC AGCCCTCTGG AGGCTTCTTC
    TCCAGTCCCA GAACCAAACA GCCTGCTCCT ATCACAGAGG TGGACGGTGC TGTTGCCACA
    GACTTCTTCA CAGTGCTCTC AGTGGCTCAG CACTACACAC AGGACCAGTG GCTCAACGTG
    CAGACCTTCT CCATGCTGAG AAACTGGCTG CTGTGCTATG GGGGCAAGGA GCTGAGCACC
    CTTAATTCAG ATGACAAAGC AGGAGTGGAC AGGTGTGTGA CATCCCTGGT CTCCACAACA
    GCCACGGCTG GGCGGCTGCT TCCCCCCAGG GAGCGTCTGC GGGACAAAGC CTTCGAGTAC
    TGCCAGCGTC TCATCGAGCA GAGCAACCGG CGACCCCTGA AGAAAGAAGA TGGAGACCTG
    CAAAAAGCTT GTCTCATTGA GGCAGTGACA ATCATGGACA TCATCTGCAA ACAGGACTCC
    TCCTATGTGT GCCGTGCTGT CTCCTTCCTG AAAATCCTGC ACAGCAGGAT CTGTGGGGAT
    GCCACTTATG CCAGGGCCCT GCTTCCCATT GCCCAGTTCT TCCTGAACCA CAGCAAACTG
    GCAGCTGTGG ACTCAGATGC CATCTACAAA CACCTCTTCA CTGATATCCC AGCTCAGCTC
    TTCCACAACC CATCACTGGC CTTCGAATTT GTCCAGTTCT GCAAAGACAA CAGCCAGCTC
    CTCACAGACT TCTCCAGCAT ATTCAGGCAG AGCTTCCCAA ATCTCTTCAA GTTCCTGGCG
    TGGAACAGCC CACCTCTGAT CTCTGAGTTT GTGGACCTTC TCCCATTTCT GCTGGATCCA
    GGCACAACCA TTGAGATCTT GCATTTGCTG CTTGACCTGC CCTGTTTGAC AGCAGCTCTG
    GACATCCAGC AGAGGGCAGC TGCTCTTCCT GCCTCTGAGA AGGCTGGGGG TGACCCAGCT
    GGGAAGCCAG CCACGTGTCT GGAGGCCTTT CGCCATCCCC TCTACAAGAG CATGTTCCAG
    TATCTCCTCC GCACCAAGTC TGCTCCCCAG GATGCCCCCG AGAGTCTGGT TCCACTTCGG
    CAGCTGCTGG GATCCCTGGC TGGCAGCCCA AGGGTGGTGC AGTGTGCAGA GGCTGTCCCT
    GTCTTACTGG AGCTCTTTTT CAGGGTGGTG GCAGAGTTTG CAGATGAGTC TCTGATAAAC
    CAGCTGGTGG TGCTGCTGCT GCAGAGGAGT GACCAGCTCT ATGAGATCCC AGCGTTTAAA
    GAAGATGTGT ACAGGGTGCT GGGCTCCCAG CTGGCAATGC TCTGCAGGCT GCGCCCTGCA
    CTTGTGGTGG AACTGTCCAC GGAGATCCTG GAGTTCTCTG GAGCTGTCAG CAACATCCAG
    AGCAAGGAGG CCATCTTCAC CCACATGGTG TGGGCTATCG GTGAGTACCT GTCGGTGTCC
    TACGACAAGC GCTGCACAGT GGAGCAGATC ACGCGCTTCT TCGAGACCCT CGAGGCTGTG
    CTCTTTGAGA TCACCCAGCT CCGGCCACAG GCCAGCACCC CCAGCTGTGC CCCTCGTGCC
    ATCAGTGTCC TCATGGCCAC CTTGACCAAG CTGGCAGCCC GCAGCCAGGA CTTGATCCCC
    AGAGTGTCCA TGTTCCTGTC CAAGATGAGG ACATTTGTGC AGAGCCCTGC TGTCACCTCT
    GTTTACTGCG AGGAAGACCT TGAGGAGATC CTCATTCGAG CAACTGAGCT CATGAACCTG
    CTGAAAATGC CCAGCGTGGC TCAGTTTGTG TTCACCCCCC CCATGGCCAG CACACAGTTT
    CAGAGGGACG TGAATGACTC TCTCCCTTTG GCCCTGAGGA TGGTCACCCA GCTCCTGGAG
    CCTGCTCCAG GCTCCATGCC AGTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107970.1
    CDS42..2468
    Translation

    Target ORF information:

    RefSeq Version XM_014252495.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis adaptor-related protein complex 5, zeta 1 subunit (AP5Z1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014252495.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    ATGTTCACGG CGGCTGCCGA GAGCTTCCTC AGGCAGGCGA GGGAGATCCA GGACGAGGAG 
    CTGCGGAGAT TCGCCGCCCG TGTGTCCGCC CTGCTGCAGG GCCCCGAGCC GGGCCCCGAG
    GCCGTGGATG GGCTGCAGAG GCTGCACCTC ACCGTGGCCG CCACCAAGTA CCCCCGCAAG
    CTTGATGGCA AGTTTGTGGA GCTGTTGCAG ACAGTGCTGT GCTTACCCAA AAGTCCTGAG
    CAGATCCAGG TGTTATGTGC TGCCATCCTG AGAGAGATGT CACCTTGCCA TGATCTTATC
    CTCTCCTGTG ATGAGATTCA AGATACAAAG CTCTTGAGCC TGGTATCCTC CGTCCTTCTG
    GCTCAGGAAA GTAAGGGTGA AATGGCAGCT GTGGGGCAGC GTGTTGTGAA AGTCCTTGAA
    AGAAGACTGC CTGAGGGTCA GAGTGCTCGG TTCCTTCTTC CTGTCCTGGC AAATGTCATC
    AGCCTTTCAC CAGAATCTCT AACAGAAGAG CAGACCAATG TTGTCAGTAA AAAAATGGCT
    GACTGGCTGA GGTATGCAAG CATTCAGCAA GGAATGGCTC AGCCCTCTGG AGGCTTCTTC
    TCCAGTCCCA GAACCAAACA GCCTGCTCCT ATCACAGAGG TGGACGGTGC TGTTGCCACA
    GACTTCTTCA CAGTGCTCTC AGTGGCTCAG CACTACACAC AGGACCAGTG GCTCAACGTG
    CAGACCTTCT CCATGCTGAG AAACTGGCTG CTGTGCTATG GGGGCAAGGA GCTGAGCACC
    CTTAATTCAG ATGACAAAGC AGGAGTGGAC AGGTGTGTGA CATCCCTGGT CTCCACAACA
    GCCACGGCTG GGCGGCTGCT TCCCCCCAGG GAGCGTCTGC GGGACAAAGC CTTCGAGTAC
    TGCCAGCGTC TCATCGAGCA GAGCAACCGG CGACCCCTGA AGAAAGAAGA TGGAGACCTG
    CAAAAAGCTT GTCTCATTGA GGCAGTGACA ATCATGGACA TCATCTGCAA ACAGGACTCC
    TCCTATGTGT GCCGTGCTGT CTCCTTCCTG AAAATCCTGC ACAGCAGGAT CTGTGGGGAT
    GCCACTTATG CCAGGGCCCT GCTTCCCATT GCCCAGTTCT TCCTGAACCA CAGCAAACTG
    GCAGCTGTGG ACTCAGATGC CATCTACAAA CACCTCTTCA CTGATATCCC AGCTCAGCTC
    TTCCACAACC CATCACTGGC CTTCGAATTT GTCCAGTTCT GCAAAGACAA CAGCCAGCTC
    CTCACAGACT TCTCCAGCAT ATTCAGGCAG AGCTTCCCAA ATCTCTTCAA GTTCCTGGCG
    TGGAACAGCC CACCTCTGAT CTCTGAGTTT GTGGACCTTC TCCCATTTCT GCTGGATCCA
    GGCACAACCA TTGAGATCTT GCATTTGCTG CTTGACCTGC CCTGTTTGAC AGCAGCTCTG
    GACATCCAGC AGAGGGCAGC TGCTCTTCCT GCCTCTGAGA AGGCTGGGGG TGACCCAGCT
    GGGAAGCCAG CCACGTGTCT GGAGGCCTTT CGCCATCCCC TCTACAAGAG CATGTTCCAG
    TATCTCCTCC GCACCAAGTC TGCTCCCCAG GATGCCCCCG AGAGTCTGGT TCCACTTCGG
    CAGCTGCTGG GATCCCTGGC TGGCAGCCCA AGGGTGGTGC AGTGTGCAGA GGCTGTCCCT
    GTCTTACTGG AGCTCTTTTT CAGGGTGGTG GCAGAGTTTG CAGATGAGTC TCTGATAAAC
    CAGCTGGTGG TGCTGCTGCT GCAGAGGAGT GACCAGCTCT ATGAGATCCC AGCGTTTAAA
    GAAGATGTGT ACAGGGTGCT GGGCTCCCAG CTGGCAATGC TCTGCAGGCT GCGCCCTGCA
    CTTGTGGTGG AACTGTCCAC GGAGATCCTG GAGTTCTCTG GAGCTGTCAG CAACATCCAG
    AGCAAGGAGG CCATCTTCAC CCACATGGTG TGGGCTATCG GTGAGTACCT GTCGGTGTCC
    TACGACAAGC GCTGCACAGT GGAGCAGATC ACGCGCTTCT TCGAGACCCT CGAGGCTGTG
    CTCTTTGAGA TCACCCAGCT CCGGCCACAG GCCAGCACCC CCAGCTGTGC CCCTCGTGCC
    ATCAGTGTCC TCATGGCCAC CTTGACCAAG CTGGCAGCCC GCAGCCAGGA CTTGATCCCC
    AGAGTGTCCA TGTTCCTGTC CAAGATGAGG ACATTTGTGC AGAGCCCTGC TGTCACCTCT
    GTTTACTGCG AGGAAGACCT TGAGGAGATC CTCATTCGAG CAACTGAGCT CATGAACCTG
    CTGAAAATGC CCAGCGTGGC TCAGTTTGTG TTCACCCCCC CCATGGCCAG CACACAGTTT
    CAGAGGGACG TGAATGACTC TCTCCCTTTG GCCCTGAGGA TGGTCACCCA GCTCCTGGAG
    CCTGCTCCAG GCTCCATGCC AGTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs13696
    Clone ID Related Accession (Same CDS sequence) XM_014252496.1
    Accession Version XM_014252496.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2289bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product AP-5 complex subunit zeta-1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087569.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGTTCACGG CGGCTGCCGA GAGCTTCCTC AGGCAGGCGA GGCTTGATGG CAAGTTTGTG 
    GAGCTGTTGC AGACAGTGCT GTGCTTACCC AAAAGTCCTG AGCAGATCCA GGTGTTATGT
    GCTGCCATCC TGAGAGAGAT GTCACCTTGC CATGATCTTA TCCTCTCCTG TGATGAGATT
    CAAGATACAA AGCTCTTGAG CCTGGTATCC TCCGTCCTTC TGGCTCAGGA AAGTAAGGGT
    GAAATGGCAG CTGTGGGGCA GCGTGTTGTG AAAGTCCTTG AAAGAAGACT GCCTGAGGGT
    CAGAGTGCTC GGTTCCTTCT TCCTGTCCTG GCAAATGTCA TCAGCCTTTC ACCAGAATCT
    CTAACAGAAG AGCAGACCAA TGTTGTCAGT AAAAAAATGG CTGACTGGCT GAGGTATGCA
    AGCATTCAGC AAGGAATGGC TCAGCCCTCT GGAGGCTTCT TCTCCAGTCC CAGAACCAAA
    CAGCCTGCTC CTATCACAGA GGTGGACGGT GCTGTTGCCA CAGACTTCTT CACAGTGCTC
    TCAGTGGCTC AGCACTACAC ACAGGACCAG TGGCTCAACG TGCAGACCTT CTCCATGCTG
    AGAAACTGGC TGCTGTGCTA TGGGGGCAAG GAGCTGAGCA CCCTTAATTC AGATGACAAA
    GCAGGAGTGG ACAGGTGTGT GACATCCCTG GTCTCCACAA CAGCCACGGC TGGGCGGCTG
    CTTCCCCCCA GGGAGCGTCT GCGGGACAAA GCCTTCGAGT ACTGCCAGCG TCTCATCGAG
    CAGAGCAACC GGCGACCCCT GAAGAAAGAA GATGGAGACC TGCAAAAAGC TTGTCTCATT
    GAGGCAGTGA CAATCATGGA CATCATCTGC AAACAGGACT CCTCCTATGT GTGCCGTGCT
    GTCTCCTTCC TGAAAATCCT GCACAGCAGG ATCTGTGGGG ATGCCACTTA TGCCAGGGCC
    CTGCTTCCCA TTGCCCAGTT CTTCCTGAAC CACAGCAAAC TGGCAGCTGT GGACTCAGAT
    GCCATCTACA AACACCTCTT CACTGATATC CCAGCTCAGC TCTTCCACAA CCCATCACTG
    GCCTTCGAAT TTGTCCAGTT CTGCAAAGAC AACAGCCAGC TCCTCACAGA CTTCTCCAGC
    ATATTCAGGC AGAGCTTCCC AAATCTCTTC AAGTTCCTGG CGTGGAACAG CCCACCTCTG
    ATCTCTGAGT TTGTGGACCT TCTCCCATTT CTGCTGGATC CAGGCACAAC CATTGAGATC
    TTGCATTTGC TGCTTGACCT GCCCTGTTTG ACAGCAGCTC TGGACATCCA GCAGAGGGCA
    GCTGCTCTTC CTGCCTCTGA GAAGGCTGGG GGTGACCCAG CTGGGAAGCC AGCCACGTGT
    CTGGAGGCCT TTCGCCATCC CCTCTACAAG AGCATGTTCC AGTATCTCCT CCGCACCAAG
    TCTGCTCCCC AGGATGCCCC CGAGAGTCTG GTTCCACTTC GGCAGCTGCT GGGATCCCTG
    GCTGGCAGCC CAAGGGTGGT GCAGTGTGCA GAGGCTGTCC CTGTCTTACT GGAGCTCTTT
    TTCAGGGTGG TGGCAGAGTT TGCAGATGAG TCTCTGATAA ACCAGCTGGT GGTGCTGCTG
    CTGCAGAGGA GTGACCAGCT CTATGAGATC CCAGCGTTTA AAGAAGATGT GTACAGGGTG
    CTGGGCTCCC AGCTGGCAAT GCTCTGCAGG CTGCGCCCTG CACTTGTGGT GGAACTGTCC
    ACGGAGATCC TGGAGTTCTC TGGAGCTGTC AGCAACATCC AGAGCAAGGA GGCCATCTTC
    ACCCACATGG TGTGGGCTAT CGGTGAGTAC CTGTCGGTGT CCTACGACAA GCGCTGCACA
    GTGGAGCAGA TCACGCGCTT CTTCGAGACC CTCGAGGCTG TGCTCTTTGA GATCACCCAG
    CTCCGGCCAC AGGCCAGCAC CCCCAGCTGT GCCCCTCGTG CCATCAGTGT CCTCATGGCC
    ACCTTGACCA AGCTGGCAGC CCGCAGCCAG GACTTGATCC CCAGAGTGTC CATGTTCCTG
    TCCAAGATGA GGACATTTGT GCAGAGCCCT GCTGTCACCT CTGTTTACTG CGAGGAAGAC
    CTTGAGGAGA TCCTCATTCG AGCAACTGAG CTCATGAACC TGCTGAAAAT GCCCAGCGTG
    GCTCAGTTTG TGTTCACCCC CCCCATGGCC AGCACACAGT TTCAGAGGGA CGTGAATGAC
    TCTCTCCCTT TGGCCCTGAG GATGGTCACC CAGCTCCTGG AGCCTGCTCC AGGCTCCATG
    CCAGTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107971.1
    CDS5..2293
    Translation

    Target ORF information:

    RefSeq Version XM_014252496.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis adaptor-related protein complex 5, zeta 1 subunit (AP5Z1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014252496.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    ATGTTCACGG CGGCTGCCGA GAGCTTCCTC AGGCAGGCGA GGCTTGATGG CAAGTTTGTG 
    GAGCTGTTGC AGACAGTGCT GTGCTTACCC AAAAGTCCTG AGCAGATCCA GGTGTTATGT
    GCTGCCATCC TGAGAGAGAT GTCACCTTGC CATGATCTTA TCCTCTCCTG TGATGAGATT
    CAAGATACAA AGCTCTTGAG CCTGGTATCC TCCGTCCTTC TGGCTCAGGA AAGTAAGGGT
    GAAATGGCAG CTGTGGGGCA GCGTGTTGTG AAAGTCCTTG AAAGAAGACT GCCTGAGGGT
    CAGAGTGCTC GGTTCCTTCT TCCTGTCCTG GCAAATGTCA TCAGCCTTTC ACCAGAATCT
    CTAACAGAAG AGCAGACCAA TGTTGTCAGT AAAAAAATGG CTGACTGGCT GAGGTATGCA
    AGCATTCAGC AAGGAATGGC TCAGCCCTCT GGAGGCTTCT TCTCCAGTCC CAGAACCAAA
    CAGCCTGCTC CTATCACAGA GGTGGACGGT GCTGTTGCCA CAGACTTCTT CACAGTGCTC
    TCAGTGGCTC AGCACTACAC ACAGGACCAG TGGCTCAACG TGCAGACCTT CTCCATGCTG
    AGAAACTGGC TGCTGTGCTA TGGGGGCAAG GAGCTGAGCA CCCTTAATTC AGATGACAAA
    GCAGGAGTGG ACAGGTGTGT GACATCCCTG GTCTCCACAA CAGCCACGGC TGGGCGGCTG
    CTTCCCCCCA GGGAGCGTCT GCGGGACAAA GCCTTCGAGT ACTGCCAGCG TCTCATCGAG
    CAGAGCAACC GGCGACCCCT GAAGAAAGAA GATGGAGACC TGCAAAAAGC TTGTCTCATT
    GAGGCAGTGA CAATCATGGA CATCATCTGC AAACAGGACT CCTCCTATGT GTGCCGTGCT
    GTCTCCTTCC TGAAAATCCT GCACAGCAGG ATCTGTGGGG ATGCCACTTA TGCCAGGGCC
    CTGCTTCCCA TTGCCCAGTT CTTCCTGAAC CACAGCAAAC TGGCAGCTGT GGACTCAGAT
    GCCATCTACA AACACCTCTT CACTGATATC CCAGCTCAGC TCTTCCACAA CCCATCACTG
    GCCTTCGAAT TTGTCCAGTT CTGCAAAGAC AACAGCCAGC TCCTCACAGA CTTCTCCAGC
    ATATTCAGGC AGAGCTTCCC AAATCTCTTC AAGTTCCTGG CGTGGAACAG CCCACCTCTG
    ATCTCTGAGT TTGTGGACCT TCTCCCATTT CTGCTGGATC CAGGCACAAC CATTGAGATC
    TTGCATTTGC TGCTTGACCT GCCCTGTTTG ACAGCAGCTC TGGACATCCA GCAGAGGGCA
    GCTGCTCTTC CTGCCTCTGA GAAGGCTGGG GGTGACCCAG CTGGGAAGCC AGCCACGTGT
    CTGGAGGCCT TTCGCCATCC CCTCTACAAG AGCATGTTCC AGTATCTCCT CCGCACCAAG
    TCTGCTCCCC AGGATGCCCC CGAGAGTCTG GTTCCACTTC GGCAGCTGCT GGGATCCCTG
    GCTGGCAGCC CAAGGGTGGT GCAGTGTGCA GAGGCTGTCC CTGTCTTACT GGAGCTCTTT
    TTCAGGGTGG TGGCAGAGTT TGCAGATGAG TCTCTGATAA ACCAGCTGGT GGTGCTGCTG
    CTGCAGAGGA GTGACCAGCT CTATGAGATC CCAGCGTTTA AAGAAGATGT GTACAGGGTG
    CTGGGCTCCC AGCTGGCAAT GCTCTGCAGG CTGCGCCCTG CACTTGTGGT GGAACTGTCC
    ACGGAGATCC TGGAGTTCTC TGGAGCTGTC AGCAACATCC AGAGCAAGGA GGCCATCTTC
    ACCCACATGG TGTGGGCTAT CGGTGAGTAC CTGTCGGTGT CCTACGACAA GCGCTGCACA
    GTGGAGCAGA TCACGCGCTT CTTCGAGACC CTCGAGGCTG TGCTCTTTGA GATCACCCAG
    CTCCGGCCAC AGGCCAGCAC CCCCAGCTGT GCCCCTCGTG CCATCAGTGT CCTCATGGCC
    ACCTTGACCA AGCTGGCAGC CCGCAGCCAG GACTTGATCC CCAGAGTGTC CATGTTCCTG
    TCCAAGATGA GGACATTTGT GCAGAGCCCT GCTGTCACCT CTGTTTACTG CGAGGAAGAC
    CTTGAGGAGA TCCTCATTCG AGCAACTGAG CTCATGAACC TGCTGAAAAT GCCCAGCGTG
    GCTCAGTTTG TGTTCACCCC CCCCATGGCC AGCACACAGT TTCAGAGGGA CGTGAATGAC
    TCTCTCCCTT TGGCCCTGAG GATGGTCACC CAGCTCCTGG AGCCTGCTCC AGGCTCCATG
    CCAGTGTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.