KAT2A cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

The following KAT2A gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the KAT2A cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs24701 XM_005531459.2
Latest version!
Pseudopodoces humilis K(lysine) acetyltransferase 2A (KAT2A), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs24701
    Clone ID Related Accession (Same CDS sequence) XM_005531459.2
    Accession Version XM_005531459.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2391bp)
    Protein sequence
    SNP
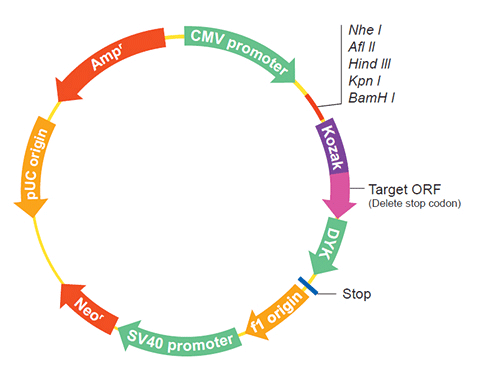
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product histone acetyltransferase KAT2A
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087648.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 21, 2015 this sequence version replaced XM_005531459.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    ATGGCGGAGC CGGAGGCCTC GCAGCCCGGG CGGCCCCCGC CGGGCCCGGG GACGGGAACG 
    GCGGGGGCGA GCGGGGGAAC GGCCGGAGGA GCGGGATCCA GCGACCCGGC ACGGCCCGGG
    CTGAGCCAGC AGCAGCGGGC GAGTCAGCGC AAGGCGCAGG TGCGGGGGTT CCCCCGCGGG
    AAGAAGCTGG AGAAGCTGGG GGTCTTCTCG GCCTGCAAGG CCAACGACGC TTGCAAATGC
    AATGGCTGGA AGAACCCAAA CCCCCCCACA GCCCCTCGAA TGGACCTGCA GCAGCCGGTG
    ACCAACCTGA GCGAAGCGTG CCGGAGCTGT GGCCATGCCC TGGCGGATCA TGTGTCCCAC
    CTGGAGAACG TCTCGGAGGA AGAGATCAAC CGTCTGCTGG GCATGGTGGT GGACGTGGAG
    AACCTGTTCA TGTCAGTGCA CAAGGAGGAG GACACGGACA CCAAGCAGGT GTATTTCTAC
    CTGTTCAAGC TGCTGCGGAA GTGCATCCTG CAGATGAGCC AGCCTGTGGT CGAGGGGTCC
    CTGGGGAGCC CCCCCTTTGA AAAACCAAAC ATTGAGCAGG GAGTCCTGAA TTTTGTGCAG
    TACAAGTTCA GCCACTTGCC ACCCAAGGAG CGCCAGACCA TGTATGAGCT CTCCAAGATG
    TTCCTGCTGT GCCTCAACTA CTGGAAGCTG GAGACACCGT CCCAGTTCCG TCAGCGCTCC
    CAGAACGACG ATGTGGCCAC CTACAAGGTC AACTACACCA GGTGGCTGTG CTACTGCCAT
    GTGCCACAGA GCTGTGACAG CCTGCCCCGC TATGAGACCA CCCACGTCTT TGGGCGCAGC
    CTCCTCAAGT CCATCTTCAC GGTGACCCGC CGGCAGCTGC TGGAGAAGTT CCGGGTGGAG
    AAGGACAAGC TGGTGCCGGA GAAGCGGACA CTGATCCTCA CCCACTTTCC CAAGTTCCTC
    TCCATGCTGG AGGAGGAGAT CTACGGTGAG AACTCTCCAA TCTGGGAGGC TGATTTCACA
    GTGCCAGCTA CAGAGGGTGC CCAGCTGGTG TCTCGCCCAG CTGTGGTGAG CACCGTTGCC
    GTGCCCACCA CTCCTCTCTT CAGCAAGAAG CTCAGCAGCA GCAGCTCAGC TGCCAGCCTG
    GACTCCAGCA CCCCAGAGCC CCTGCCAGGA GAGAAGCGGA AGCTACCTGA GAGCCTGACG
    CTGGAGGATG CCAAGCGGAT CCGTGTCATG GGAGACATCC CCATGGAGCT GGTGAACGAG
    GTCATGCTAA CCATCACGGA CCCTGCTGCC ATGCTGGGCC CCGAGACCAG CCTGCTGTCG
    GCCAACGCGG CGCGGGATGA GACGGCGCGG CTGGAGGAGC GCCGCGGCAT CATCGAGTTC
    CACGTCATCG GCAACTCGCT CTCACAGAAA TCCAACAAGA AGATCCTGAT GTGGCTGGTG
    GGGCTGCAGA ATGTCTTCTC ACACCAGCTG CCCCGCATGC CCAAGGAGTA CATCACTCGC
    CTCGTCTTTG ACCCGAAGCA CAAGACCCTG GCACTGATCA AGGACGGACG AGTGATCGGG
    GGCATCTGCT TCCGCATGTT CCCTACCCAA GGTTTCACGG AGATTGTGTT CTGTGCTGTC
    ACCTCCAATG AGCAAGTGAA GGGCTATGGG ACGCACCTGA TGAACCACCT GAAGGAGTAC
    CACATCAAGC ACAACATCCT CTACTTCCTC ACCTATGCAG ATGAGTACGC CATTGGCTAC
    TTCAAAAAGC AGGGCTTTTC TAAGGACATC AAGGTCCCCA AGAGCCGCTA CCTGGGATAC
    ATCAAGGACT ACGAGGGGGC GACCCTGATG GAGTGTGAGC TGAACCCCCG CATCCCCTAC
    ACTGAGCTTT CACACATCAT CAAGAAGCAG AAGGAGATCA TCAAGAAGTT GATCGAGAGG
    AAACAGGCCC AGATCCGCAA AGTCTATCCA GGCCTGACCT GCTTCAAGGA GGGCGTGAGG
    CAGATCCCCA TCGAGAGCGT CCCTGGCATC CGAGAAACAG GATGGAAACC ACTGGGGAAG
    GAGAAGGGGA AGGAGCTGAA GGACCCAGAC CAGCTCTACA ACATGCTGAA GAACCTCCTG
    GCCCAGATCA AGACCCACCC CAGTGCGTGG CCCTTCATGG AGCCGGTGAA GAAGTCAGAG
    GCACCAGACT ACTATGAAAT CATCCGCTTC CCCATTGACC TGAAGACCAT GACGGAGCGC
    CTGAAGAACC GCTACTACGT CACCAAGAAG CTGTTCATCG CCGACCTGCA GCGCATCATC
    ACCAACTGCC GCGAGTACAA CCCGCCTGAC AGCGACTACT GCAAGTGTGC CAACACCCTC
    GAGAAGTTCT TCTACTTCAA GCTCAAGGAA GGGGGGCTCA TCGACAAGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_005531516.1
    CDS23..2413
    Translation

    Target ORF information:

    RefSeq Version XM_005531459.2
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis K(lysine) acetyltransferase 2A (KAT2A), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_005531459.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    ATGGCGGAGC CGGAGGCCTC GCAGCCCGGG CGGCCCCCGC CGGGCCCGGG GACGGGAACG 
    GCGGGGGCGA GCGGGGGAAC GGCCGGAGGA GCGGGATCCA GCGACCCGGC ACGGCCCGGG
    CTGAGCCAGC AGCAGCGGGC GAGTCAGCGC AAGGCGCAGG TGCGGGGGTT CCCCCGCGGG
    AAGAAGCTGG AGAAGCTGGG GGTCTTCTCG GCCTGCAAGG CCAACGACGC TTGCAAATGC
    AATGGCTGGA AGAACCCAAA CCCCCCCACA GCCCCTCGAA TGGACCTGCA GCAGCCGGTG
    ACCAACCTGA GCGAAGCGTG CCGGAGCTGT GGCCATGCCC TGGCGGATCA TGTGTCCCAC
    CTGGAGAACG TCTCGGAGGA AGAGATCAAC CGTCTGCTGG GCATGGTGGT GGACGTGGAG
    AACCTGTTCA TGTCAGTGCA CAAGGAGGAG GACACGGACA CCAAGCAGGT GTATTTCTAC
    CTGTTCAAGC TGCTGCGGAA GTGCATCCTG CAGATGAGCC AGCCTGTGGT CGAGGGGTCC
    CTGGGGAGCC CCCCCTTTGA AAAACCAAAC ATTGAGCAGG GAGTCCTGAA TTTTGTGCAG
    TACAAGTTCA GCCACTTGCC ACCCAAGGAG CGCCAGACCA TGTATGAGCT CTCCAAGATG
    TTCCTGCTGT GCCTCAACTA CTGGAAGCTG GAGACACCGT CCCAGTTCCG TCAGCGCTCC
    CAGAACGACG ATGTGGCCAC CTACAAGGTC AACTACACCA GGTGGCTGTG CTACTGCCAT
    GTGCCACAGA GCTGTGACAG CCTGCCCCGC TATGAGACCA CCCACGTCTT TGGGCGCAGC
    CTCCTCAAGT CCATCTTCAC GGTGACCCGC CGGCAGCTGC TGGAGAAGTT CCGGGTGGAG
    AAGGACAAGC TGGTGCCGGA GAAGCGGACA CTGATCCTCA CCCACTTTCC CAAGTTCCTC
    TCCATGCTGG AGGAGGAGAT CTACGGTGAG AACTCTCCAA TCTGGGAGGC TGATTTCACA
    GTGCCAGCTA CAGAGGGTGC CCAGCTGGTG TCTCGCCCAG CTGTGGTGAG CACCGTTGCC
    GTGCCCACCA CTCCTCTCTT CAGCAAGAAG CTCAGCAGCA GCAGCTCAGC TGCCAGCCTG
    GACTCCAGCA CCCCAGAGCC CCTGCCAGGA GAGAAGCGGA AGCTACCTGA GAGCCTGACG
    CTGGAGGATG CCAAGCGGAT CCGTGTCATG GGAGACATCC CCATGGAGCT GGTGAACGAG
    GTCATGCTAA CCATCACGGA CCCTGCTGCC ATGCTGGGCC CCGAGACCAG CCTGCTGTCG
    GCCAACGCGG CGCGGGATGA GACGGCGCGG CTGGAGGAGC GCCGCGGCAT CATCGAGTTC
    CACGTCATCG GCAACTCGCT CTCACAGAAA TCCAACAAGA AGATCCTGAT GTGGCTGGTG
    GGGCTGCAGA ATGTCTTCTC ACACCAGCTG CCCCGCATGC CCAAGGAGTA CATCACTCGC
    CTCGTCTTTG ACCCGAAGCA CAAGACCCTG GCACTGATCA AGGACGGACG AGTGATCGGG
    GGCATCTGCT TCCGCATGTT CCCTACCCAA GGTTTCACGG AGATTGTGTT CTGTGCTGTC
    ACCTCCAATG AGCAAGTGAA GGGCTATGGG ACGCACCTGA TGAACCACCT GAAGGAGTAC
    CACATCAAGC ACAACATCCT CTACTTCCTC ACCTATGCAG ATGAGTACGC CATTGGCTAC
    TTCAAAAAGC AGGGCTTTTC TAAGGACATC AAGGTCCCCA AGAGCCGCTA CCTGGGATAC
    ATCAAGGACT ACGAGGGGGC GACCCTGATG GAGTGTGAGC TGAACCCCCG CATCCCCTAC
    ACTGAGCTTT CACACATCAT CAAGAAGCAG AAGGAGATCA TCAAGAAGTT GATCGAGAGG
    AAACAGGCCC AGATCCGCAA AGTCTATCCA GGCCTGACCT GCTTCAAGGA GGGCGTGAGG
    CAGATCCCCA TCGAGAGCGT CCCTGGCATC CGAGAAACAG GATGGAAACC ACTGGGGAAG
    GAGAAGGGGA AGGAGCTGAA GGACCCAGAC CAGCTCTACA ACATGCTGAA GAACCTCCTG
    GCCCAGATCA AGACCCACCC CAGTGCGTGG CCCTTCATGG AGCCGGTGAA GAAGTCAGAG
    GCACCAGACT ACTATGAAAT CATCCGCTTC CCCATTGACC TGAAGACCAT GACGGAGCGC
    CTGAAGAACC GCTACTACGT CACCAAGAAG CTGTTCATCG CCGACCTGCA GCGCATCATC
    ACCAACTGCC GCGAGTACAA CCCGCCTGAC AGCGACTACT GCAAGTGTGC CAACACCCTC
    GAGAAGTTCT TCTACTTCAA GCTCAAGGAA GGGGGGCTCA TCGACAAGTA G

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.