ADAMTS2 cDNA ORF clone, Opisthocomus hoazin

The following ADAMTS2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ADAMTS2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OOp16647 XM_009931746.1
Latest version!
Opisthocomus hoazin ADAM metallopeptidase with thrombospondin type 1 motif, 2 (ADAMTS2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 19-21 $713.30
$1019.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OOp16647
    Clone ID Related Accession (Same CDS sequence) XM_009931746.1
    Accession Version XM_009931746.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3660bp)
    Protein sequence
    SNP
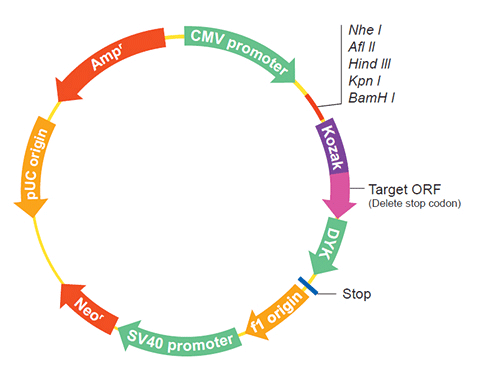
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-10-27
    Organism Opisthocomus hoazin
    Product A disintegrin and metalloproteinase with thrombospondin motifs 2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_009900509.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Opisthocomus hoazin Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 5% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGAAGATCT CTGCTCACGG TTTGCCAGTG CTGGTGGCAC TTTTCCCATT CGGGTCCTGC 
    CTTTCGACGG GAAACCCAAG GCCTCCGACA AAACTCAGGC AGAGGTCCCT TGAAGTTTGC
    CCGGTCCGGC TCTGCTCTCC TCCGACCCTC GGCTACCACC CGGATTCGCG GGAGCCAGAG
    TCCGATCCGA TTCTGAGGAA TATAGAGGAG TACAGCCTTG TCGTCCCCAC CAGCACCGAC
    TCAGAGGGCA GGTTCCTATC CCACTTGGTG TCTGGACCGC CAAAAGCACG CTTCAGGAGA
    GCTGCGGAGG ACTTGCAACA TGAAGCAGCA AATGAGCAAA TCTTTTACAA TGTCACTGTT
    TTTGGAAGAG AGTTTCACTT CAGGTTGCGG CCAAACTCCA GGCTGGTGGC CCCTGGAGCA
    ACAGTTGAAT GGCAGGAGGA CTCTGAGGAG ACCCACGTTG AACCTCTCTA TGGGAATTGC
    CTCTATGTTG GGGATATCAC TGACTTGCCA AATGCTTCAG TTGCTATCAG CAATTGCGAT
    GGGCTGGCTG GCATGATTCG CACAGACAAG GACGAGTTCT TCATTGAACC TCTGGAAAAG
    GGGGCCCAGA AGGAGGAGGA GGGAAGAGGC AGAACGCACG TGGTCTATCG CAGAGTAGCT
    GCGAAGAAGC AGCTTCCTAT GGAGAGTGTG GATACCCTGT ATAAAGCGGC TAACCTCACT
    AATTTGGATA GTCTCGACAG CGCGGTGAGC TTTGTTGAGG ACCGGGTGCG TAGAGCGAGG
    CAGCGCTATC GAAGGCATGC GACTGAGGAC GATTACAACA TTGAAGTCCT TCTGGGGGTT
    GACGACTCAG TTGTGCAATT CCATGGGAAA GAACACGTTC AGAAGTACCT GCTGACTCTG
    ATGAACATTG TCAATGAAAT TTATCATGAT GAGTCCCTGG GTGCTCACAT TAATGTTGTC
    TTGGTGAGGA TAATCCTGCT GAGCTACGGC AAGTCTATGA GTCTGATAGA GATTGGGAAC
    CCTTCACAAA GTCTGGAAAA TGTGTGTCGC TGGGCCTACT TGCAACAGAA ACCGGACACT
    GGACACGCGG AGTATCACGA CCACGCGATA TTTCTCACAA GGCAGGACTT TGGTCCATCT
    GGTATGCAAG GCTACGCTCC AGTCACTGGA ATGTGTCATC CTGTTCGAAG CTGCACTCTC
    AACCATGAAG ATGGTTTTTC ATCTGCATTT GTGGTGGCTC ATGAAACTGG ACATGTTTTA
    GGCATGGAGC ACGACGGCCA AGGGAACAGA TGTGGGGACG AAGTTCGCCT GGGGAGCATC
    ATGGCCCCCC TCGTGCAAGC CGCGTTTCAT CGCTTCCATT GGTCTCGTTG CAGCCAGCAA
    GAGCTGAATC GATACCTCCA TTCCTATGAT TGTCTGCGTG ATGATCCCTT CGAACATGAC
    TGGCCTTCCC TTCCCCAGCT GCCAGGAATT CACTACTCCA TGAATGAGCA GTGCCGTTTC
    GATTTTGGTT TGGGCTACAT GATGTGCACA GCTTTCCGCA CATTTGACCC ATGCAAGCAG
    CTGTGGTGTA GCCACCCCGA GAACCCCTAC TTCTGCAAAA CAAAGAAAGG GCCTCCGCTG
    GACGGGACCA TGTGTGCACC AGGAAAGCAT TGCTTTAAAG GTCACTGCAT CTGGCTGACA
    CCAGACATCC TGAAGCAGGA CGGGCACTGG GGGGCCTGGA GCAAGTTTGG CTCCTGCTCT
    CGCACCTGTG GCACCGGGGT GAAGTACAGG ACACGGCAGT GCGACAATCC CCATCCTGCC
    AACGGAGGCC GCACGTGCGT GGGGCCGAGC TACGAGTTCC AGCTGTGCAA CACTCAGGAC
    TGCCCGAAGG ACCTGGAAGA TTTCAGAGAG GAGCAGTGTC GGCAGTGGGA TCCTTACTTC
    GAGTACCAGA ACACAAAACA CCACTGGCTC CCCTACGAAC ATGTCGATGC TAAGGAAAGG
    TGTCACCTCT ATTGTGAATC AAAGGAAACA GGGGATGTGG TGTATATGAA AAGGATGGTA
    CACGATGGGA CCCGCTGCTC CTACAAAGAC GCGTACAGCA TCTGCGTGCG GGGAGACTGC
    TTGAAAGTTG GGTGTGACAG GGTGATAGGT TCCACAAAGC AGGAAGATAA GTGTGGTGTT
    TGTGGAGGAG ACAATTCCCA CTGCAAAGTG GTGAAAGGAA CATTTTCAAG AGTACCAAAG
    AAACAAGGGC ACATTAAGAT GTTTGAAATT CCTGTTGGTG CGAGACATTT ACTTATACAG
    GAAACAGACG CCACCAGTCA TAATCTTGCA ATTAAAAACC GTGAAACAGG GAAATTCATT
    CTAAGCGAAG ACAACTATGT GCCAGACTCT AAAGTATTTA TTGACATGGG TGTGGAGTGG
    GAATATCGGA ATGATGATGA TAGAGAAACC GTGCAGACCA TGGGGCCTCT GCGTAATGGA
    ATAGTTATTC TGGTGATTCC TCATGGTGAT GCCAAGATAT CCTTAACTTA CAAGTACATG
    ATCCATGAAG ATTCCTTGAA TGTAGATAAC AATAATGTTT TGGAAGAGGA CTCGGTGTCG
    TATGAATGGG CTTTGAAGAA ATGGTCCCAA TGTTCAAAAC CTTGTGGAGG AGGCTCCCAA
    TTCACAAAAT ATGGCTGCCG GAGGAAGACG GACCACAAGA TGGTTCATCG GAGTTACTGC
    GAGTTGATCC CAAAGCCTAA GCCCATTCGT AGGGCGTGCA ACCTCCAGGA GTGCTCCCAG
    CCCATATGGG TTACAGGAGA ATGGGAGCCT TGCAGCAAAA CTTGTGGGAA GACAGGATAT
    CAAGTACGAT CTGTCCGATG TATCCAACCC CTNCACGACA ACACGAATCG GTCTGTGCCC
    ACCAAGTACT GCAGCAGCGA CCGTCCGGAA GGCAGGAGGC CTTGCAACCG GGAGCTTTGC
    CCAGCGCAGT GGAGGACAGG ACCCTGGTCA CAGTGCTCTG TCAGCTGTGG CAATGGCACC
    CAGGATCGCC CAGTCCTATG CCGGACCAGG GACAACGCTA TTGGCCTTTG TAAAGAGAAT
    AAACCAGAGA CTGTAAGGAT TTGCAGACTA CCTCCATGTC CAAGAAATGT TTCTGATCCT
    TCGAAGAAAA CCTACATGAT ACAATGGCTG TCAAGACCTG ATCCAGACTA CCCCATCCAG
    AAAATATCTT CAAAAGATCA TTGTCAAGGA GACAAGTCAA TGTTTTGTCG CATGGAGGTT
    CTCTCCCGTT ACTGCTCGAT TGCTGGTTAC AATAAGCTGT GTTGCAAGTC CTGTAGTATG
    TACAGCAACA TAACAGAGGA CGACAATGTA ACGGATTCTA ACGTAAATAA GAATAATGTC
    ATTGAGGAGG AGCTCCTGAC AACCCTCAGC CCTCCCATGG GAGCATCCAC CACACAGTCT
    GCCACCACCA GCCCTCCTCT TGTTTCCAAA ACACGTGCGC CTCCTTCCAA TGCAACCGAG
    GAGCACCCAG AAATCAATGC GGTGGATGTC CCCTATAAAA TCGATGGGCT GGATAATGAA
    GTATCACAGC ACAACATCAT TACACAGAGG AGGATACCTT ATGAAAGGAC AAGGAATCGG
    AGAATTCAGG AGCTGATCGC TGAGAAAAGG AAAAAAGAGA CTCTTAGGAA AATAAACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_009930048.1
    CDS1..3660
    Translation

    Target ORF information:

    RefSeq Version XM_009931746.1
    Organism Opisthocomus hoazin
    Definition Opisthocomus hoazin ADAM metallopeptidase with thrombospondin type 1 motif, 2 (ADAMTS2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_009931746.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGAAGATCT CTGCTCACGG TTTGCCAGTG CTGGTGGCAC TTTTCCCATT CGGGTCCTGC 
    CTTTCGACGG GAAACCCAAG GCCTCCGACA AAACTCAGGC AGAGGTCCCT TGAAGTTTGC
    CCGGTCCGGC TCTGCTCTCC TCCGACCCTC GGCTACCACC CGGATTCGCG GGAGCCAGAG
    TCCGATCCGA TTCTGAGGAA TATAGAGGAG TACAGCCTTG TCGTCCCCAC CAGCACCGAC
    TCAGAGGGCA GGTTCCTATC CCACTTGGTG TCTGGACCGC CAAAAGCACG CTTCAGGAGA
    GCTGCGGAGG ACTTGCAACA TGAAGCAGCA AATGAGCAAA TCTTTTACAA TGTCACTGTT
    TTTGGAAGAG AGTTTCACTT CAGGTTGCGG CCAAACTCCA GGCTGGTGGC CCCTGGAGCA
    ACAGTTGAAT GGCAGGAGGA CTCTGAGGAG ACCCACGTTG AACCTCTCTA TGGGAATTGC
    CTCTATGTTG GGGATATCAC TGACTTGCCA AATGCTTCAG TTGCTATCAG CAATTGCGAT
    GGGCTGGCTG GCATGATTCG CACAGACAAG GACGAGTTCT TCATTGAACC TCTGGAAAAG
    GGGGCCCAGA AGGAGGAGGA GGGAAGAGGC AGAACGCACG TGGTCTATCG CAGAGTAGCT
    GCGAAGAAGC AGCTTCCTAT GGAGAGTGTG GATACCCTGT ATAAAGCGGC TAACCTCACT
    AATTTGGATA GTCTCGACAG CGCGGTGAGC TTTGTTGAGG ACCGGGTGCG TAGAGCGAGG
    CAGCGCTATC GAAGGCATGC GACTGAGGAC GATTACAACA TTGAAGTCCT TCTGGGGGTT
    GACGACTCAG TTGTGCAATT CCATGGGAAA GAACACGTTC AGAAGTACCT GCTGACTCTG
    ATGAACATTG TCAATGAAAT TTATCATGAT GAGTCCCTGG GTGCTCACAT TAATGTTGTC
    TTGGTGAGGA TAATCCTGCT GAGCTACGGC AAGTCTATGA GTCTGATAGA GATTGGGAAC
    CCTTCACAAA GTCTGGAAAA TGTGTGTCGC TGGGCCTACT TGCAACAGAA ACCGGACACT
    GGACACGCGG AGTATCACGA CCACGCGATA TTTCTCACAA GGCAGGACTT TGGTCCATCT
    GGTATGCAAG GCTACGCTCC AGTCACTGGA ATGTGTCATC CTGTTCGAAG CTGCACTCTC
    AACCATGAAG ATGGTTTTTC ATCTGCATTT GTGGTGGCTC ATGAAACTGG ACATGTTTTA
    GGCATGGAGC ACGACGGCCA AGGGAACAGA TGTGGGGACG AAGTTCGCCT GGGGAGCATC
    ATGGCCCCCC TCGTGCAAGC CGCGTTTCAT CGCTTCCATT GGTCTCGTTG CAGCCAGCAA
    GAGCTGAATC GATACCTCCA TTCCTATGAT TGTCTGCGTG ATGATCCCTT CGAACATGAC
    TGGCCTTCCC TTCCCCAGCT GCCAGGAATT CACTACTCCA TGAATGAGCA GTGCCGTTTC
    GATTTTGGTT TGGGCTACAT GATGTGCACA GCTTTCCGCA CATTTGACCC ATGCAAGCAG
    CTGTGGTGTA GCCACCCCGA GAACCCCTAC TTCTGCAAAA CAAAGAAAGG GCCTCCGCTG
    GACGGGACCA TGTGTGCACC AGGAAAGCAT TGCTTTAAAG GTCACTGCAT CTGGCTGACA
    CCAGACATCC TGAAGCAGGA CGGGCACTGG GGGGCCTGGA GCAAGTTTGG CTCCTGCTCT
    CGCACCTGTG GCACCGGGGT GAAGTACAGG ACACGGCAGT GCGACAATCC CCATCCTGCC
    AACGGAGGCC GCACGTGCGT GGGGCCGAGC TACGAGTTCC AGCTGTGCAA CACTCAGGAC
    TGCCCGAAGG ACCTGGAAGA TTTCAGAGAG GAGCAGTGTC GGCAGTGGGA TCCTTACTTC
    GAGTACCAGA ACACAAAACA CCACTGGCTC CCCTACGAAC ATGTCGATGC TAAGGAAAGG
    TGTCACCTCT ATTGTGAATC AAAGGAAACA GGGGATGTGG TGTATATGAA AAGGATGGTA
    CACGATGGGA CCCGCTGCTC CTACAAAGAC GCGTACAGCA TCTGCGTGCG GGGAGACTGC
    TTGAAAGTTG GGTGTGACAG GGTGATAGGT TCCACAAAGC AGGAAGATAA GTGTGGTGTT
    TGTGGAGGAG ACAATTCCCA CTGCAAAGTG GTGAAAGGAA CATTTTCAAG AGTACCAAAG
    AAACAAGGGC ACATTAAGAT GTTTGAAATT CCTGTTGGTG CGAGACATTT ACTTATACAG
    GAAACAGACG CCACCAGTCA TAATCTTGCA ATTAAAAACC GTGAAACAGG GAAATTCATT
    CTAAGCGAAG ACAACTATGT GCCAGACTCT AAAGTATTTA TTGACATGGG TGTGGAGTGG
    GAATATCGGA ATGATGATGA TAGAGAAACC GTGCAGACCA TGGGGCCTCT GCGTAATGGA
    ATAGTTATTC TGGTGATTCC TCATGGTGAT GCCAAGATAT CCTTAACTTA CAAGTACATG
    ATCCATGAAG ATTCCTTGAA TGTAGATAAC AATAATGTTT TGGAAGAGGA CTCGGTGTCG
    TATGAATGGG CTTTGAAGAA ATGGTCCCAA TGTTCAAAAC CTTGTGGAGG AGGCTCCCAA
    TTCACAAAAT ATGGCTGCCG GAGGAAGACG GACCACAAGA TGGTTCATCG GAGTTACTGC
    GAGTTGATCC CAAAGCCTAA GCCCATTCGT AGGGCGTGCA ACCTCCAGGA GTGCTCCCAG
    CCCATATGGG TTACAGGAGA ATGGGAGCCT TGCAGCAAAA CTTGTGGGAA GACAGGATAT
    CAAGTACGAT CTGTCCGATG TATCCAACCC CTNCACGACA ACACGAATCG GTCTGTGCCC
    ACCAAGTACT GCAGCAGCGA CCGTCCGGAA GGCAGGAGGC CTTGCAACCG GGAGCTTTGC
    CCAGCGCAGT GGAGGACAGG ACCCTGGTCA CAGTGCTCTG TCAGCTGTGG CAATGGCACC
    CAGGATCGCC CAGTCCTATG CCGGACCAGG GACAACGCTA TTGGCCTTTG TAAAGAGAAT
    AAACCAGAGA CTGTAAGGAT TTGCAGACTA CCTCCATGTC CAAGAAATGT TTCTGATCCT
    TCGAAGAAAA CCTACATGAT ACAATGGCTG TCAAGACCTG ATCCAGACTA CCCCATCCAG
    AAAATATCTT CAAAAGATCA TTGTCAAGGA GACAAGTCAA TGTTTTGTCG CATGGAGGTT
    CTCTCCCGTT ACTGCTCGAT TGCTGGTTAC AATAAGCTGT GTTGCAAGTC CTGTAGTATG
    TACAGCAACA TAACAGAGGA CGACAATGTA ACGGATTCTA ACGTAAATAA GAATAATGTC
    ATTGAGGAGG AGCTCCTGAC AACCCTCAGC CCTCCCATGG GAGCATCCAC CACACAGTCT
    GCCACCACCA GCCCTCCTCT TGTTTCCAAA ACACGTGCGC CTCCTTCCAA TGCAACCGAG
    GAGCACCCAG AAATCAATGC GGTGGATGTC CCCTATAAAA TCGATGGGCT GGATAATGAA
    GTATCACAGC ACAACATCAT TACACAGAGG AGGATACCTT ATGAAAGGAC AAGGAATCGG
    AGAATTCAGG AGCTGATCGC TGAGAAAAGG AAAAAAGAGA CTCTTAGGAA AATAAACTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.