SIK3 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

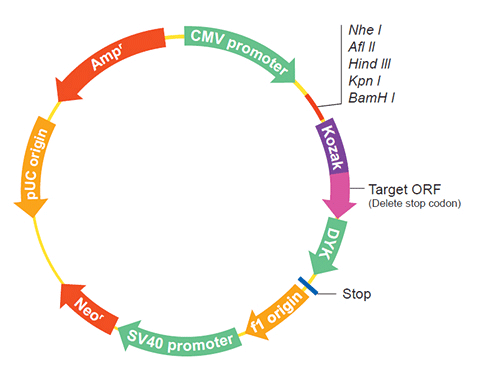
The following SIK3 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the SIK3 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa61277 XM_008973520.3
Latest version!
Pan paniscus SIK family kinase 3 (SIK3), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OPa61278 XM_008973521.2
Latest version!
Pan paniscus SIK family kinase 3 (SIK3), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OPa61279 XM_008973522.2
Latest version!
Pan paniscus SIK family kinase 3 (SIK3), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OPa61280 XM_008973523.3
Latest version!
Pan paniscus SIK family kinase 3 (SIK3), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OPa61281 XM_008973524.2
Latest version!
Pan paniscus SIK family kinase 3 (SIK3), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00
OPa61282 XM_008973525.3
Latest version!
Pan paniscus SIK family kinase 3 (SIK3), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00
View Old Accession Versions >>
OPa61282 XM_008973525.2 Pan paniscus SIK family kinase 3 (SIK3), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $629.30
$899.00
OPa61277 XM_008973520.2 Pan paniscus SIK family kinase 3 (SIK3), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
OPa61280 XM_008973523.2 Pan paniscus SIK family kinase 3 (SIK3), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $713.30
$1019.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa61277
    Clone ID Related Accession (Same CDS sequence) XM_008973520.3 , XM_008973520.2
    Accession Version XM_008973520.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3762bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027879.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008973520.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG GTACTTGGCA AATAGGTCCA AAAGACATAC ACTGGCCATG
    ACCAACCCTA CAGCTGAGAT CCCACCGGAC CTACAACGGC AGCTAGGACA GCAGCCTTTC
    CGTTCCCGGG TCTGGCCTCC TCACCTGGTA CCTGATCAGC ATCGCTCTAC CTACAAGGAC
    TCCAACACTC TGCACCTCCC TACGGAGCGT TTCTCCCCTG TGCGCCGGTT CTCAGATGGG
    GCTGCGAGCA TCCAGGCCTT CAAAGCTCAC CTGGAAAAAA TGGGCAACAA CAGCAGCATC
    AAACAGCTGC AGCAGGAGTG TGAGCAGCTG CAGAAGATGT ACGGGGGGCA GATTGATGAA
    AGAACCCTGG AGAAGACCCA GCAGCAGCAT ATGTTATACC AGCAGGAGCA GCACCATCAA
    ATTCTCCAGC AACAAATTCA AGACTCTATC TGTCCTCCTC AGCCATCTCC ACCTCTTCAG
    GCTGCATGTG AAAATCAGCC AGCCCTCCTT ACCCATCAGC TCCAGAGGTT AAGGATTCAG
    CCTTCAAGCC CACCCCCCAA CCACCCCAAC AACCATCTCT TCAGGCAGCC CAGTAATAGT
    CCTCCCCCCA TGAGCAGTGC CATGATCCAG CCTCACGGGG CTGCATCTTC TTCCCAGTTT
    CAAGGCTTAC CTTCCCGCAG TGCAATCTTT CAGCAGCAAC CTGAGAACTG TTCCTCTCCT
    CCCAACGTGG CACTAACCTG CTTGGGTATG CAGCAGCCTG CTCAGTCACA GCAGGTCACC
    ATCCAAGTCC AAGAGCCTGT TGACATGCTC AGCAACATGC CAGGCACAGC TGCAGGCTCC
    AGTGGGCGCG GCATCTCCAT CAGCCCCAGT GCCGGTCAGA TGCAGATGCA GCACCGTACC
    AACCTGATGG CCACCCTCAG CTATGGGCAC CGTCCCTTGT CCAAGCAGCT GAGTGCTGAC
    AGTGCAGAGG CTCACAGCTT GAACGTGAAT CGGTTCTCCC CTGCTAACTA CGACCAGCCG
    CATTTACACC CCCATCTGTT TTCGGACCAG TCCCGGGGTT CCCCCAGCAG CTACAGCCCT
    TCAACAGGAG TGGGGTTCTC TCCAACCCAA GCCCTGAAAG TCCCTCCACT TGACCAATTC
    CCCACCTTCC CTCCCAGTGC ACATCAGCAG CCGCCACACT ATACCACGTC GGCACTACAG
    CAGGCCCTGC TGTCTCCCAC GCCGCCAGAC TATACAAGAC ACCAGCAGGT ACCCCACATC
    CTTCAAGGAC TGCTTTCTCC CCGGCATTCG CTCACCGGCC ACTCGGACAT CCGGCTGCCC
    CCAACAGAGT TTGCACAGCT CATTAAAAGG CAGCAGCAAC AACGGCAGCA GCAGCAGCAA
    CAGCAGCAAC AGCAAGAATA CCAGGAACTG TTCAGGCACA TGAACCAAGG GGATGCGGGG
    AGTCTGGCTC CCAGCCTTGG GGGACAGAGC ATGACAGAGC GCCAGGCTTT ATCTTATCAA
    AATGCTGACT CTTATCACCA TCACACCAGC CCCCAGCATC TGCTACAAAT CAGGGCACAA
    GAATGTGTCT CACAGGCTTC CTCACCCACC CCGCCCCACG GGTATGCTCA CCAGCCGGCA
    CTGATGCATT CAGAGAGCAT GGAGGAGGAC TGCTCGTGTG AGGGGGCCAA GGATGGCTTC
    CAAGACAGTA AGAGTTCAAG TACATTGACC AAAGGTTGCC ATGACAGCCC TCTGCTCTTG
    AGTACCGGTG GACCTGGGGA CCCTGAATCT TTGCTAGGAA CTGTGAGTCA TGCCCAAGAA
    TTGGGGATAC ATCCCTATGG TCATCAGCCG ACTGCTGCAT TCAGTAAAAA TAAGGTGCCC
    AGCAGAGAGC CTGTCATAGG GAACTGCATG GATAGAAGTT CTCCAGGACA AGCAGTGGAG
    CTGCCGGATC ACAATGGGCT CGGGTACCCA GCACGCCCCT CCGTCCATGA GCACCACAGG
    CCCCGGGCCC TCCAGAGACA CCACACGATC CAGAACAGCG ACGATGCTTA TGTACAGCTG
    GATAACTTGC CAGGAATGAG TCTCGTGGCT GGGAAAGCAC TTAGCTCTGC CCGGATGTCG
    GATGCAGTTC TCAGTCAGTC TTCGCTCATG GGCAGCCAGC AGTTTCAGGA TGGGGAAAAT
    GAGGAATGTG GGGCAAGCCT GGGAGGTCAT GAGCACCCAG ACCTGAGCGA TGGCAGCCAG
    CATTTAAACT CCTCTTGCTA TCCATCTACG TGTATTACAG ACATTCTGCT CAGCTACAAG
    CACCCCGAAG TCTCCTTCAG CATGGAGCAG GCAGGCGTGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971768.1
    CDS72..3833
    Translation

    Target ORF information:

    RefSeq Version XM_008973520.3
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973520.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG GTACTTGGCA AATAGGTCCA AAAGACATAC ACTGGCCATG
    ACCAACCCTA CAGCTGAGAT CCCACCGGAC CTACAACGGC AGCTAGGACA GCAGCCTTTC
    CGTTCCCGGG TCTGGCCTCC TCACCTGGTA CCTGATCAGC ATCGCTCTAC CTACAAGGAC
    TCCAACACTC TGCACCTCCC TACGGAGCGT TTCTCCCCTG TGCGCCGGTT CTCAGATGGG
    GCTGCGAGCA TCCAGGCCTT CAAAGCTCAC CTGGAAAAAA TGGGCAACAA CAGCAGCATC
    AAACAGCTGC AGCAGGAGTG TGAGCAGCTG CAGAAGATGT ACGGGGGGCA GATTGATGAA
    AGAACCCTGG AGAAGACCCA GCAGCAGCAT ATGTTATACC AGCAGGAGCA GCACCATCAA
    ATTCTCCAGC AACAAATTCA AGACTCTATC TGTCCTCCTC AGCCATCTCC ACCTCTTCAG
    GCTGCATGTG AAAATCAGCC AGCCCTCCTT ACCCATCAGC TCCAGAGGTT AAGGATTCAG
    CCTTCAAGCC CACCCCCCAA CCACCCCAAC AACCATCTCT TCAGGCAGCC CAGTAATAGT
    CCTCCCCCCA TGAGCAGTGC CATGATCCAG CCTCACGGGG CTGCATCTTC TTCCCAGTTT
    CAAGGCTTAC CTTCCCGCAG TGCAATCTTT CAGCAGCAAC CTGAGAACTG TTCCTCTCCT
    CCCAACGTGG CACTAACCTG CTTGGGTATG CAGCAGCCTG CTCAGTCACA GCAGGTCACC
    ATCCAAGTCC AAGAGCCTGT TGACATGCTC AGCAACATGC CAGGCACAGC TGCAGGCTCC
    AGTGGGCGCG GCATCTCCAT CAGCCCCAGT GCCGGTCAGA TGCAGATGCA GCACCGTACC
    AACCTGATGG CCACCCTCAG CTATGGGCAC CGTCCCTTGT CCAAGCAGCT GAGTGCTGAC
    AGTGCAGAGG CTCACAGCTT GAACGTGAAT CGGTTCTCCC CTGCTAACTA CGACCAGCCG
    CATTTACACC CCCATCTGTT TTCGGACCAG TCCCGGGGTT CCCCCAGCAG CTACAGCCCT
    TCAACAGGAG TGGGGTTCTC TCCAACCCAA GCCCTGAAAG TCCCTCCACT TGACCAATTC
    CCCACCTTCC CTCCCAGTGC ACATCAGCAG CCGCCACACT ATACCACGTC GGCACTACAG
    CAGGCCCTGC TGTCTCCCAC GCCGCCAGAC TATACAAGAC ACCAGCAGGT ACCCCACATC
    CTTCAAGGAC TGCTTTCTCC CCGGCATTCG CTCACCGGCC ACTCGGACAT CCGGCTGCCC
    CCAACAGAGT TTGCACAGCT CATTAAAAGG CAGCAGCAAC AACGGCAGCA GCAGCAGCAA
    CAGCAGCAAC AGCAAGAATA CCAGGAACTG TTCAGGCACA TGAACCAAGG GGATGCGGGG
    AGTCTGGCTC CCAGCCTTGG GGGACAGAGC ATGACAGAGC GCCAGGCTTT ATCTTATCAA
    AATGCTGACT CTTATCACCA TCACACCAGC CCCCAGCATC TGCTACAAAT CAGGGCACAA
    GAATGTGTCT CACAGGCTTC CTCACCCACC CCGCCCCACG GGTATGCTCA CCAGCCGGCA
    CTGATGCATT CAGAGAGCAT GGAGGAGGAC TGCTCGTGTG AGGGGGCCAA GGATGGCTTC
    CAAGACAGTA AGAGTTCAAG TACATTGACC AAAGGTTGCC ATGACAGCCC TCTGCTCTTG
    AGTACCGGTG GACCTGGGGA CCCTGAATCT TTGCTAGGAA CTGTGAGTCA TGCCCAAGAA
    TTGGGGATAC ATCCCTATGG TCATCAGCCG ACTGCTGCAT TCAGTAAAAA TAAGGTGCCC
    AGCAGAGAGC CTGTCATAGG GAACTGCATG GATAGAAGTT CTCCAGGACA AGCAGTGGAG
    CTGCCGGATC ACAATGGGCT CGGGTACCCA GCACGCCCCT CCGTCCATGA GCACCACAGG
    CCCCGGGCCC TCCAGAGACA CCACACGATC CAGAACAGCG ACGATGCTTA TGTACAGCTG
    GATAACTTGC CAGGAATGAG TCTCGTGGCT GGGAAAGCAC TTAGCTCTGC CCGGATGTCG
    GATGCAGTTC TCAGTCAGTC TTCGCTCATG GGCAGCCAGC AGTTTCAGGA TGGGGAAAAT
    GAGGAATGTG GGGCAAGCCT GGGAGGTCAT GAGCACCCAG ACCTGAGCGA TGGCAGCCAG
    CATTTAAACT CCTCTTGCTA TCCATCTACG TGTATTACAG ACATTCTGCT CAGCTACAAG
    CACCCCGAAG TCTCCTTCAG CATGGAGCAG GCAGGCGTGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa61277
    Clone ID Related Accession (Same CDS sequence) XM_008973520.3 , XM_008973520.2
    Accession Version XM_008973520.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3762bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014158.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_008973520.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG GTACTTGGCA AATAGGTCCA AAAGACATAC ACTGGCCATG
    ACCAACCCTA CAGCTGAGAT CCCACCGGAC CTACAACGGC AGCTAGGACA GCAGCCTTTC
    CGTTCCCGGG TCTGGCCTCC TCACCTGGTA CCTGATCAGC ATCGCTCTAC CTACAAGGAC
    TCCAACACTC TGCACCTCCC TACGGAGCGT TTCTCCCCTG TGCGCCGGTT CTCAGATGGG
    GCTGCGAGCA TCCAGGCCTT CAAAGCTCAC CTGGAAAAAA TGGGCAACAA CAGCAGCATC
    AAACAGCTGC AGCAGGAGTG TGAGCAGCTG CAGAAGATGT ACGGGGGGCA GATTGATGAA
    AGAACCCTGG AGAAGACCCA GCAGCAGCAT ATGTTATACC AGCAGGAGCA GCACCATCAA
    ATTCTCCAGC AACAAATTCA AGACTCTATC TGTCCTCCTC AGCCATCTCC ACCTCTTCAG
    GCTGCATGTG AAAATCAGCC AGCCCTCCTT ACCCATCAGC TCCAGAGGTT AAGGATTCAG
    CCTTCAAGCC CACCCCCCAA CCACCCCAAC AACCATCTCT TCAGGCAGCC CAGTAATAGT
    CCTCCCCCCA TGAGCAGTGC CATGATCCAG CCTCACGGGG CTGCATCTTC TTCCCAGTTT
    CAAGGCTTAC CTTCCCGCAG TGCAATCTTT CAGCAGCAAC CTGAGAACTG TTCCTCTCCT
    CCCAACGTGG CACTAACCTG CTTGGGTATG CAGCAGCCTG CTCAGTCACA GCAGGTCACC
    ATCCAAGTCC AAGAGCCTGT TGACATGCTC AGCAACATGC CAGGCACAGC TGCAGGCTCC
    AGTGGGCGCG GCATCTCCAT CAGCCCCAGT GCCGGTCAGA TGCAGATGCA GCACCGTACC
    AACCTGATGG CCACCCTCAG CTATGGGCAC CGTCCCTTGT CCAAGCAGCT GAGTGCTGAC
    AGTGCAGAGG CTCACAGCTT GAACGTGAAT CGGTTCTCCC CTGCTAACTA CGACCAGCCG
    CATTTACACC CCCATCTGTT TTCGGACCAG TCCCGGGGTT CCCCCAGCAG CTACAGCCCT
    TCAACAGGAG TGGGGTTCTC TCCAACCCAA GCCCTGAAAG TCCCTCCACT TGACCAATTC
    CCCACCTTCC CTCCCAGTGC ACATCAGCAG CCGCCACACT ATACCACGTC GGCACTACAG
    CAGGCCCTGC TGTCTCCCAC GCCGCCAGAC TATACAAGAC ACCAGCAGGT ACCCCACATC
    CTTCAAGGAC TGCTTTCTCC CCGGCATTCG CTCACCGGCC ACTCGGACAT CCGGCTGCCC
    CCAACAGAGT TTGCACAGCT CATTAAAAGG CAGCAGCAAC AACGGCAGCA GCAGCAGCAA
    CAGCAGCAAC AGCAAGAATA CCAGGAACTG TTCAGGCACA TGAACCAAGG GGATGCGGGG
    AGTCTGGCTC CCAGCCTTGG GGGACAGAGC ATGACAGAGC GCCAGGCTTT ATCTTATCAA
    AATGCTGACT CTTATCACCA TCACACCAGC CCCCAGCATC TGCTACAAAT CAGGGCACAA
    GAATGTGTCT CACAGGCTTC CTCACCCACC CCGCCCCACG GGTATGCTCA CCAGCCGGCA
    CTGATGCATT CAGAGAGCAT GGAGGAGGAC TGCTCGTGTG AGGGGGCCAA GGATGGCTTC
    CAAGACAGTA AGAGTTCAAG TACATTGACC AAAGGTTGCC ATGACAGCCC TCTGCTCTTG
    AGTACCGGTG GACCTGGGGA CCCTGAATCT TTGCTAGGAA CTGTGAGTCA TGCCCAAGAA
    TTGGGGATAC ATCCCTATGG TCATCAGCCG ACTGCTGCAT TCAGTAAAAA TAAGGTGCCC
    AGCAGAGAGC CTGTCATAGG GAACTGCATG GATAGAAGTT CTCCAGGACA AGCAGTGGAG
    CTGCCGGATC ACAATGGGCT CGGGTACCCA GCACGCCCCT CCGTCCATGA GCACCACAGG
    CCCCGGGCCC TCCAGAGACA CCACACGATC CAGAACAGCG ACGATGCTTA TGTACAGCTG
    GATAACTTGC CAGGAATGAG TCTCGTGGCT GGGAAAGCAC TTAGCTCTGC CCGGATGTCG
    GATGCAGTTC TCAGTCAGTC TTCGCTCATG GGCAGCCAGC AGTTTCAGGA TGGGGAAAAT
    GAGGAATGTG GGGCAAGCCT GGGAGGTCAT GAGCACCCAG ACCTGAGCGA TGGCAGCCAG
    CATTTAAACT CCTCTTGCTA TCCATCTACG TGTATTACAG ACATTCTGCT CAGCTACAAG
    CACCCCGAAG TCTCCTTCAG CATGGAGCAG GCAGGCGTGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971768.1
    CDS72..3833
    Translation

    Target ORF information:

    RefSeq Version XM_008973520.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973520.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    3661
    3721
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG GTACTTGGCA AATAGGTCCA AAAGACATAC ACTGGCCATG
    ACCAACCCTA CAGCTGAGAT CCCACCGGAC CTACAACGGC AGCTAGGACA GCAGCCTTTC
    CGTTCCCGGG TCTGGCCTCC TCACCTGGTA CCTGATCAGC ATCGCTCTAC CTACAAGGAC
    TCCAACACTC TGCACCTCCC TACGGAGCGT TTCTCCCCTG TGCGCCGGTT CTCAGATGGG
    GCTGCGAGCA TCCAGGCCTT CAAAGCTCAC CTGGAAAAAA TGGGCAACAA CAGCAGCATC
    AAACAGCTGC AGCAGGAGTG TGAGCAGCTG CAGAAGATGT ACGGGGGGCA GATTGATGAA
    AGAACCCTGG AGAAGACCCA GCAGCAGCAT ATGTTATACC AGCAGGAGCA GCACCATCAA
    ATTCTCCAGC AACAAATTCA AGACTCTATC TGTCCTCCTC AGCCATCTCC ACCTCTTCAG
    GCTGCATGTG AAAATCAGCC AGCCCTCCTT ACCCATCAGC TCCAGAGGTT AAGGATTCAG
    CCTTCAAGCC CACCCCCCAA CCACCCCAAC AACCATCTCT TCAGGCAGCC CAGTAATAGT
    CCTCCCCCCA TGAGCAGTGC CATGATCCAG CCTCACGGGG CTGCATCTTC TTCCCAGTTT
    CAAGGCTTAC CTTCCCGCAG TGCAATCTTT CAGCAGCAAC CTGAGAACTG TTCCTCTCCT
    CCCAACGTGG CACTAACCTG CTTGGGTATG CAGCAGCCTG CTCAGTCACA GCAGGTCACC
    ATCCAAGTCC AAGAGCCTGT TGACATGCTC AGCAACATGC CAGGCACAGC TGCAGGCTCC
    AGTGGGCGCG GCATCTCCAT CAGCCCCAGT GCCGGTCAGA TGCAGATGCA GCACCGTACC
    AACCTGATGG CCACCCTCAG CTATGGGCAC CGTCCCTTGT CCAAGCAGCT GAGTGCTGAC
    AGTGCAGAGG CTCACAGCTT GAACGTGAAT CGGTTCTCCC CTGCTAACTA CGACCAGCCG
    CATTTACACC CCCATCTGTT TTCGGACCAG TCCCGGGGTT CCCCCAGCAG CTACAGCCCT
    TCAACAGGAG TGGGGTTCTC TCCAACCCAA GCCCTGAAAG TCCCTCCACT TGACCAATTC
    CCCACCTTCC CTCCCAGTGC ACATCAGCAG CCGCCACACT ATACCACGTC GGCACTACAG
    CAGGCCCTGC TGTCTCCCAC GCCGCCAGAC TATACAAGAC ACCAGCAGGT ACCCCACATC
    CTTCAAGGAC TGCTTTCTCC CCGGCATTCG CTCACCGGCC ACTCGGACAT CCGGCTGCCC
    CCAACAGAGT TTGCACAGCT CATTAAAAGG CAGCAGCAAC AACGGCAGCA GCAGCAGCAA
    CAGCAGCAAC AGCAAGAATA CCAGGAACTG TTCAGGCACA TGAACCAAGG GGATGCGGGG
    AGTCTGGCTC CCAGCCTTGG GGGACAGAGC ATGACAGAGC GCCAGGCTTT ATCTTATCAA
    AATGCTGACT CTTATCACCA TCACACCAGC CCCCAGCATC TGCTACAAAT CAGGGCACAA
    GAATGTGTCT CACAGGCTTC CTCACCCACC CCGCCCCACG GGTATGCTCA CCAGCCGGCA
    CTGATGCATT CAGAGAGCAT GGAGGAGGAC TGCTCGTGTG AGGGGGCCAA GGATGGCTTC
    CAAGACAGTA AGAGTTCAAG TACATTGACC AAAGGTTGCC ATGACAGCCC TCTGCTCTTG
    AGTACCGGTG GACCTGGGGA CCCTGAATCT TTGCTAGGAA CTGTGAGTCA TGCCCAAGAA
    TTGGGGATAC ATCCCTATGG TCATCAGCCG ACTGCTGCAT TCAGTAAAAA TAAGGTGCCC
    AGCAGAGAGC CTGTCATAGG GAACTGCATG GATAGAAGTT CTCCAGGACA AGCAGTGGAG
    CTGCCGGATC ACAATGGGCT CGGGTACCCA GCACGCCCCT CCGTCCATGA GCACCACAGG
    CCCCGGGCCC TCCAGAGACA CCACACGATC CAGAACAGCG ACGATGCTTA TGTACAGCTG
    GATAACTTGC CAGGAATGAG TCTCGTGGCT GGGAAAGCAC TTAGCTCTGC CCGGATGTCG
    GATGCAGTTC TCAGTCAGTC TTCGCTCATG GGCAGCCAGC AGTTTCAGGA TGGGGAAAAT
    GAGGAATGTG GGGCAAGCCT GGGAGGTCAT GAGCACCCAG ACCTGAGCGA TGGCAGCCAG
    CATTTAAACT CCTCTTGCTA TCCATCTACG TGTATTACAG ACATTCTGCT CAGCTACAAG
    CACCCCGAAG TCTCCTTCAG CATGGAGCAG GCAGGCGTGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa61278
    Clone ID Related Accession (Same CDS sequence) XM_008973521.2
    Accession Version XM_008973521.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3618bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027879.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_008973521.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGCTTGAAC
    GTGAATCGGT TCTCCCCTGC TAACTACGAC CAGCCGCATT TACACCCCCA TCTGTTTTCG
    GACCAGTCCC GGGGTTCCCC CAGCAGCTAC AGCCCTTCAA CAGGAGTGGG GTTCTCTCCA
    ACCCAAGCCC TGAAAGTCCC TCCACTTGAC CAATTCCCCA CCTTCCCTCC CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_008971769.1
    CDS70..3687
    Translation

    Target ORF information:

    RefSeq Version XM_008973521.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973521.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGCTTGAAC
    GTGAATCGGT TCTCCCCTGC TAACTACGAC CAGCCGCATT TACACCCCCA TCTGTTTTCG
    GACCAGTCCC GGGGTTCCCC CAGCAGCTAC AGCCCTTCAA CAGGAGTGGG GTTCTCTCCA
    ACCCAAGCCC TGAAAGTCCC TCCACTTGAC CAATTCCCCA CCTTCCCTCC CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa61279
    Clone ID Related Accession (Same CDS sequence) XM_008973522.2
    Accession Version XM_008973522.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3618bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027879.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_008973522.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGGCG GAGCAGGCAG GTACTGCTAT GAACATCAGC
    GTTCCCCAGG TGCAGCTGAT CAACCCAGAG AACCAAATTG TGGAGCCGGA TGGGACACTG
    AATTTGGACA GTGATGAGGG TGAAGAGCCT TCCCCGGAAG CATTGGTGCG CTATTTGTCA
    ATGAGGAGGC ACACAGTGGG TGTGGCTGAC CCACGCACGG AAGTTATGGA AGATCTGCAG
    AAGCTCCTAC CTGGCTTTCC TGGAGTCAAC CCCCAGGCTC CATTCCTGCA GGTGGCCCCT
    AATGTGAACT TCATGCACAA CCTGTTGCCT ATGCAAAATT TGCAACCAAC CGGGCAACTT
    GAGTACAAGG AGCAGTCTCT CCTACAGCCG CCCACGCTAC AGCTGTTGAA TGGAATGGGC
    CCCCTTGGCC GGAGGGCATC AGATGGAGGA GCCAACATCC AACTGCATGC CCAGCAGCTG
    CTGAAGCGCC CACGGGGACC CTCTCCGCTT GTCACCATGA CACCAGCAGT GCCAGCAGTT
    ACCCCTGTGG ACGAGGAGAG CTCGGACGGG GAGCCAGACC AGGAAGCTGT GCAGAGGTAC
    TTGGCAAATA GGTCCAAAAG ACATACACTG GCCATGACCA ACCCTACAGC TGAGATCCCA
    CCGGACCTAC AACGGCAGCT AGGACAGCAG CCTTTCCGTT CCCGGGTCTG GCCTCCTCAC
    CTGGTACCTG ATCAGCATCG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGCTTGAAC
    GTGAATCGGT TCTCCCCTGC TAACTACGAC CAGCCGCATT TACACCCCCA TCTGTTTTCG
    GACCAGTCCC GGGGTTCCCC CAGCAGCTAC AGCCCTTCAA CAGGAGTGGG GTTCTCTCCA
    ACCCAAGCCC TGAAAGTCCC TCCACTTGAC CAATTCCCCA CCTTCCCTCC CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971770.1
    CDS72..3689
    Translation

    Target ORF information:

    RefSeq Version XM_008973522.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973522.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    3601
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGGCG GAGCAGGCAG GTACTGCTAT GAACATCAGC
    GTTCCCCAGG TGCAGCTGAT CAACCCAGAG AACCAAATTG TGGAGCCGGA TGGGACACTG
    AATTTGGACA GTGATGAGGG TGAAGAGCCT TCCCCGGAAG CATTGGTGCG CTATTTGTCA
    ATGAGGAGGC ACACAGTGGG TGTGGCTGAC CCACGCACGG AAGTTATGGA AGATCTGCAG
    AAGCTCCTAC CTGGCTTTCC TGGAGTCAAC CCCCAGGCTC CATTCCTGCA GGTGGCCCCT
    AATGTGAACT TCATGCACAA CCTGTTGCCT ATGCAAAATT TGCAACCAAC CGGGCAACTT
    GAGTACAAGG AGCAGTCTCT CCTACAGCCG CCCACGCTAC AGCTGTTGAA TGGAATGGGC
    CCCCTTGGCC GGAGGGCATC AGATGGAGGA GCCAACATCC AACTGCATGC CCAGCAGCTG
    CTGAAGCGCC CACGGGGACC CTCTCCGCTT GTCACCATGA CACCAGCAGT GCCAGCAGTT
    ACCCCTGTGG ACGAGGAGAG CTCGGACGGG GAGCCAGACC AGGAAGCTGT GCAGAGGTAC
    TTGGCAAATA GGTCCAAAAG ACATACACTG GCCATGACCA ACCCTACAGC TGAGATCCCA
    CCGGACCTAC AACGGCAGCT AGGACAGCAG CCTTTCCGTT CCCGGGTCTG GCCTCCTCAC
    CTGGTACCTG ATCAGCATCG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGCTTGAAC
    GTGAATCGGT TCTCCCCTGC TAACTACGAC CAGCCGCATT TACACCCCCA TCTGTTTTCG
    GACCAGTCCC GGGGTTCCCC CAGCAGCTAC AGCCCTTCAA CAGGAGTGGG GTTCTCTCCA
    ACCCAAGCCC TGAAAGTCCC TCCACTTGAC CAATTCCCCA CCTTCCCTCC CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa61280
    Clone ID Related Accession (Same CDS sequence) XM_008973523.3 , XM_008973523.2
    Accession Version XM_008973523.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3582bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027879.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008973523.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG GTACTTGGCA AATAGGTCCA AAAGACATAC ACTGGCCATG
    ACCAACCCTA CAGCTGAGAT CCCACCGGAC CTACAACGGC AGCTAGGACA GCAGCCTTTC
    CGTTCCCGGG TCTGGCCTCC TCACCTGGTA CCTGATCAGC ATCGCTCTAC CTACAAGGAC
    TCCAACACTC TGCACCTCCC TACGGAGCGT TTCTCCCCTG TGCGCCGGTT CTCAGATGGG
    GCTGCGAGCA TCCAGGCCTT CAAAGCTCAC CTGGAAAAAA TGGGCAACAA CAGCAGCATC
    AAACAGCTGC AGCAGGAGTG TGAGCAGCTG CAGAAGATGT ACGGGGGGCA GATTGATGAA
    AGAACCCTGG AGAAGACCCA GCAGCAGCAT ATGTTATACC AGCAGGAGCA GCACCATCAA
    ATTCTCCAGC AACAAATTCA AGACTCTATC TGTCCTCCTC AGCCATCTCC ACCTCTTCAG
    GCTGCATGTG AAAATCAGCC AGCCCTCCTT ACCCATCAGC TCCAGAGGTT AAGGATTCAG
    CCTTCAAGCC CACCCCCCAA CCACCCCAAC AACCATCTCT TCAGGCAGCC CAGTAATAGT
    CCTCCCCCCA TGAGCAGTGC CATGATCCAG CCTCACGGGG CTGCATCTTC TTCCCAGTTT
    CAAGGCTTAC CTTCCCGCAG TGCAATCTTT CAGCAGCAAC CTGAGAACTG TTCCTCTCCT
    CCCAACGTGG CACTAACCTG CTTGGGTATG CAGCAGCCTG CTCAGTCACA GCAGGTCACC
    ATCCAAGTCC AAGAGCCTGT TGACATGCTC AGCAACATGC CAGGCACAGC TGCAGGCTCC
    AGTGGGCGCG GCATCTCCAT CAGCCCCAGT GCCGGTCAGA TGCAGATGCA GCACCGTACC
    AACCTGATGG CCACCCTCAG CTATGGGCAC CGTCCCTTGT CCAAGCAGCT GAGTGCTGAC
    AGTGCAGAGG CTCACAGTGC ACATCAGCAG CCGCCACACT ATACCACGTC GGCACTACAG
    CAGGCCCTGC TGTCTCCCAC GCCGCCAGAC TATACAAGAC ACCAGCAGGT ACCCCACATC
    CTTCAAGGAC TGCTTTCTCC CCGGCATTCG CTCACCGGCC ACTCGGACAT CCGGCTGCCC
    CCAACAGAGT TTGCACAGCT CATTAAAAGG CAGCAGCAAC AACGGCAGCA GCAGCAGCAA
    CAGCAGCAAC AGCAAGAATA CCAGGAACTG TTCAGGCACA TGAACCAAGG GGATGCGGGG
    AGTCTGGCTC CCAGCCTTGG GGGACAGAGC ATGACAGAGC GCCAGGCTTT ATCTTATCAA
    AATGCTGACT CTTATCACCA TCACACCAGC CCCCAGCATC TGCTACAAAT CAGGGCACAA
    GAATGTGTCT CACAGGCTTC CTCACCCACC CCGCCCCACG GGTATGCTCA CCAGCCGGCA
    CTGATGCATT CAGAGAGCAT GGAGGAGGAC TGCTCGTGTG AGGGGGCCAA GGATGGCTTC
    CAAGACAGTA AGAGTTCAAG TACATTGACC AAAGGTTGCC ATGACAGCCC TCTGCTCTTG
    AGTACCGGTG GACCTGGGGA CCCTGAATCT TTGCTAGGAA CTGTGAGTCA TGCCCAAGAA
    TTGGGGATAC ATCCCTATGG TCATCAGCCG ACTGCTGCAT TCAGTAAAAA TAAGGTGCCC
    AGCAGAGAGC CTGTCATAGG GAACTGCATG GATAGAAGTT CTCCAGGACA AGCAGTGGAG
    CTGCCGGATC ACAATGGGCT CGGGTACCCA GCACGCCCCT CCGTCCATGA GCACCACAGG
    CCCCGGGCCC TCCAGAGACA CCACACGATC CAGAACAGCG ACGATGCTTA TGTACAGCTG
    GATAACTTGC CAGGAATGAG TCTCGTGGCT GGGAAAGCAC TTAGCTCTGC CCGGATGTCG
    GATGCAGTTC TCAGTCAGTC TTCGCTCATG GGCAGCCAGC AGTTTCAGGA TGGGGAAAAT
    GAGGAATGTG GGGCAAGCCT GGGAGGTCAT GAGCACCCAG ACCTGAGCGA TGGCAGCCAG
    CATTTAAACT CCTCTTGCTA TCCATCTACG TGTATTACAG ACATTCTGCT CAGCTACAAG
    CACCCCGAAG TCTCCTTCAG CATGGAGCAG GCAGGCGTGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971771.1
    CDS72..3653
    Translation

    Target ORF information:

    RefSeq Version XM_008973523.3
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973523.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG GTACTTGGCA AATAGGTCCA AAAGACATAC ACTGGCCATG
    ACCAACCCTA CAGCTGAGAT CCCACCGGAC CTACAACGGC AGCTAGGACA GCAGCCTTTC
    CGTTCCCGGG TCTGGCCTCC TCACCTGGTA CCTGATCAGC ATCGCTCTAC CTACAAGGAC
    TCCAACACTC TGCACCTCCC TACGGAGCGT TTCTCCCCTG TGCGCCGGTT CTCAGATGGG
    GCTGCGAGCA TCCAGGCCTT CAAAGCTCAC CTGGAAAAAA TGGGCAACAA CAGCAGCATC
    AAACAGCTGC AGCAGGAGTG TGAGCAGCTG CAGAAGATGT ACGGGGGGCA GATTGATGAA
    AGAACCCTGG AGAAGACCCA GCAGCAGCAT ATGTTATACC AGCAGGAGCA GCACCATCAA
    ATTCTCCAGC AACAAATTCA AGACTCTATC TGTCCTCCTC AGCCATCTCC ACCTCTTCAG
    GCTGCATGTG AAAATCAGCC AGCCCTCCTT ACCCATCAGC TCCAGAGGTT AAGGATTCAG
    CCTTCAAGCC CACCCCCCAA CCACCCCAAC AACCATCTCT TCAGGCAGCC CAGTAATAGT
    CCTCCCCCCA TGAGCAGTGC CATGATCCAG CCTCACGGGG CTGCATCTTC TTCCCAGTTT
    CAAGGCTTAC CTTCCCGCAG TGCAATCTTT CAGCAGCAAC CTGAGAACTG TTCCTCTCCT
    CCCAACGTGG CACTAACCTG CTTGGGTATG CAGCAGCCTG CTCAGTCACA GCAGGTCACC
    ATCCAAGTCC AAGAGCCTGT TGACATGCTC AGCAACATGC CAGGCACAGC TGCAGGCTCC
    AGTGGGCGCG GCATCTCCAT CAGCCCCAGT GCCGGTCAGA TGCAGATGCA GCACCGTACC
    AACCTGATGG CCACCCTCAG CTATGGGCAC CGTCCCTTGT CCAAGCAGCT GAGTGCTGAC
    AGTGCAGAGG CTCACAGTGC ACATCAGCAG CCGCCACACT ATACCACGTC GGCACTACAG
    CAGGCCCTGC TGTCTCCCAC GCCGCCAGAC TATACAAGAC ACCAGCAGGT ACCCCACATC
    CTTCAAGGAC TGCTTTCTCC CCGGCATTCG CTCACCGGCC ACTCGGACAT CCGGCTGCCC
    CCAACAGAGT TTGCACAGCT CATTAAAAGG CAGCAGCAAC AACGGCAGCA GCAGCAGCAA
    CAGCAGCAAC AGCAAGAATA CCAGGAACTG TTCAGGCACA TGAACCAAGG GGATGCGGGG
    AGTCTGGCTC CCAGCCTTGG GGGACAGAGC ATGACAGAGC GCCAGGCTTT ATCTTATCAA
    AATGCTGACT CTTATCACCA TCACACCAGC CCCCAGCATC TGCTACAAAT CAGGGCACAA
    GAATGTGTCT CACAGGCTTC CTCACCCACC CCGCCCCACG GGTATGCTCA CCAGCCGGCA
    CTGATGCATT CAGAGAGCAT GGAGGAGGAC TGCTCGTGTG AGGGGGCCAA GGATGGCTTC
    CAAGACAGTA AGAGTTCAAG TACATTGACC AAAGGTTGCC ATGACAGCCC TCTGCTCTTG
    AGTACCGGTG GACCTGGGGA CCCTGAATCT TTGCTAGGAA CTGTGAGTCA TGCCCAAGAA
    TTGGGGATAC ATCCCTATGG TCATCAGCCG ACTGCTGCAT TCAGTAAAAA TAAGGTGCCC
    AGCAGAGAGC CTGTCATAGG GAACTGCATG GATAGAAGTT CTCCAGGACA AGCAGTGGAG
    CTGCCGGATC ACAATGGGCT CGGGTACCCA GCACGCCCCT CCGTCCATGA GCACCACAGG
    CCCCGGGCCC TCCAGAGACA CCACACGATC CAGAACAGCG ACGATGCTTA TGTACAGCTG
    GATAACTTGC CAGGAATGAG TCTCGTGGCT GGGAAAGCAC TTAGCTCTGC CCGGATGTCG
    GATGCAGTTC TCAGTCAGTC TTCGCTCATG GGCAGCCAGC AGTTTCAGGA TGGGGAAAAT
    GAGGAATGTG GGGCAAGCCT GGGAGGTCAT GAGCACCCAG ACCTGAGCGA TGGCAGCCAG
    CATTTAAACT CCTCTTGCTA TCCATCTACG TGTATTACAG ACATTCTGCT CAGCTACAAG
    CACCCCGAAG TCTCCTTCAG CATGGAGCAG GCAGGCGTGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa61280
    Clone ID Related Accession (Same CDS sequence) XM_008973523.3 , XM_008973523.2
    Accession Version XM_008973523.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3582bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014158.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_008973523.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG GTACTTGGCA AATAGGTCCA AAAGACATAC ACTGGCCATG
    ACCAACCCTA CAGCTGAGAT CCCACCGGAC CTACAACGGC AGCTAGGACA GCAGCCTTTC
    CGTTCCCGGG TCTGGCCTCC TCACCTGGTA CCTGATCAGC ATCGCTCTAC CTACAAGGAC
    TCCAACACTC TGCACCTCCC TACGGAGCGT TTCTCCCCTG TGCGCCGGTT CTCAGATGGG
    GCTGCGAGCA TCCAGGCCTT CAAAGCTCAC CTGGAAAAAA TGGGCAACAA CAGCAGCATC
    AAACAGCTGC AGCAGGAGTG TGAGCAGCTG CAGAAGATGT ACGGGGGGCA GATTGATGAA
    AGAACCCTGG AGAAGACCCA GCAGCAGCAT ATGTTATACC AGCAGGAGCA GCACCATCAA
    ATTCTCCAGC AACAAATTCA AGACTCTATC TGTCCTCCTC AGCCATCTCC ACCTCTTCAG
    GCTGCATGTG AAAATCAGCC AGCCCTCCTT ACCCATCAGC TCCAGAGGTT AAGGATTCAG
    CCTTCAAGCC CACCCCCCAA CCACCCCAAC AACCATCTCT TCAGGCAGCC CAGTAATAGT
    CCTCCCCCCA TGAGCAGTGC CATGATCCAG CCTCACGGGG CTGCATCTTC TTCCCAGTTT
    CAAGGCTTAC CTTCCCGCAG TGCAATCTTT CAGCAGCAAC CTGAGAACTG TTCCTCTCCT
    CCCAACGTGG CACTAACCTG CTTGGGTATG CAGCAGCCTG CTCAGTCACA GCAGGTCACC
    ATCCAAGTCC AAGAGCCTGT TGACATGCTC AGCAACATGC CAGGCACAGC TGCAGGCTCC
    AGTGGGCGCG GCATCTCCAT CAGCCCCAGT GCCGGTCAGA TGCAGATGCA GCACCGTACC
    AACCTGATGG CCACCCTCAG CTATGGGCAC CGTCCCTTGT CCAAGCAGCT GAGTGCTGAC
    AGTGCAGAGG CTCACAGTGC ACATCAGCAG CCGCCACACT ATACCACGTC GGCACTACAG
    CAGGCCCTGC TGTCTCCCAC GCCGCCAGAC TATACAAGAC ACCAGCAGGT ACCCCACATC
    CTTCAAGGAC TGCTTTCTCC CCGGCATTCG CTCACCGGCC ACTCGGACAT CCGGCTGCCC
    CCAACAGAGT TTGCACAGCT CATTAAAAGG CAGCAGCAAC AACGGCAGCA GCAGCAGCAA
    CAGCAGCAAC AGCAAGAATA CCAGGAACTG TTCAGGCACA TGAACCAAGG GGATGCGGGG
    AGTCTGGCTC CCAGCCTTGG GGGACAGAGC ATGACAGAGC GCCAGGCTTT ATCTTATCAA
    AATGCTGACT CTTATCACCA TCACACCAGC CCCCAGCATC TGCTACAAAT CAGGGCACAA
    GAATGTGTCT CACAGGCTTC CTCACCCACC CCGCCCCACG GGTATGCTCA CCAGCCGGCA
    CTGATGCATT CAGAGAGCAT GGAGGAGGAC TGCTCGTGTG AGGGGGCCAA GGATGGCTTC
    CAAGACAGTA AGAGTTCAAG TACATTGACC AAAGGTTGCC ATGACAGCCC TCTGCTCTTG
    AGTACCGGTG GACCTGGGGA CCCTGAATCT TTGCTAGGAA CTGTGAGTCA TGCCCAAGAA
    TTGGGGATAC ATCCCTATGG TCATCAGCCG ACTGCTGCAT TCAGTAAAAA TAAGGTGCCC
    AGCAGAGAGC CTGTCATAGG GAACTGCATG GATAGAAGTT CTCCAGGACA AGCAGTGGAG
    CTGCCGGATC ACAATGGGCT CGGGTACCCA GCACGCCCCT CCGTCCATGA GCACCACAGG
    CCCCGGGCCC TCCAGAGACA CCACACGATC CAGAACAGCG ACGATGCTTA TGTACAGCTG
    GATAACTTGC CAGGAATGAG TCTCGTGGCT GGGAAAGCAC TTAGCTCTGC CCGGATGTCG
    GATGCAGTTC TCAGTCAGTC TTCGCTCATG GGCAGCCAGC AGTTTCAGGA TGGGGAAAAT
    GAGGAATGTG GGGCAAGCCT GGGAGGTCAT GAGCACCCAG ACCTGAGCGA TGGCAGCCAG
    CATTTAAACT CCTCTTGCTA TCCATCTACG TGTATTACAG ACATTCTGCT CAGCTACAAG
    CACCCCGAAG TCTCCTTCAG CATGGAGCAG GCAGGCGTGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971771.1
    CDS72..3653
    Translation

    Target ORF information:

    RefSeq Version XM_008973523.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973523.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    3481
    3541
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG GTACTTGGCA AATAGGTCCA AAAGACATAC ACTGGCCATG
    ACCAACCCTA CAGCTGAGAT CCCACCGGAC CTACAACGGC AGCTAGGACA GCAGCCTTTC
    CGTTCCCGGG TCTGGCCTCC TCACCTGGTA CCTGATCAGC ATCGCTCTAC CTACAAGGAC
    TCCAACACTC TGCACCTCCC TACGGAGCGT TTCTCCCCTG TGCGCCGGTT CTCAGATGGG
    GCTGCGAGCA TCCAGGCCTT CAAAGCTCAC CTGGAAAAAA TGGGCAACAA CAGCAGCATC
    AAACAGCTGC AGCAGGAGTG TGAGCAGCTG CAGAAGATGT ACGGGGGGCA GATTGATGAA
    AGAACCCTGG AGAAGACCCA GCAGCAGCAT ATGTTATACC AGCAGGAGCA GCACCATCAA
    ATTCTCCAGC AACAAATTCA AGACTCTATC TGTCCTCCTC AGCCATCTCC ACCTCTTCAG
    GCTGCATGTG AAAATCAGCC AGCCCTCCTT ACCCATCAGC TCCAGAGGTT AAGGATTCAG
    CCTTCAAGCC CACCCCCCAA CCACCCCAAC AACCATCTCT TCAGGCAGCC CAGTAATAGT
    CCTCCCCCCA TGAGCAGTGC CATGATCCAG CCTCACGGGG CTGCATCTTC TTCCCAGTTT
    CAAGGCTTAC CTTCCCGCAG TGCAATCTTT CAGCAGCAAC CTGAGAACTG TTCCTCTCCT
    CCCAACGTGG CACTAACCTG CTTGGGTATG CAGCAGCCTG CTCAGTCACA GCAGGTCACC
    ATCCAAGTCC AAGAGCCTGT TGACATGCTC AGCAACATGC CAGGCACAGC TGCAGGCTCC
    AGTGGGCGCG GCATCTCCAT CAGCCCCAGT GCCGGTCAGA TGCAGATGCA GCACCGTACC
    AACCTGATGG CCACCCTCAG CTATGGGCAC CGTCCCTTGT CCAAGCAGCT GAGTGCTGAC
    AGTGCAGAGG CTCACAGTGC ACATCAGCAG CCGCCACACT ATACCACGTC GGCACTACAG
    CAGGCCCTGC TGTCTCCCAC GCCGCCAGAC TATACAAGAC ACCAGCAGGT ACCCCACATC
    CTTCAAGGAC TGCTTTCTCC CCGGCATTCG CTCACCGGCC ACTCGGACAT CCGGCTGCCC
    CCAACAGAGT TTGCACAGCT CATTAAAAGG CAGCAGCAAC AACGGCAGCA GCAGCAGCAA
    CAGCAGCAAC AGCAAGAATA CCAGGAACTG TTCAGGCACA TGAACCAAGG GGATGCGGGG
    AGTCTGGCTC CCAGCCTTGG GGGACAGAGC ATGACAGAGC GCCAGGCTTT ATCTTATCAA
    AATGCTGACT CTTATCACCA TCACACCAGC CCCCAGCATC TGCTACAAAT CAGGGCACAA
    GAATGTGTCT CACAGGCTTC CTCACCCACC CCGCCCCACG GGTATGCTCA CCAGCCGGCA
    CTGATGCATT CAGAGAGCAT GGAGGAGGAC TGCTCGTGTG AGGGGGCCAA GGATGGCTTC
    CAAGACAGTA AGAGTTCAAG TACATTGACC AAAGGTTGCC ATGACAGCCC TCTGCTCTTG
    AGTACCGGTG GACCTGGGGA CCCTGAATCT TTGCTAGGAA CTGTGAGTCA TGCCCAAGAA
    TTGGGGATAC ATCCCTATGG TCATCAGCCG ACTGCTGCAT TCAGTAAAAA TAAGGTGCCC
    AGCAGAGAGC CTGTCATAGG GAACTGCATG GATAGAAGTT CTCCAGGACA AGCAGTGGAG
    CTGCCGGATC ACAATGGGCT CGGGTACCCA GCACGCCCCT CCGTCCATGA GCACCACAGG
    CCCCGGGCCC TCCAGAGACA CCACACGATC CAGAACAGCG ACGATGCTTA TGTACAGCTG
    GATAACTTGC CAGGAATGAG TCTCGTGGCT GGGAAAGCAC TTAGCTCTGC CCGGATGTCG
    GATGCAGTTC TCAGTCAGTC TTCGCTCATG GGCAGCCAGC AGTTTCAGGA TGGGGAAAAT
    GAGGAATGTG GGGCAAGCCT GGGAGGTCAT GAGCACCCAG ACCTGAGCGA TGGCAGCCAG
    CATTTAAACT CCTCTTGCTA TCCATCTACG TGTATTACAG ACATTCTGCT CAGCTACAAG
    CACCCCGAAG TCTCCTTCAG CATGGAGCAG GCAGGCGTGT AA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa61281
    Clone ID Related Accession (Same CDS sequence) XM_008973524.2
    Accession Version XM_008973524.2 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3438bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027879.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_008973524.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGGCG GAGCAGGCAG GTACTGCTAT GAACATCAGC
    GTTCCCCAGG TGCAGCTGAT CAACCCAGAG AACCAAATTG TGGAGCCGGA TGGGACACTG
    AATTTGGACA GTGATGAGGG TGAAGAGCCT TCCCCGGAAG CATTGGTGCG CTATTTGTCA
    ATGAGGAGGC ACACAGTGGG TGTGGCTGAC CCACGCACGG AAGTTATGGA AGATCTGCAG
    AAGCTCCTAC CTGGCTTTCC TGGAGTCAAC CCCCAGGCTC CATTCCTGCA GGTGGCCCCT
    AATGTGAACT TCATGCACAA CCTGTTGCCT ATGCAAAATT TGCAACCAAC CGGGCAACTT
    GAGTACAAGG AGCAGTCTCT CCTACAGCCG CCCACGCTAC AGCTGTTGAA TGGAATGGGC
    CCCCTTGGCC GGAGGGCATC AGATGGAGGA GCCAACATCC AACTGCATGC CCAGCAGCTG
    CTGAAGCGCC CACGGGGACC CTCTCCGCTT GTCACCATGA CACCAGCAGT GCCAGCAGTT
    ACCCCTGTGG ACGAGGAGAG CTCGGACGGG GAGCCAGACC AGGAAGCTGT GCAGAGGTAC
    TTGGCAAATA GGTCCAAAAG ACATACACTG GCCATGACCA ACCCTACAGC TGAGATCCCA
    CCGGACCTAC AACGGCAGCT AGGACAGCAG CCTTTCCGTT CCCGGGTCTG GCCTCCTCAC
    CTGGTACCTG ATCAGCATCG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971772.1
    CDS70..3507
    Translation

    Target ORF information:

    RefSeq Version XM_008973524.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973524.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGGCG GAGCAGGCAG GTACTGCTAT GAACATCAGC
    GTTCCCCAGG TGCAGCTGAT CAACCCAGAG AACCAAATTG TGGAGCCGGA TGGGACACTG
    AATTTGGACA GTGATGAGGG TGAAGAGCCT TCCCCGGAAG CATTGGTGCG CTATTTGTCA
    ATGAGGAGGC ACACAGTGGG TGTGGCTGAC CCACGCACGG AAGTTATGGA AGATCTGCAG
    AAGCTCCTAC CTGGCTTTCC TGGAGTCAAC CCCCAGGCTC CATTCCTGCA GGTGGCCCCT
    AATGTGAACT TCATGCACAA CCTGTTGCCT ATGCAAAATT TGCAACCAAC CGGGCAACTT
    GAGTACAAGG AGCAGTCTCT CCTACAGCCG CCCACGCTAC AGCTGTTGAA TGGAATGGGC
    CCCCTTGGCC GGAGGGCATC AGATGGAGGA GCCAACATCC AACTGCATGC CCAGCAGCTG
    CTGAAGCGCC CACGGGGACC CTCTCCGCTT GTCACCATGA CACCAGCAGT GCCAGCAGTT
    ACCCCTGTGG ACGAGGAGAG CTCGGACGGG GAGCCAGACC AGGAAGCTGT GCAGAGGTAC
    TTGGCAAATA GGTCCAAAAG ACATACACTG GCCATGACCA ACCCTACAGC TGAGATCCCA
    CCGGACCTAC AACGGCAGCT AGGACAGCAG CCTTTCCGTT CCCGGGTCTG GCCTCCTCAC
    CTGGTACCTG ATCAGCATCG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa61282
    Clone ID Related Accession (Same CDS sequence) XM_008973525.2 , XM_008973525.3
    Accession Version XM_008973525.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3438bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014158.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_008973525.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971773.1
    CDS72..3509
    Translation

    Target ORF information:

    RefSeq Version XM_008973525.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973525.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa61282
    Clone ID Related Accession (Same CDS sequence) XM_008973525.2 , XM_008973525.3
    Accession Version XM_008973525.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 3438bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product serine/threonine-protein kinase SIK3 isoform X6
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027879.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008973525.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008971773.1
    CDS72..3509
    Translation

    Target ORF information:

    RefSeq Version XM_008973525.3
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus SIK family kinase 3 (SIK3), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008973525.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    3001
    3061
    3121
    3181
    3241
    3301
    3361
    3421
    ATGAAGATGC TTTGCCACCC CCATATCATC AGGCTCTACC AGGTTATGGA GACAGAACGG 
    ATGATTTATC TGGTGACAGA ATATGCTAGT GGAGGGGAAA TATTTGACCA CCTGGTGGCC
    CATGGTAGAA TGGCAGAAAA GGAGGCACGT CGGAAGTTCA AACAGATCGT CACAGCTGTC
    TATTTTTGTC ACTGTCGGAA CATTGTTCAT CGTGATTTAA AAGCTGAAAA TTTACTTCTG
    GATGCCAATC TGAATATCAA AATAGCAGAT TTTGGTTTCA GTAACCTCTT CACTCCTGGG
    CAGCTGCTGA AGACCTGGTG TGGCAGCCCT CCCTATGCTG CACCTGAACT CTTTGAAGGA
    AAAGAATATG ATGGGCCCAA AGTGGACATC TGGAGCCTTG GAGTTGTCCT CTACGTGCTT
    GTGTGCGGTG CCCTGCCGTT TGATGGAAGC ACACTGCAGA ATCTGCGGGC CCGCGTGCTG
    AGTGGAAAGT TCCGCATCCC ATTTTTTATG TCCACAGAAT GTGAGCATTT GATCCGCCAT
    ATGTTGGTGT TAGATCCCAA TAAGCGCCTC TCCATGGAGC AGATCTGCAA GCACAAGTGG
    ATGAAGCTAG GGGACGCCGA TCCCAACTTT GACAGGTTAA TAGCTGAATG CCAGCAACTA
    AAGGAAGAAA GACAGGTGGA CCCCCTGAAT GAGGATGTCC TCTTGGCCAT GGAGGACATG
    GGACTGGACA AAGAACAGAC ACTGCAGTCA TTAAGATCAG ATGCCTATGA TCACTATAGT
    GCAATCTACA GCCTGCTGTG TGATCGACAT AAGAGACATA AAACCCTGCG TCTCGGAGCA
    CTTCCTAGCA TGCCCCGAGC CCTGGCCTTT CAAGCACCAG TCAATATCCA GGCGGAGCAG
    GCAGGTACTG CTATGAACAT CAGCGTTCCC CAGGTGCAGC TGATCAACCC AGAGAACCAA
    ATTGTGGAGC CGGATGGGAC ACTGAATTTG GACAGTGATG AGGGTGAAGA GCCTTCCCCG
    GAAGCATTGG TGCGCTATTT GTCAATGAGG AGGCACACAG TGGGTGTGGC TGACCCACGC
    ACGGAAGTTA TGGAAGATCT GCAGAAGCTC CTACCTGGCT TTCCTGGAGT CAACCCCCAG
    GCTCCATTCC TGCAGGTGGC CCCTAATGTG AACTTCATGC ACAACCTGTT GCCTATGCAA
    AATTTGCAAC CAACCGGGCA ACTTGAGTAC AAGGAGCAGT CTCTCCTACA GCCGCCCACG
    CTACAGCTGT TGAATGGAAT GGGCCCCCTT GGCCGGAGGG CATCAGATGG AGGAGCCAAC
    ATCCAACTGC ATGCCCAGCA GCTGCTGAAG CGCCCACGGG GACCCTCTCC GCTTGTCACC
    ATGACACCAG CAGTGCCAGC AGTTACCCCT GTGGACGAGG AGAGCTCGGA CGGGGAGCCA
    GACCAGGAAG CTGTGCAGAG CTCTACCTAC AAGGACTCCA ACACTCTGCA CCTCCCTACG
    GAGCGTTTCT CCCCTGTGCG CCGGTTCTCA GATGGGGCTG CGAGCATCCA GGCCTTCAAA
    GCTCACCTGG AAAAAATGGG CAACAACAGC AGCATCAAAC AGCTGCAGCA GGAGTGTGAG
    CAGCTGCAGA AGATGTACGG GGGGCAGATT GATGAAAGAA CCCTGGAGAA GACCCAGCAG
    CAGCATATGT TATACCAGCA GGAGCAGCAC CATCAAATTC TCCAGCAACA AATTCAAGAC
    TCTATCTGTC CTCCTCAGCC ATCTCCACCT CTTCAGGCTG CATGTGAAAA TCAGCCAGCC
    CTCCTTACCC ATCAGCTCCA GAGGTTAAGG ATTCAGCCTT CAAGCCCACC CCCCAACCAC
    CCCAACAACC ATCTCTTCAG GCAGCCCAGT AATAGTCCTC CCCCCATGAG CAGTGCCATG
    ATCCAGCCTC ACGGGGCTGC ATCTTCTTCC CAGTTTCAAG GCTTACCTTC CCGCAGTGCA
    ATCTTTCAGC AGCAACCTGA GAACTGTTCC TCTCCTCCCA ACGTGGCACT AACCTGCTTG
    GGTATGCAGC AGCCTGCTCA GTCACAGCAG GTCACCATCC AAGTCCAAGA GCCTGTTGAC
    ATGCTCAGCA ACATGCCAGG CACAGCTGCA GGCTCCAGTG GGCGCGGCAT CTCCATCAGC
    CCCAGTGCCG GTCAGATGCA GATGCAGCAC CGTACCAACC TGATGGCCAC CCTCAGCTAT
    GGGCACCGTC CCTTGTCCAA GCAGCTGAGT GCTGACAGTG CAGAGGCTCA CAGTGCACAT
    CAGCAGCCGC CACACTATAC CACGTCGGCA CTACAGCAGG CCCTGCTGTC TCCCACGCCG
    CCAGACTATA CAAGACACCA GCAGGTACCC CACATCCTTC AAGGACTGCT TTCTCCCCGG
    CATTCGCTCA CCGGCCACTC GGACATCCGG CTGCCCCCAA CAGAGTTTGC ACAGCTCATT
    AAAAGGCAGC AGCAACAACG GCAGCAGCAG CAGCAACAGC AGCAACAGCA AGAATACCAG
    GAACTGTTCA GGCACATGAA CCAAGGGGAT GCGGGGAGTC TGGCTCCCAG CCTTGGGGGA
    CAGAGCATGA CAGAGCGCCA GGCTTTATCT TATCAAAATG CTGACTCTTA TCACCATCAC
    ACCAGCCCCC AGCATCTGCT ACAAATCAGG GCACAAGAAT GTGTCTCACA GGCTTCCTCA
    CCCACCCCGC CCCACGGGTA TGCTCACCAG CCGGCACTGA TGCATTCAGA GAGCATGGAG
    GAGGACTGCT CGTGTGAGGG GGCCAAGGAT GGCTTCCAAG ACAGTAAGAG TTCAAGTACA
    TTGACCAAAG GTTGCCATGA CAGCCCTCTG CTCTTGAGTA CCGGTGGACC TGGGGACCCT
    GAATCTTTGC TAGGAACTGT GAGTCATGCC CAAGAATTGG GGATACATCC CTATGGTCAT
    CAGCCGACTG CTGCATTCAG TAAAAATAAG GTGCCCAGCA GAGAGCCTGT CATAGGGAAC
    TGCATGGATA GAAGTTCTCC AGGACAAGCA GTGGAGCTGC CGGATCACAA TGGGCTCGGG
    TACCCAGCAC GCCCCTCCGT CCATGAGCAC CACAGGCCCC GGGCCCTCCA GAGACACCAC
    ACGATCCAGA ACAGCGACGA TGCTTATGTA CAGCTGGATA ACTTGCCAGG AATGAGTCTC
    GTGGCTGGGA AAGCACTTAG CTCTGCCCGG ATGTCGGATG CAGTTCTCAG TCAGTCTTCG
    CTCATGGGCA GCCAGCAGTT TCAGGATGGG GAAAATGAGG AATGTGGGGC AAGCCTGGGA
    GGTCATGAGC ACCCAGACCT GAGCGATGGC AGCCAGCATT TAAACTCCTC TTGCTATCCA
    TCTACGTGTA TTACAGACAT TCTGCTCAGC TACAAGCACC CCGAAGTCTC CTTCAGCATG
    GAGCAGGCAG GCGTGTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.