ZNF473 cDNA ORF clone, Pan paniscus(pygmy chimpanzee)

The following ZNF473 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the ZNF473 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPa72576 XM_008967003.3
Latest version!
Pan paniscus zinc finger protein 473 (ZNF473), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
View Old Accession Versions >>
OPa72576 XM_008967003.2 Pan paniscus zinc finger protein 473 (ZNF473), mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $510.30
$729.00
Hide Old Accession Versions >>

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPa72576
    Clone ID Related Accession (Same CDS sequence) XM_008967003.3 , XM_008967003.2
    Accession Version XM_008967003.3 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2616bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
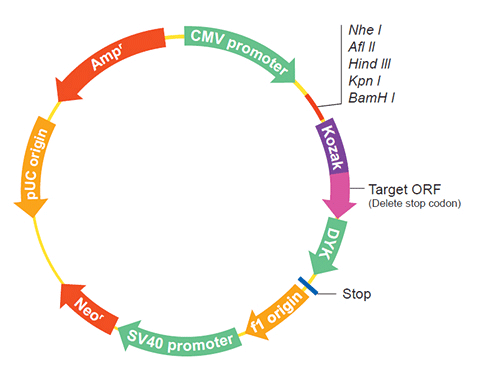
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2018-04-30
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 473
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NC_027887.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On May 1, 2018 this sequence version replaced XM_008967003.2. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Pan paniscus Annotation Release 103 Annotation Version :: 103 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.0 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGCTGAGG AATTTGTGAC CCTCAAGGAT GTCGGCATGG ACTTCACCTT GGGAGACTGG 
    GAGCAGCTCG GGCTGGAACA GGGGGACACG TTCTGGGACA CAGCGTTGGA CAATTGCCAG
    GACCTCTTCC TGCTGGACCC CCCAAGACCC AACCTGACCT CCCACCCAGA TGGCGGTGAA
    GATCTGGAGC CTCTGGCAGG AGGAAGCCCA GAAGCAACAG GCCCTGATGT GACTGAGACC
    AAGAACTCTC CTCTGATGGA GGATTTCTTC GAAGAAGGAT TCTCCCAGGA GATTATAGAG
    ATGTTATCCA AGGATGGCTT CTGGAACTCC AATTTCGGAG AAGCCTGTAT AGAGGACACC
    TGGTTAGATA GTTTGCTAGG CAATCCAGAA AGTCTTCTGA GGTCTGATAT TGCCACCAAC
    GGGGAAAGTC CCACGGAATG CAAGAGTCAT GAATTAAAGA GAGGACTCAG TCCTGTGTCC
    ACCGTTTCCA CGGGAGAAGA TTCCATGGTG CATAATGTTT CTGAAAAGAC CCTCACACCA
    GCTAAGTCTA AGGAATATAG GGGTGAGTTT GTCTCCTACT CCGACCACAG CCAGCAGGAT
    TCTGTTCAGG AAGGGGAGAA ACCATATCAA TGTAGTGAAT GTGGGAAAAG CTTCAGTGGG
    AGTTACCGTC TTACCCAGCA CTGGATCACT CATACTGGGG AGAAACCCAC TGTCCATCAA
    GAGTGTGAGC AAGGTTTTGA CCAGAATGCT TCCCTTTCTG TGTATCCGAA AACTCACACG
    GGCTACAAAT TCTATGTGTG TAATGAATAT GGGACAACTT TTAGTCAGAG TACATACCTG
    TGGCATCAGA AAACTCACAC TGGAGAAAAA CCATGTAAGA GTCAAGATAG TGACCACCCA
    CCCAGTCATG ACACACAGCC TGGTGAGCAT CAGAAAACTC ACACAGATAG TAAGTCCTAC
    AACTGTAACG AATGCGGCAA GGCTTTCACC CGGATCTTCC ACCTTACTCG GCACCAGAAG
    ATCCACACTC GGAAACGCTA TGAGTGTTCC AAGTGCCAGG CGACTTTCAA CTTGAGAAAA
    CACCTCATCC AACATCAGAA AACTCACGCT GCAAAAACTA CCTCTGAGTG TCAGGAGTGT
    GGGAAGATTT TTAGGCACAG TTCACTGCTC ATTGAACACC AGGCTCTTCA TGCTGGAGAG
    GAGCCTTATA AGTGTAACAA ACGTGGGAAA TCCTTCAGGC ATAACTCTTC CCTAAAGATC
    CATCAGAGGG TTCACAGTGG AGAGAAGCCT TACAAATGCA GTGAGTGTGG GAAGGCCTTC
    CACCGGCACA CTCACCTTAA TGAACATCGG CAAATTCATA CAGGCTACAG ACCCCACAAA
    TGTCAGGAAT GTGTCAGGAG TTTCAGCCGG CCCTCACATC TGATGCGACA TCAGGCCATT
    CACACCGCAG AAAAGCCCTA TAGCTGTGCT GAATGCAAGG AGACTTTCAG CGATAACAAT
    CGCCTTGTGC AACACCAGAA AATGCACACT GTCAAAACCC CATATGAATG TCAGGAGTGC
    GGAGAACGCT TCATTTGCGG CTCAACCCTG AAGTGCCACG AGAGTGTTCA CGCCAGAGAA
    AAACAAGGAT TTTTTGTGAG TGGGAAGATC TTGGATCAGA ACCCAGAACA GAAAGAGAAG
    TGCTTTAAGT GTAACAAATG TGAGAAAACC TTTAGCTGCA GCAAATACCT AACTCAGCAC
    GAGAGGATTC ACACCAGGGG GGTGAAGCCC TTTGAATGTG ACCAGTGTGG GAAAGCCTTT
    GGCCAAAGTA CTCGGCTCAT TTACCATCAA AGAATCCACT CTAGAGTGAG GCTGTATAAA
    TGGGGTGAGC AAGGGAAAGC CATCAGCAGT GCCTCCCTTA TCAAACTTCA GTCCTCCCAC
    ACAAAGGAGC ACCCTTTTAA ATGTAACGAA TGCGGAAAGA CCTTCAGCCA CAGTGCACAC
    CTCTCAAAAC ATCAGTTAAT TCACGCTGGA GAGAATCCCT TTAAATGTAG TAAGTGTGAC
    AGAGTCTTCA CCCAGAGAAA CGACCTTGTT CAGCATGAGC GAACTCATGC CAGAAAGAAG
    CCGTTGGTGT GTAACGAATG CGGGAAAACG TTCCATCAGA GCTCATGCCT TTCTAAGCAT
    CAGAGAATTC ACTCAGGTGA GAAGCCCTAT GTATGTGATT ACTGCGGGAA GGCCTTTGGC
    CTGAGTGCTG AGCTTGTCCG CCACCAGAGA ATTCACACTG GAGAAAAGCC TTATGTTTGT
    CAGGAATGCG GGAAAGCCTT CACCCAGAGC TCATGCCTTT CTATTCACCG GAGAGTTCAC
    ACTGGGGAGA AGCCCTACAG ATGTGGTGAA TGTGGGAAAG CCTTTGCCCA GAAAGCAAAT
    CTAACACAGC ACCAGAGAAT TCACACGGGG GAGAAGCCTT ACTCCTGTAA TGTGTGTGGC
    AAAGCTTTTG TCCTCAGTGC CCATCTCAAC CAGCACCTGA GAGTTCACAC CCAGGAGACA
    CTTTATCAGT GTCAACGTTG CCAGAAAGCC TTTCGGTGCC ACTCGAGCCT CAGCCGCCAT
    CAGCATGTAC ACAACAAGCA GCAATACTGC CTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008965251.1
    CDS435..3050
    Translation

    Target ORF information:

    RefSeq Version XM_008967003.3
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 473 (ZNF473), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008967003.3

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGCTGAGG AATTTGTGAC CCTCAAGGAT GTCGGCATGG ACTTCACCTT GGGAGACTGG 
    GAGCAGCTCG GGCTGGAACA GGGGGACACG TTCTGGGACA CAGCGTTGGA CAATTGCCAG
    GACCTCTTCC TGCTGGACCC CCCAAGACCC AACCTGACCT CCCACCCAGA TGGCGGTGAA
    GATCTGGAGC CTCTGGCAGG AGGAAGCCCA GAAGCAACAG GCCCTGATGT GACTGAGACC
    AAGAACTCTC CTCTGATGGA GGATTTCTTC GAAGAAGGAT TCTCCCAGGA GATTATAGAG
    ATGTTATCCA AGGATGGCTT CTGGAACTCC AATTTCGGAG AAGCCTGTAT AGAGGACACC
    TGGTTAGATA GTTTGCTAGG CAATCCAGAA AGTCTTCTGA GGTCTGATAT TGCCACCAAC
    GGGGAAAGTC CCACGGAATG CAAGAGTCAT GAATTAAAGA GAGGACTCAG TCCTGTGTCC
    ACCGTTTCCA CGGGAGAAGA TTCCATGGTG CATAATGTTT CTGAAAAGAC CCTCACACCA
    GCTAAGTCTA AGGAATATAG GGGTGAGTTT GTCTCCTACT CCGACCACAG CCAGCAGGAT
    TCTGTTCAGG AAGGGGAGAA ACCATATCAA TGTAGTGAAT GTGGGAAAAG CTTCAGTGGG
    AGTTACCGTC TTACCCAGCA CTGGATCACT CATACTGGGG AGAAACCCAC TGTCCATCAA
    GAGTGTGAGC AAGGTTTTGA CCAGAATGCT TCCCTTTCTG TGTATCCGAA AACTCACACG
    GGCTACAAAT TCTATGTGTG TAATGAATAT GGGACAACTT TTAGTCAGAG TACATACCTG
    TGGCATCAGA AAACTCACAC TGGAGAAAAA CCATGTAAGA GTCAAGATAG TGACCACCCA
    CCCAGTCATG ACACACAGCC TGGTGAGCAT CAGAAAACTC ACACAGATAG TAAGTCCTAC
    AACTGTAACG AATGCGGCAA GGCTTTCACC CGGATCTTCC ACCTTACTCG GCACCAGAAG
    ATCCACACTC GGAAACGCTA TGAGTGTTCC AAGTGCCAGG CGACTTTCAA CTTGAGAAAA
    CACCTCATCC AACATCAGAA AACTCACGCT GCAAAAACTA CCTCTGAGTG TCAGGAGTGT
    GGGAAGATTT TTAGGCACAG TTCACTGCTC ATTGAACACC AGGCTCTTCA TGCTGGAGAG
    GAGCCTTATA AGTGTAACAA ACGTGGGAAA TCCTTCAGGC ATAACTCTTC CCTAAAGATC
    CATCAGAGGG TTCACAGTGG AGAGAAGCCT TACAAATGCA GTGAGTGTGG GAAGGCCTTC
    CACCGGCACA CTCACCTTAA TGAACATCGG CAAATTCATA CAGGCTACAG ACCCCACAAA
    TGTCAGGAAT GTGTCAGGAG TTTCAGCCGG CCCTCACATC TGATGCGACA TCAGGCCATT
    CACACCGCAG AAAAGCCCTA TAGCTGTGCT GAATGCAAGG AGACTTTCAG CGATAACAAT
    CGCCTTGTGC AACACCAGAA AATGCACACT GTCAAAACCC CATATGAATG TCAGGAGTGC
    GGAGAACGCT TCATTTGCGG CTCAACCCTG AAGTGCCACG AGAGTGTTCA CGCCAGAGAA
    AAACAAGGAT TTTTTGTGAG TGGGAAGATC TTGGATCAGA ACCCAGAACA GAAAGAGAAG
    TGCTTTAAGT GTAACAAATG TGAGAAAACC TTTAGCTGCA GCAAATACCT AACTCAGCAC
    GAGAGGATTC ACACCAGGGG GGTGAAGCCC TTTGAATGTG ACCAGTGTGG GAAAGCCTTT
    GGCCAAAGTA CTCGGCTCAT TTACCATCAA AGAATCCACT CTAGAGTGAG GCTGTATAAA
    TGGGGTGAGC AAGGGAAAGC CATCAGCAGT GCCTCCCTTA TCAAACTTCA GTCCTCCCAC
    ACAAAGGAGC ACCCTTTTAA ATGTAACGAA TGCGGAAAGA CCTTCAGCCA CAGTGCACAC
    CTCTCAAAAC ATCAGTTAAT TCACGCTGGA GAGAATCCCT TTAAATGTAG TAAGTGTGAC
    AGAGTCTTCA CCCAGAGAAA CGACCTTGTT CAGCATGAGC GAACTCATGC CAGAAAGAAG
    CCGTTGGTGT GTAACGAATG CGGGAAAACG TTCCATCAGA GCTCATGCCT TTCTAAGCAT
    CAGAGAATTC ACTCAGGTGA GAAGCCCTAT GTATGTGATT ACTGCGGGAA GGCCTTTGGC
    CTGAGTGCTG AGCTTGTCCG CCACCAGAGA ATTCACACTG GAGAAAAGCC TTATGTTTGT
    CAGGAATGCG GGAAAGCCTT CACCCAGAGC TCATGCCTTT CTATTCACCG GAGAGTTCAC
    ACTGGGGAGA AGCCCTACAG ATGTGGTGAA TGTGGGAAAG CCTTTGCCCA GAAAGCAAAT
    CTAACACAGC ACCAGAGAAT TCACACGGGG GAGAAGCCTT ACTCCTGTAA TGTGTGTGGC
    AAAGCTTTTG TCCTCAGTGC CCATCTCAAC CAGCACCTGA GAGTTCACAC CCAGGAGACA
    CTTTATCAGT GTCAACGTTG CCAGAAAGCC TTTCGGTGCC ACTCGAGCCT CAGCCGCCAT
    CAGCATGTAC ACAACAAGCA GCAATACTGC CTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPa72576
    Clone ID Related Accession (Same CDS sequence) XM_008967003.3 , XM_008967003.2
    Accession Version XM_008967003.2 Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2616bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-29
    Organism Pan paniscus(pygmy chimpanzee)
    Product zinc finger protein 473
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_014014363.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process On Sep 30, 2015 this sequence version replaced XM_008967003.1. ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pan paniscus Annotation Release 102 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGCTGAGG AATTTGTGAC CCTCAAGGAT GTCGGCATGG ACTTCACCTT GGGAGACTGG 
    GAGCAGCTCG GGCTGGAACA GGGGGACACG TTCTGGGACA CAGCGTTGGA CAATTGCCAG
    GACCTCTTCC TGCTGGACCC CCCAAGACCC AACCTGACCT CCCACCCAGA TGGCGGTGAA
    GATCTGGAGC CTCTGGCAGG AGGAAGCCCA GAAGCAACAG GCCCTGATGT GACTGAGACC
    AAGAACTCTC CTCTGATGGA GGATTTCTTC GAAGAAGGAT TCTCCCAGGA GATTATAGAG
    ATGTTATCCA AGGATGGCTT CTGGAACTCC AATTTCGGAG AAGCCTGTAT AGAGGACACC
    TGGTTAGATA GTTTGCTAGG CAATCCAGAA AGTCTTCTGA GGTCTGATAT TGCCACCAAC
    GGGGAAAGTC CCACGGAATG CAAGAGTCAT GAATTAAAGA GAGGACTCAG TCCTGTGTCC
    ACCGTTTCCA CGGGAGAAGA TTCCATGGTG CATAATGTTT CTGAAAAGAC CCTCACACCA
    GCTAAGTCTA AGGAATATAG GGGTGAGTTT GTCTCCTACT CCGACCACAG CCAGCAGGAT
    TCTGTTCAGG AAGGGGAGAA ACCATATCAA TGTAGTGAAT GTGGGAAAAG CTTCAGTGGG
    AGTTACCGTC TTACCCAGCA CTGGATCACT CATACTGGGG AGAAACCCAC TGTCCATCAA
    GAGTGTGAGC AAGGTTTTGA CCAGAATGCT TCCCTTTCTG TGTATCCGAA AACTCACACG
    GGCTACAAAT TCTATGTGTG TAATGAATAT GGGACAACTT TTAGTCAGAG TACATACCTG
    TGGCATCAGA AAACTCACAC TGGAGAAAAA CCATGTAAGA GTCAAGATAG TGACCACCCA
    CCCAGTCATG ACACACAGCC TGGTGAGCAT CAGAAAACTC ACACAGATAG TAAGTCCTAC
    AACTGTAACG AATGCGGCAA GGCTTTCACC CGGATCTTCC ACCTTACTCG GCACCAGAAG
    ATCCACACTC GGAAACGCTA TGAGTGTTCC AAGTGCCAGG CGACTTTCAA CTTGAGAAAA
    CACCTCATCC AACATCAGAA AACTCACGCT GCAAAAACTA CCTCTGAGTG TCAGGAGTGT
    GGGAAGATTT TTAGGCACAG TTCACTGCTC ATTGAACACC AGGCTCTTCA TGCTGGAGAG
    GAGCCTTATA AGTGTAACAA ACGTGGGAAA TCCTTCAGGC ATAACTCTTC CCTAAAGATC
    CATCAGAGGG TTCACAGTGG AGAGAAGCCT TACAAATGCA GTGAGTGTGG GAAGGCCTTC
    CACCGGCACA CTCACCTTAA TGAACATCGG CAAATTCATA CAGGCTACAG ACCCCACAAA
    TGTCAGGAAT GTGTCAGGAG TTTCAGCCGG CCCTCACATC TGATGCGACA TCAGGCCATT
    CACACCGCAG AAAAGCCCTA TAGCTGTGCT GAATGCAAGG AGACTTTCAG CGATAACAAT
    CGCCTTGTGC AACACCAGAA AATGCACACT GTCAAAACCC CATATGAATG TCAGGAGTGC
    GGAGAACGCT TCATTTGCGG CTCAACCCTG AAGTGCCACG AGAGTGTTCA CGCCAGAGAA
    AAACAAGGAT TTTTTGTGAG TGGGAAGATC TTGGATCAGA ACCCAGAACA GAAAGAGAAG
    TGCTTTAAGT GTAACAAATG TGAGAAAACC TTTAGCTGCA GCAAATACCT AACTCAGCAC
    GAGAGGATTC ACACCAGGGG GGTGAAGCCC TTTGAATGTG ACCAGTGTGG GAAAGCCTTT
    GGCCAAAGTA CTCGGCTCAT TTACCATCAA AGAATCCACT CTAGAGTGAG GCTGTATAAA
    TGGGGTGAGC AAGGGAAAGC CATCAGCAGT GCCTCCCTTA TCAAACTTCA GTCCTCCCAC
    ACAAAGGAGC ACCCTTTTAA ATGTAACGAA TGCGGAAAGA CCTTCAGCCA CAGTGCACAC
    CTCTCAAAAC ATCAGTTAAT TCACGCTGGA GAGAATCCCT TTAAATGTAG TAAGTGTGAC
    AGAGTCTTCA CCCAGAGAAA CGACCTTGTT CAGCATGAGC GAACTCATGC CAGAAAGAAG
    CCGTTGGTGT GTAACGAATG CGGGAAAACG TTCCATCAGA GCTCATGCCT TTCTAAGCAT
    CAGAGAATTC ACTCAGGTGA GAAGCCCTAT GTATGTGATT ACTGCGGGAA GGCCTTTGGC
    CTGAGTGCTG AGCTTGTCCG CCACCAGAGA ATTCACACTG GAGAAAAGCC TTATGTTTGT
    CAGGAATGCG GGAAAGCCTT CACCCAGAGC TCATGCCTTT CTATTCACCG GAGAGTTCAC
    ACTGGGGAGA AGCCCTACAG ATGTGGTGAA TGTGGGAAAG CCTTTGCCCA GAAAGCAAAT
    CTAACACAGC ACCAGAGAAT TCACACGGGG GAGAAGCCTT ACTCCTGTAA TGTGTGTGGC
    AAAGCTTTTG TCCTCAGTGC CCATCTCAAC CAGCACCTGA GAGTTCACAC CCAGGAGACA
    CTTTATCAGT GTCAACGTTG CCAGAAAGCC TTTCGGTGCC ACTCGAGCCT CAGCCGCCAT
    CAGCATGTAC ACAACAAGCA GCAATACTGC CTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_008965251.1
    CDS524..3139
    Translation

    Target ORF information:

    RefSeq Version XM_008967003.2
    Organism Pan paniscus(pygmy chimpanzee)
    Definition Pan paniscus zinc finger protein 473 (ZNF473), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_008967003.2

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    ATGGCTGAGG AATTTGTGAC CCTCAAGGAT GTCGGCATGG ACTTCACCTT GGGAGACTGG 
    GAGCAGCTCG GGCTGGAACA GGGGGACACG TTCTGGGACA CAGCGTTGGA CAATTGCCAG
    GACCTCTTCC TGCTGGACCC CCCAAGACCC AACCTGACCT CCCACCCAGA TGGCGGTGAA
    GATCTGGAGC CTCTGGCAGG AGGAAGCCCA GAAGCAACAG GCCCTGATGT GACTGAGACC
    AAGAACTCTC CTCTGATGGA GGATTTCTTC GAAGAAGGAT TCTCCCAGGA GATTATAGAG
    ATGTTATCCA AGGATGGCTT CTGGAACTCC AATTTCGGAG AAGCCTGTAT AGAGGACACC
    TGGTTAGATA GTTTGCTAGG CAATCCAGAA AGTCTTCTGA GGTCTGATAT TGCCACCAAC
    GGGGAAAGTC CCACGGAATG CAAGAGTCAT GAATTAAAGA GAGGACTCAG TCCTGTGTCC
    ACCGTTTCCA CGGGAGAAGA TTCCATGGTG CATAATGTTT CTGAAAAGAC CCTCACACCA
    GCTAAGTCTA AGGAATATAG GGGTGAGTTT GTCTCCTACT CCGACCACAG CCAGCAGGAT
    TCTGTTCAGG AAGGGGAGAA ACCATATCAA TGTAGTGAAT GTGGGAAAAG CTTCAGTGGG
    AGTTACCGTC TTACCCAGCA CTGGATCACT CATACTGGGG AGAAACCCAC TGTCCATCAA
    GAGTGTGAGC AAGGTTTTGA CCAGAATGCT TCCCTTTCTG TGTATCCGAA AACTCACACG
    GGCTACAAAT TCTATGTGTG TAATGAATAT GGGACAACTT TTAGTCAGAG TACATACCTG
    TGGCATCAGA AAACTCACAC TGGAGAAAAA CCATGTAAGA GTCAAGATAG TGACCACCCA
    CCCAGTCATG ACACACAGCC TGGTGAGCAT CAGAAAACTC ACACAGATAG TAAGTCCTAC
    AACTGTAACG AATGCGGCAA GGCTTTCACC CGGATCTTCC ACCTTACTCG GCACCAGAAG
    ATCCACACTC GGAAACGCTA TGAGTGTTCC AAGTGCCAGG CGACTTTCAA CTTGAGAAAA
    CACCTCATCC AACATCAGAA AACTCACGCT GCAAAAACTA CCTCTGAGTG TCAGGAGTGT
    GGGAAGATTT TTAGGCACAG TTCACTGCTC ATTGAACACC AGGCTCTTCA TGCTGGAGAG
    GAGCCTTATA AGTGTAACAA ACGTGGGAAA TCCTTCAGGC ATAACTCTTC CCTAAAGATC
    CATCAGAGGG TTCACAGTGG AGAGAAGCCT TACAAATGCA GTGAGTGTGG GAAGGCCTTC
    CACCGGCACA CTCACCTTAA TGAACATCGG CAAATTCATA CAGGCTACAG ACCCCACAAA
    TGTCAGGAAT GTGTCAGGAG TTTCAGCCGG CCCTCACATC TGATGCGACA TCAGGCCATT
    CACACCGCAG AAAAGCCCTA TAGCTGTGCT GAATGCAAGG AGACTTTCAG CGATAACAAT
    CGCCTTGTGC AACACCAGAA AATGCACACT GTCAAAACCC CATATGAATG TCAGGAGTGC
    GGAGAACGCT TCATTTGCGG CTCAACCCTG AAGTGCCACG AGAGTGTTCA CGCCAGAGAA
    AAACAAGGAT TTTTTGTGAG TGGGAAGATC TTGGATCAGA ACCCAGAACA GAAAGAGAAG
    TGCTTTAAGT GTAACAAATG TGAGAAAACC TTTAGCTGCA GCAAATACCT AACTCAGCAC
    GAGAGGATTC ACACCAGGGG GGTGAAGCCC TTTGAATGTG ACCAGTGTGG GAAAGCCTTT
    GGCCAAAGTA CTCGGCTCAT TTACCATCAA AGAATCCACT CTAGAGTGAG GCTGTATAAA
    TGGGGTGAGC AAGGGAAAGC CATCAGCAGT GCCTCCCTTA TCAAACTTCA GTCCTCCCAC
    ACAAAGGAGC ACCCTTTTAA ATGTAACGAA TGCGGAAAGA CCTTCAGCCA CAGTGCACAC
    CTCTCAAAAC ATCAGTTAAT TCACGCTGGA GAGAATCCCT TTAAATGTAG TAAGTGTGAC
    AGAGTCTTCA CCCAGAGAAA CGACCTTGTT CAGCATGAGC GAACTCATGC CAGAAAGAAG
    CCGTTGGTGT GTAACGAATG CGGGAAAACG TTCCATCAGA GCTCATGCCT TTCTAAGCAT
    CAGAGAATTC ACTCAGGTGA GAAGCCCTAT GTATGTGATT ACTGCGGGAA GGCCTTTGGC
    CTGAGTGCTG AGCTTGTCCG CCACCAGAGA ATTCACACTG GAGAAAAGCC TTATGTTTGT
    CAGGAATGCG GGAAAGCCTT CACCCAGAGC TCATGCCTTT CTATTCACCG GAGAGTTCAC
    ACTGGGGAGA AGCCCTACAG ATGTGGTGAA TGTGGGAAAG CCTTTGCCCA GAAAGCAAAT
    CTAACACAGC ACCAGAGAAT TCACACGGGG GAGAAGCCTT ACTCCTGTAA TGTGTGTGGC
    AAAGCTTTTG TCCTCAGTGC CCATCTCAAC CAGCACCTGA GAGTTCACAC CCAGGAGACA
    CTTTATCAGT GTCAACGTTG CCAGAAAGCC TTTCGGTGCC ACTCGAGCCT CAGCCGCCAT
    CAGCATGTAC ACAACAAGCA GCAATACTGC CTGTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.