FOXP1 cDNA ORF clone, Pseudopodoces humilis(Tibetan ground-tit)

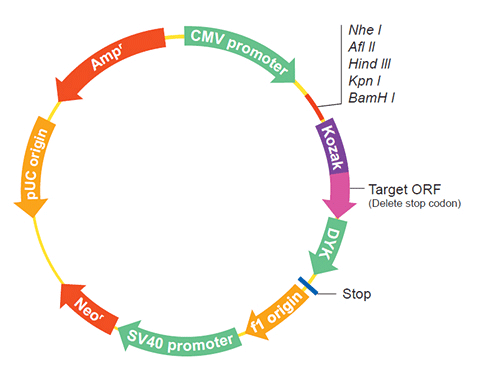
The following FOXP1 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the FOXP1 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OPs12608 XM_014251630.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X13, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPs12608 XM_014251628.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X11, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPs12608 XM_014251629.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X12, mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $342.30
$489.00
OPs12605 XM_014251623.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X6, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12605 XM_014251618.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X2, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12605 XM_014251621.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X5, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12605 XM_014251619.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X3, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12605 XM_014251625.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X8, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12605 XM_014251620.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X4, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12605 XM_014251624.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X7, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12605 XM_014251617.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X1, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12606 XM_014251626.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X9, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00
OPs12607 XM_014251627.1
Latest version!
Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X10, mRNA. pcDNA3.1-C-(k)DYK or customized vector TBD $426.30
$609.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OPs12608
    Clone ID Related Accession (Same CDS sequence) XM_014251630.1 , XM_014251628.1 , XM_014251629.1
    Accession Version XM_014251630.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1779bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGATGACAC CTCAAGTGAT CACTCCCCAG CAAATGCAGC AGATCCTCCA GCAACAAGTG 
    CTAACTCCCC AGCAACTCCA AGTCCTGCTC CAACAGCAGC AGGCACTCAT GCTTCAACAG
    CAGCAGCTTC AAGAGTTTTA TAAGAAACAA CAGGAACAGT TGCAGCTTCA ACTTTTACAG
    CAACAACATG CTGGAAAACA GCCTAAAGAG CCCCAGCAGC AGCAAGTGGC CACACAGCAG
    TTGGCCTTTC AGCAGCAGCT CCTACAGATG CAGCAGTTGC AGCAGCAGCA TCTCCTGTCT
    CTGCAGCGTC AGGGGCTGCT GACCATCCAG CCCGGGCAGC CTACTCTGCC TTTGCAACCC
    CTTGCACAAG GCATGATTCC AACAGAACTG CAGCAGCTCT GGAAGGAAGT GACAAGCTCG
    CACACAGCGG AGGAGGCAGC CAGCAACAAC CACAGCAGCC TGGACCTGTC CACCACCTGC
    GTCTCCTCCT CTGCGCCCTC CAAGACCTCC TTAATCATCA ACCCACACGC CTCAACTAAC
    GGACAGCTAT CAGTCCACAC TCCTAAACGG GAGAGTTTAT CCCACGAGGA GCACTCACAC
    AGCCACCCGC TGTACGGACA CGGTGTATGC AAATGGCCGG GCTGTGAAGC AGTATGTGAA
    GACTTCCAGT CGTTCCTAAA ACATCTCAAC AGTGAGCATG CGCTGGATGA TAGAAGTACA
    GCCCAATGTA GAGTACAAAT GCAGGTTGTA CAGCAGTTAG AGCTACAGCT TGCAAAAGAT
    AAAGAGCGCC TGCAAGCCAT GATGACACAC CTGCATGTGA AGTCAACTGA ACCAAAAGCC
    ACCCCTCAGC CCCTGAATCT GGTATCGAGC GTCACGCTTT CCAAGACGGC GTCCGAGGCG
    TCTCCGCAGA GTTTACCTCA TACTCCCACC ACCCCGACTG CGCCCATCAC TCCCGTCACG
    CAGGGACCGT CGGTCATCAC TACCACGAGC ATGCACAACG TTGGGCCCAT CCGGAGGCGG
    TACTCGGACA AGTACAACGT CCCCATCTCT TCAGCAGATA TTGCCCAGAA CCAAGAATTT
    TATAAGAACG CAGAAGTTAG ACCGCCATTC ACGTATGCAT CTTTAATTAG ACAGGCCATC
    CTGGAATCTC CTGAAAAACA GCTAACACTA AACGAAATCT ACAACTGGTT CACGCGAATG
    TTTGCCTACT TCCGACGCAA CGCGGCGACG TGGAAGAATG CAGTGCGTCA TAATCTTAGT
    CTTCACAAGT GTTTTGTGCG AGTAGAAAAC GTTAAAGGGG CAGTATGGAC AGTGGATGAA
    CTAGAGTTCC AAAAACGAAG GCCACAAAAG ATCAGTGGTA ACCCTTCTCT TATTAAAAAC
    ATACAGACCA GCCACACCTA CTGCACACCT CTCAATGCTG CTTTACAGGG AGAAGAAGCA
    GCTCTCTCCC CACTCTGTCT GTGGAAGGCT TCAATGGCTG AGAACAGTAT ACCTCTATAC
    ACTACTGCTT CCATGGGAAA TCCCACTCTG GGCAATTTAG CCAGTGCGAT GAGGGAAGAG
    CTCAATGGTG CAATGGAGCA TACGAACAGT AACGGGAGTG ACAGCAGTCC AGGACGTTCC
    CCTATGCAAG CGATGCACCC CGTGCACGTC AAAGAAGAAC CATTGGACCC AGATGAAAAT
    GAAGGCCCAC TATCCTTAGT GACAACAGCC AACCACAGTC CAGATTTTGA TCACGACAGA
    GATTATGAAG ATGAACCTGT AAATGAGGAC ATAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107105.1
    CDS76..1854
    Translation

    Target ORF information:

    RefSeq Version XM_014251630.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X13, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251630.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGATGACAC CTCAAGTGAT CACTCCCCAG CAAATGCAGC AGATCCTCCA GCAACAAGTG 
    CTAACTCCCC AGCAACTCCA AGTCCTGCTC CAACAGCAGC AGGCACTCAT GCTTCAACAG
    CAGCAGCTTC AAGAGTTTTA TAAGAAACAA CAGGAACAGT TGCAGCTTCA ACTTTTACAG
    CAACAACATG CTGGAAAACA GCCTAAAGAG CCCCAGCAGC AGCAAGTGGC CACACAGCAG
    TTGGCCTTTC AGCAGCAGCT CCTACAGATG CAGCAGTTGC AGCAGCAGCA TCTCCTGTCT
    CTGCAGCGTC AGGGGCTGCT GACCATCCAG CCCGGGCAGC CTACTCTGCC TTTGCAACCC
    CTTGCACAAG GCATGATTCC AACAGAACTG CAGCAGCTCT GGAAGGAAGT GACAAGCTCG
    CACACAGCGG AGGAGGCAGC CAGCAACAAC CACAGCAGCC TGGACCTGTC CACCACCTGC
    GTCTCCTCCT CTGCGCCCTC CAAGACCTCC TTAATCATCA ACCCACACGC CTCAACTAAC
    GGACAGCTAT CAGTCCACAC TCCTAAACGG GAGAGTTTAT CCCACGAGGA GCACTCACAC
    AGCCACCCGC TGTACGGACA CGGTGTATGC AAATGGCCGG GCTGTGAAGC AGTATGTGAA
    GACTTCCAGT CGTTCCTAAA ACATCTCAAC AGTGAGCATG CGCTGGATGA TAGAAGTACA
    GCCCAATGTA GAGTACAAAT GCAGGTTGTA CAGCAGTTAG AGCTACAGCT TGCAAAAGAT
    AAAGAGCGCC TGCAAGCCAT GATGACACAC CTGCATGTGA AGTCAACTGA ACCAAAAGCC
    ACCCCTCAGC CCCTGAATCT GGTATCGAGC GTCACGCTTT CCAAGACGGC GTCCGAGGCG
    TCTCCGCAGA GTTTACCTCA TACTCCCACC ACCCCGACTG CGCCCATCAC TCCCGTCACG
    CAGGGACCGT CGGTCATCAC TACCACGAGC ATGCACAACG TTGGGCCCAT CCGGAGGCGG
    TACTCGGACA AGTACAACGT CCCCATCTCT TCAGCAGATA TTGCCCAGAA CCAAGAATTT
    TATAAGAACG CAGAAGTTAG ACCGCCATTC ACGTATGCAT CTTTAATTAG ACAGGCCATC
    CTGGAATCTC CTGAAAAACA GCTAACACTA AACGAAATCT ACAACTGGTT CACGCGAATG
    TTTGCCTACT TCCGACGCAA CGCGGCGACG TGGAAGAATG CAGTGCGTCA TAATCTTAGT
    CTTCACAAGT GTTTTGTGCG AGTAGAAAAC GTTAAAGGGG CAGTATGGAC AGTGGATGAA
    CTAGAGTTCC AAAAACGAAG GCCACAAAAG ATCAGTGGTA ACCCTTCTCT TATTAAAAAC
    ATACAGACCA GCCACACCTA CTGCACACCT CTCAATGCTG CTTTACAGGG AGAAGAAGCA
    GCTCTCTCCC CACTCTGTCT GTGGAAGGCT TCAATGGCTG AGAACAGTAT ACCTCTATAC
    ACTACTGCTT CCATGGGAAA TCCCACTCTG GGCAATTTAG CCAGTGCGAT GAGGGAAGAG
    CTCAATGGTG CAATGGAGCA TACGAACAGT AACGGGAGTG ACAGCAGTCC AGGACGTTCC
    CCTATGCAAG CGATGCACCC CGTGCACGTC AAAGAAGAAC CATTGGACCC AGATGAAAAT
    GAAGGCCCAC TATCCTTAGT GACAACAGCC AACCACAGTC CAGATTTTGA TCACGACAGA
    GATTATGAAG ATGAACCTGT AAATGAGGAC ATAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12608
    Clone ID Related Accession (Same CDS sequence) XM_014251630.1 , XM_014251628.1 , XM_014251629.1
    Accession Version XM_014251628.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1779bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGATGACAC CTCAAGTGAT CACTCCCCAG CAAATGCAGC AGATCCTCCA GCAACAAGTG 
    CTAACTCCCC AGCAACTCCA AGTCCTGCTC CAACAGCAGC AGGCACTCAT GCTTCAACAG
    CAGCAGCTTC AAGAGTTTTA TAAGAAACAA CAGGAACAGT TGCAGCTTCA ACTTTTACAG
    CAACAACATG CTGGAAAACA GCCTAAAGAG CCCCAGCAGC AGCAAGTGGC CACACAGCAG
    TTGGCCTTTC AGCAGCAGCT CCTACAGATG CAGCAGTTGC AGCAGCAGCA TCTCCTGTCT
    CTGCAGCGTC AGGGGCTGCT GACCATCCAG CCCGGGCAGC CTACTCTGCC TTTGCAACCC
    CTTGCACAAG GCATGATTCC AACAGAACTG CAGCAGCTCT GGAAGGAAGT GACAAGCTCG
    CACACAGCGG AGGAGGCAGC CAGCAACAAC CACAGCAGCC TGGACCTGTC CACCACCTGC
    GTCTCCTCCT CTGCGCCCTC CAAGACCTCC TTAATCATCA ACCCACACGC CTCAACTAAC
    GGACAGCTAT CAGTCCACAC TCCTAAACGG GAGAGTTTAT CCCACGAGGA GCACTCACAC
    AGCCACCCGC TGTACGGACA CGGTGTATGC AAATGGCCGG GCTGTGAAGC AGTATGTGAA
    GACTTCCAGT CGTTCCTAAA ACATCTCAAC AGTGAGCATG CGCTGGATGA TAGAAGTACA
    GCCCAATGTA GAGTACAAAT GCAGGTTGTA CAGCAGTTAG AGCTACAGCT TGCAAAAGAT
    AAAGAGCGCC TGCAAGCCAT GATGACACAC CTGCATGTGA AGTCAACTGA ACCAAAAGCC
    ACCCCTCAGC CCCTGAATCT GGTATCGAGC GTCACGCTTT CCAAGACGGC GTCCGAGGCG
    TCTCCGCAGA GTTTACCTCA TACTCCCACC ACCCCGACTG CGCCCATCAC TCCCGTCACG
    CAGGGACCGT CGGTCATCAC TACCACGAGC ATGCACAACG TTGGGCCCAT CCGGAGGCGG
    TACTCGGACA AGTACAACGT CCCCATCTCT TCAGCAGATA TTGCCCAGAA CCAAGAATTT
    TATAAGAACG CAGAAGTTAG ACCGCCATTC ACGTATGCAT CTTTAATTAG ACAGGCCATC
    CTGGAATCTC CTGAAAAACA GCTAACACTA AACGAAATCT ACAACTGGTT CACGCGAATG
    TTTGCCTACT TCCGACGCAA CGCGGCGACG TGGAAGAATG CAGTGCGTCA TAATCTTAGT
    CTTCACAAGT GTTTTGTGCG AGTAGAAAAC GTTAAAGGGG CAGTATGGAC AGTGGATGAA
    CTAGAGTTCC AAAAACGAAG GCCACAAAAG ATCAGTGGTA ACCCTTCTCT TATTAAAAAC
    ATACAGACCA GCCACACCTA CTGCACACCT CTCAATGCTG CTTTACAGGG AGAAGAAGCA
    GCTCTCTCCC CACTCTGTCT GTGGAAGGCT TCAATGGCTG AGAACAGTAT ACCTCTATAC
    ACTACTGCTT CCATGGGAAA TCCCACTCTG GGCAATTTAG CCAGTGCGAT GAGGGAAGAG
    CTCAATGGTG CAATGGAGCA TACGAACAGT AACGGGAGTG ACAGCAGTCC AGGACGTTCC
    CCTATGCAAG CGATGCACCC CGTGCACGTC AAAGAAGAAC CATTGGACCC AGATGAAAAT
    GAAGGCCCAC TATCCTTAGT GACAACAGCC AACCACAGTC CAGATTTTGA TCACGACAGA
    GATTATGAAG ATGAACCTGT AAATGAGGAC ATAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107103.1
    CDS188..1966
    Translation

    Target ORF information:

    RefSeq Version XM_014251628.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X11, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251628.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGATGACAC CTCAAGTGAT CACTCCCCAG CAAATGCAGC AGATCCTCCA GCAACAAGTG 
    CTAACTCCCC AGCAACTCCA AGTCCTGCTC CAACAGCAGC AGGCACTCAT GCTTCAACAG
    CAGCAGCTTC AAGAGTTTTA TAAGAAACAA CAGGAACAGT TGCAGCTTCA ACTTTTACAG
    CAACAACATG CTGGAAAACA GCCTAAAGAG CCCCAGCAGC AGCAAGTGGC CACACAGCAG
    TTGGCCTTTC AGCAGCAGCT CCTACAGATG CAGCAGTTGC AGCAGCAGCA TCTCCTGTCT
    CTGCAGCGTC AGGGGCTGCT GACCATCCAG CCCGGGCAGC CTACTCTGCC TTTGCAACCC
    CTTGCACAAG GCATGATTCC AACAGAACTG CAGCAGCTCT GGAAGGAAGT GACAAGCTCG
    CACACAGCGG AGGAGGCAGC CAGCAACAAC CACAGCAGCC TGGACCTGTC CACCACCTGC
    GTCTCCTCCT CTGCGCCCTC CAAGACCTCC TTAATCATCA ACCCACACGC CTCAACTAAC
    GGACAGCTAT CAGTCCACAC TCCTAAACGG GAGAGTTTAT CCCACGAGGA GCACTCACAC
    AGCCACCCGC TGTACGGACA CGGTGTATGC AAATGGCCGG GCTGTGAAGC AGTATGTGAA
    GACTTCCAGT CGTTCCTAAA ACATCTCAAC AGTGAGCATG CGCTGGATGA TAGAAGTACA
    GCCCAATGTA GAGTACAAAT GCAGGTTGTA CAGCAGTTAG AGCTACAGCT TGCAAAAGAT
    AAAGAGCGCC TGCAAGCCAT GATGACACAC CTGCATGTGA AGTCAACTGA ACCAAAAGCC
    ACCCCTCAGC CCCTGAATCT GGTATCGAGC GTCACGCTTT CCAAGACGGC GTCCGAGGCG
    TCTCCGCAGA GTTTACCTCA TACTCCCACC ACCCCGACTG CGCCCATCAC TCCCGTCACG
    CAGGGACCGT CGGTCATCAC TACCACGAGC ATGCACAACG TTGGGCCCAT CCGGAGGCGG
    TACTCGGACA AGTACAACGT CCCCATCTCT TCAGCAGATA TTGCCCAGAA CCAAGAATTT
    TATAAGAACG CAGAAGTTAG ACCGCCATTC ACGTATGCAT CTTTAATTAG ACAGGCCATC
    CTGGAATCTC CTGAAAAACA GCTAACACTA AACGAAATCT ACAACTGGTT CACGCGAATG
    TTTGCCTACT TCCGACGCAA CGCGGCGACG TGGAAGAATG CAGTGCGTCA TAATCTTAGT
    CTTCACAAGT GTTTTGTGCG AGTAGAAAAC GTTAAAGGGG CAGTATGGAC AGTGGATGAA
    CTAGAGTTCC AAAAACGAAG GCCACAAAAG ATCAGTGGTA ACCCTTCTCT TATTAAAAAC
    ATACAGACCA GCCACACCTA CTGCACACCT CTCAATGCTG CTTTACAGGG AGAAGAAGCA
    GCTCTCTCCC CACTCTGTCT GTGGAAGGCT TCAATGGCTG AGAACAGTAT ACCTCTATAC
    ACTACTGCTT CCATGGGAAA TCCCACTCTG GGCAATTTAG CCAGTGCGAT GAGGGAAGAG
    CTCAATGGTG CAATGGAGCA TACGAACAGT AACGGGAGTG ACAGCAGTCC AGGACGTTCC
    CCTATGCAAG CGATGCACCC CGTGCACGTC AAAGAAGAAC CATTGGACCC AGATGAAAAT
    GAAGGCCCAC TATCCTTAGT GACAACAGCC AACCACAGTC CAGATTTTGA TCACGACAGA
    GATTATGAAG ATGAACCTGT AAATGAGGAC ATAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12608
    Clone ID Related Accession (Same CDS sequence) XM_014251630.1 , XM_014251628.1 , XM_014251629.1
    Accession Version XM_014251629.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 1779bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X4
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGATGACAC CTCAAGTGAT CACTCCCCAG CAAATGCAGC AGATCCTCCA GCAACAAGTG 
    CTAACTCCCC AGCAACTCCA AGTCCTGCTC CAACAGCAGC AGGCACTCAT GCTTCAACAG
    CAGCAGCTTC AAGAGTTTTA TAAGAAACAA CAGGAACAGT TGCAGCTTCA ACTTTTACAG
    CAACAACATG CTGGAAAACA GCCTAAAGAG CCCCAGCAGC AGCAAGTGGC CACACAGCAG
    TTGGCCTTTC AGCAGCAGCT CCTACAGATG CAGCAGTTGC AGCAGCAGCA TCTCCTGTCT
    CTGCAGCGTC AGGGGCTGCT GACCATCCAG CCCGGGCAGC CTACTCTGCC TTTGCAACCC
    CTTGCACAAG GCATGATTCC AACAGAACTG CAGCAGCTCT GGAAGGAAGT GACAAGCTCG
    CACACAGCGG AGGAGGCAGC CAGCAACAAC CACAGCAGCC TGGACCTGTC CACCACCTGC
    GTCTCCTCCT CTGCGCCCTC CAAGACCTCC TTAATCATCA ACCCACACGC CTCAACTAAC
    GGACAGCTAT CAGTCCACAC TCCTAAACGG GAGAGTTTAT CCCACGAGGA GCACTCACAC
    AGCCACCCGC TGTACGGACA CGGTGTATGC AAATGGCCGG GCTGTGAAGC AGTATGTGAA
    GACTTCCAGT CGTTCCTAAA ACATCTCAAC AGTGAGCATG CGCTGGATGA TAGAAGTACA
    GCCCAATGTA GAGTACAAAT GCAGGTTGTA CAGCAGTTAG AGCTACAGCT TGCAAAAGAT
    AAAGAGCGCC TGCAAGCCAT GATGACACAC CTGCATGTGA AGTCAACTGA ACCAAAAGCC
    ACCCCTCAGC CCCTGAATCT GGTATCGAGC GTCACGCTTT CCAAGACGGC GTCCGAGGCG
    TCTCCGCAGA GTTTACCTCA TACTCCCACC ACCCCGACTG CGCCCATCAC TCCCGTCACG
    CAGGGACCGT CGGTCATCAC TACCACGAGC ATGCACAACG TTGGGCCCAT CCGGAGGCGG
    TACTCGGACA AGTACAACGT CCCCATCTCT TCAGCAGATA TTGCCCAGAA CCAAGAATTT
    TATAAGAACG CAGAAGTTAG ACCGCCATTC ACGTATGCAT CTTTAATTAG ACAGGCCATC
    CTGGAATCTC CTGAAAAACA GCTAACACTA AACGAAATCT ACAACTGGTT CACGCGAATG
    TTTGCCTACT TCCGACGCAA CGCGGCGACG TGGAAGAATG CAGTGCGTCA TAATCTTAGT
    CTTCACAAGT GTTTTGTGCG AGTAGAAAAC GTTAAAGGGG CAGTATGGAC AGTGGATGAA
    CTAGAGTTCC AAAAACGAAG GCCACAAAAG ATCAGTGGTA ACCCTTCTCT TATTAAAAAC
    ATACAGACCA GCCACACCTA CTGCACACCT CTCAATGCTG CTTTACAGGG AGAAGAAGCA
    GCTCTCTCCC CACTCTGTCT GTGGAAGGCT TCAATGGCTG AGAACAGTAT ACCTCTATAC
    ACTACTGCTT CCATGGGAAA TCCCACTCTG GGCAATTTAG CCAGTGCGAT GAGGGAAGAG
    CTCAATGGTG CAATGGAGCA TACGAACAGT AACGGGAGTG ACAGCAGTCC AGGACGTTCC
    CCTATGCAAG CGATGCACCC CGTGCACGTC AAAGAAGAAC CATTGGACCC AGATGAAAAT
    GAAGGCCCAC TATCCTTAGT GACAACAGCC AACCACAGTC CAGATTTTGA TCACGACAGA
    GATTATGAAG ATGAACCTGT AAATGAGGAC ATAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.
    RefSeq XP_014107104.1
    CDS63..1841
    Translation

    Target ORF information:

    RefSeq Version XM_014251629.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X12, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251629.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    ATGATGACAC CTCAAGTGAT CACTCCCCAG CAAATGCAGC AGATCCTCCA GCAACAAGTG 
    CTAACTCCCC AGCAACTCCA AGTCCTGCTC CAACAGCAGC AGGCACTCAT GCTTCAACAG
    CAGCAGCTTC AAGAGTTTTA TAAGAAACAA CAGGAACAGT TGCAGCTTCA ACTTTTACAG
    CAACAACATG CTGGAAAACA GCCTAAAGAG CCCCAGCAGC AGCAAGTGGC CACACAGCAG
    TTGGCCTTTC AGCAGCAGCT CCTACAGATG CAGCAGTTGC AGCAGCAGCA TCTCCTGTCT
    CTGCAGCGTC AGGGGCTGCT GACCATCCAG CCCGGGCAGC CTACTCTGCC TTTGCAACCC
    CTTGCACAAG GCATGATTCC AACAGAACTG CAGCAGCTCT GGAAGGAAGT GACAAGCTCG
    CACACAGCGG AGGAGGCAGC CAGCAACAAC CACAGCAGCC TGGACCTGTC CACCACCTGC
    GTCTCCTCCT CTGCGCCCTC CAAGACCTCC TTAATCATCA ACCCACACGC CTCAACTAAC
    GGACAGCTAT CAGTCCACAC TCCTAAACGG GAGAGTTTAT CCCACGAGGA GCACTCACAC
    AGCCACCCGC TGTACGGACA CGGTGTATGC AAATGGCCGG GCTGTGAAGC AGTATGTGAA
    GACTTCCAGT CGTTCCTAAA ACATCTCAAC AGTGAGCATG CGCTGGATGA TAGAAGTACA
    GCCCAATGTA GAGTACAAAT GCAGGTTGTA CAGCAGTTAG AGCTACAGCT TGCAAAAGAT
    AAAGAGCGCC TGCAAGCCAT GATGACACAC CTGCATGTGA AGTCAACTGA ACCAAAAGCC
    ACCCCTCAGC CCCTGAATCT GGTATCGAGC GTCACGCTTT CCAAGACGGC GTCCGAGGCG
    TCTCCGCAGA GTTTACCTCA TACTCCCACC ACCCCGACTG CGCCCATCAC TCCCGTCACG
    CAGGGACCGT CGGTCATCAC TACCACGAGC ATGCACAACG TTGGGCCCAT CCGGAGGCGG
    TACTCGGACA AGTACAACGT CCCCATCTCT TCAGCAGATA TTGCCCAGAA CCAAGAATTT
    TATAAGAACG CAGAAGTTAG ACCGCCATTC ACGTATGCAT CTTTAATTAG ACAGGCCATC
    CTGGAATCTC CTGAAAAACA GCTAACACTA AACGAAATCT ACAACTGGTT CACGCGAATG
    TTTGCCTACT TCCGACGCAA CGCGGCGACG TGGAAGAATG CAGTGCGTCA TAATCTTAGT
    CTTCACAAGT GTTTTGTGCG AGTAGAAAAC GTTAAAGGGG CAGTATGGAC AGTGGATGAA
    CTAGAGTTCC AAAAACGAAG GCCACAAAAG ATCAGTGGTA ACCCTTCTCT TATTAAAAAC
    ATACAGACCA GCCACACCTA CTGCACACCT CTCAATGCTG CTTTACAGGG AGAAGAAGCA
    GCTCTCTCCC CACTCTGTCT GTGGAAGGCT TCAATGGCTG AGAACAGTAT ACCTCTATAC
    ACTACTGCTT CCATGGGAAA TCCCACTCTG GGCAATTTAG CCAGTGCGAT GAGGGAAGAG
    CTCAATGGTG CAATGGAGCA TACGAACAGT AACGGGAGTG ACAGCAGTCC AGGACGTTCC
    CCTATGCAAG CGATGCACCC CGTGCACGTC AAAGAAGAAC CATTGGACCC AGATGAAAAT
    GAAGGCCCAC TATCCTTAGT GACAACAGCC AACCACAGTC CAGATTTTGA TCACGACAGA
    GATTATGAAG ATGAACCTGT AAATGAGGAC ATAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12605
    Clone ID Related Accession (Same CDS sequence) XM_014251620.1 , XM_014251617.1 , XM_014251624.1 , XM_014251625.1 , XM_014251621.1 , XM_014251618.1 , XM_014251619.1 , XM_014251623.1
    Accession Version XM_014251620.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2088bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107095.1
    CDS231..2318
    Translation

    Target ORF information:

    RefSeq Version XM_014251620.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X4, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251620.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12605
    Clone ID Related Accession (Same CDS sequence) XM_014251620.1 , XM_014251617.1 , XM_014251624.1 , XM_014251625.1 , XM_014251621.1 , XM_014251618.1 , XM_014251619.1 , XM_014251623.1
    Accession Version XM_014251617.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2088bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107092.1
    CDS322..2409
    Translation

    Target ORF information:

    RefSeq Version XM_014251617.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X1, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251617.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12605
    Clone ID Related Accession (Same CDS sequence) XM_014251620.1 , XM_014251617.1 , XM_014251624.1 , XM_014251625.1 , XM_014251621.1 , XM_014251618.1 , XM_014251619.1 , XM_014251623.1
    Accession Version XM_014251624.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2088bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107099.1
    CDS168..2255
    Translation

    Target ORF information:

    RefSeq Version XM_014251624.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X7, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251624.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12605
    Clone ID Related Accession (Same CDS sequence) XM_014251620.1 , XM_014251617.1 , XM_014251624.1 , XM_014251625.1 , XM_014251621.1 , XM_014251618.1 , XM_014251619.1 , XM_014251623.1
    Accession Version XM_014251625.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2088bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107100.1
    CDS202..2289
    Translation

    Target ORF information:

    RefSeq Version XM_014251625.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X8, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251625.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12605
    Clone ID Related Accession (Same CDS sequence) XM_014251620.1 , XM_014251617.1 , XM_014251624.1 , XM_014251625.1 , XM_014251621.1 , XM_014251618.1 , XM_014251619.1 , XM_014251623.1
    Accession Version XM_014251621.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2088bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107096.1
    CDS99..2186
    Translation

    Target ORF information:

    RefSeq Version XM_014251621.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X5, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251621.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12605
    Clone ID Related Accession (Same CDS sequence) XM_014251620.1 , XM_014251617.1 , XM_014251624.1 , XM_014251625.1 , XM_014251621.1 , XM_014251618.1 , XM_014251619.1 , XM_014251623.1
    Accession Version XM_014251618.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2088bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107093.1
    CDS394..2481
    Translation

    Target ORF information:

    RefSeq Version XM_014251618.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X2, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251618.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12605
    Clone ID Related Accession (Same CDS sequence) XM_014251620.1 , XM_014251617.1 , XM_014251624.1 , XM_014251625.1 , XM_014251621.1 , XM_014251618.1 , XM_014251619.1 , XM_014251623.1
    Accession Version XM_014251619.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2088bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107094.1
    CDS229..2316
    Translation

    Target ORF information:

    RefSeq Version XM_014251619.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X3, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251619.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12605
    Clone ID Related Accession (Same CDS sequence) XM_014251620.1 , XM_014251617.1 , XM_014251624.1 , XM_014251625.1 , XM_014251621.1 , XM_014251618.1 , XM_014251619.1 , XM_014251623.1
    Accession Version XM_014251623.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2088bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X1
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107098.1
    CDS221..2308
    Translation

    Target ORF information:

    RefSeq Version XM_014251623.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X6, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251623.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGGA
    GAAGAAGCAG CTCTCTCCCC ACTCTGTCTG TGGAAGGCTT CAATGGCTGA GAACAGTATA
    CCTCTATACA CTACTGCTTC CATGGGAAAT CCCACTCTGG GCAATTTAGC CAGTGCGATG
    AGGGAAGAGC TCAATGGTGC AATGGAGCAT ACGAACAGTA ACGGGAGTGA CAGCAGTCCA
    GGACGTTCCC CTATGCAAGC GATGCACCCC GTGCACGTCA AAGAAGAACC ATTGGACCCA
    GATGAAAATG AAGGCCCACT ATCCTTAGTG ACAACAGCCA ACCACAGTCC AGATTTTGAT
    CACGACAGAG ATTATGAAGA TGAACCTGTA AATGAGGACA TAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12606
    Clone ID Related Accession (Same CDS sequence) XM_014251626.1
    Accession Version XM_014251626.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2085bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGATATTGC CCAGAACCAA
    GAATTTTATA AGAACGCAGA AGTTAGACCG CCATTCACGT ATGCATCTTT AATTAGACAG
    GCCATCCTGG AATCTCCTGA AAAACAGCTA ACACTAAACG AAATCTACAA CTGGTTCACG
    CGAATGTTTG CCTACTTCCG ACGCAACGCG GCGACGTGGA AGAATGCAGT GCGTCATAAT
    CTTAGTCTTC ACAAGTGTTT TGTGCGAGTA GAAAACGTTA AAGGGGCAGT ATGGACAGTG
    GATGAACTAG AGTTCCAAAA ACGAAGGCCA CAAAAGATCA GTGGTAACCC TTCTCTTATT
    AAAAACATAC AGACCAGCCA CACCTACTGC ACACCTCTCA ATGCTGCTTT ACAGGGAGAA
    GAAGCAGCTC TCTCCCCACT CTGTCTGTGG AAGGCTTCAA TGGCTGAGAA CAGTATACCT
    CTATACACTA CTGCTTCCAT GGGAAATCCC ACTCTGGGCA ATTTAGCCAG TGCGATGAGG
    GAAGAGCTCA ATGGTGCAAT GGAGCATACG AACAGTAACG GGAGTGACAG CAGTCCAGGA
    CGTTCCCCTA TGCAAGCGAT GCACCCCGTG CACGTCAAAG AAGAACCATT GGACCCAGAT
    GAAAATGAAG GCCCACTATC CTTAGTGACA ACAGCCAACC ACAGTCCAGA TTTTGATCAC
    GACAGAGATT ATGAAGATGA ACCTGTAAAT GAGGACATAG AATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107101.1
    CDS322..2406
    Translation

    Target ORF information:

    RefSeq Version XM_014251626.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X9, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251626.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGATATTGC CCAGAACCAA
    GAATTTTATA AGAACGCAGA AGTTAGACCG CCATTCACGT ATGCATCTTT AATTAGACAG
    GCCATCCTGG AATCTCCTGA AAAACAGCTA ACACTAAACG AAATCTACAA CTGGTTCACG
    CGAATGTTTG CCTACTTCCG ACGCAACGCG GCGACGTGGA AGAATGCAGT GCGTCATAAT
    CTTAGTCTTC ACAAGTGTTT TGTGCGAGTA GAAAACGTTA AAGGGGCAGT ATGGACAGTG
    GATGAACTAG AGTTCCAAAA ACGAAGGCCA CAAAAGATCA GTGGTAACCC TTCTCTTATT
    AAAAACATAC AGACCAGCCA CACCTACTGC ACACCTCTCA ATGCTGCTTT ACAGGGAGAA
    GAAGCAGCTC TCTCCCCACT CTGTCTGTGG AAGGCTTCAA TGGCTGAGAA CAGTATACCT
    CTATACACTA CTGCTTCCAT GGGAAATCCC ACTCTGGGCA ATTTAGCCAG TGCGATGAGG
    GAAGAGCTCA ATGGTGCAAT GGAGCATACG AACAGTAACG GGAGTGACAG CAGTCCAGGA
    CGTTCCCCTA TGCAAGCGAT GCACCCCGTG CACGTCAAAG AAGAACCATT GGACCCAGAT
    GAAAATGAAG GCCCACTATC CTTAGTGACA ACAGCCAACC ACAGTCCAGA TTTTGATCAC
    GACAGAGATT ATGAAGATGA ACCTGTAAAT GAGGACATAG AATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID OPs12607
    Clone ID Related Accession (Same CDS sequence) XM_014251627.1
    Accession Version XM_014251627.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2049bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2015-09-20
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Product forkhead box protein P1 isoform X3
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_005087566.1) annotated using gene prediction method: Gnomon, supported by mRNA and EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Pseudopodoces humilis Annotation Release 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.4 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGCT
    TCAATGGCTG AGAACAGTAT ACCTCTATAC ACTACTGCTT CCATGGGAAA TCCCACTCTG
    GGCAATTTAG CCAGTGCGAT GAGGGAAGAG CTCAATGGTG CAATGGAGCA TACGAACAGT
    AACGGGAGTG ACAGCAGTCC AGGACGTTCC CCTATGCAAG CGATGCACCC CGTGCACGTC
    AAAGAAGAAC CATTGGACCC AGATGAAAAT GAAGGCCCAC TATCCTTAGT GACAACAGCC
    AACCACAGTC CAGATTTTGA TCACGACAGA GATTATGAAG ATGAACCTGT AAATGAGGAC
    ATAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_014107102.1
    CDS319..2367
    Translation

    Target ORF information:

    RefSeq Version XM_014251627.1
    Organism Pseudopodoces humilis(Tibetan ground-tit)
    Definition Pseudopodoces humilis forkhead box P1 (FOXP1), transcript variant X10, mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_014251627.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    ATGATGCAAG AATCTGGGAC TGAGACAAAA AGTAACGGTT CAGCCATTCA GAATGGAGCG 
    AGCGGTGGCA ACCATTTACT AGAGTGCAGC CTGCGGGAAG TGAGATCAAA CGGCGAGACA
    CCTTCCGTTG AAATTGGGGC TGCAGATTTA GCACATCTCC AGCAACAGCA GGCTCTCCAG
    GTGGCACGAC AGCTTCTCCT GCAACAGCAG CAGCAGCAGC AACAGCAGCA GCAGCAACAA
    GTTAGTGGAA TAAAGTCTCC GAAGAGGAAT GACAAACAGC CAGCCCTTCA GGTTCCAGTG
    TCGGTGGCTA TGATGACACC TCAAGTGATC ACTCCCCAGC AAATGCAGCA GATCCTCCAG
    CAACAAGTGC TAACTCCCCA GCAACTCCAA GTCCTGCTCC AACAGCAGCA GGCACTCATG
    CTTCAACAGC AGCAGCTTCA AGAGTTTTAT AAGAAACAAC AGGAACAGTT GCAGCTTCAA
    CTTTTACAGC AACAACATGC TGGAAAACAG CCTAAAGAGC CCCAGCAGCA GCAAGTGGCC
    ACACAGCAGT TGGCCTTTCA GCAGCAGCTC CTACAGATGC AGCAGTTGCA GCAGCAGCAT
    CTCCTGTCTC TGCAGCGTCA GGGGCTGCTG ACCATCCAGC CCGGGCAGCC TACTCTGCCT
    TTGCAACCCC TTGCACAAGG CATGATTCCA ACAGAACTGC AGCAGCTCTG GAAGGAAGTG
    ACAAGCTCGC ACACAGCGGA GGAGGCAGCC AGCAACAACC ACAGCAGCCT GGACCTGTCC
    ACCACCTGCG TCTCCTCCTC TGCGCCCTCC AAGACCTCCT TAATCATCAA CCCACACGCC
    TCAACTAACG GACAGCTATC AGTCCACACT CCTAAACGGG AGAGTTTATC CCACGAGGAG
    CACTCACACA GCCACCCGCT GTACGGACAC GGTGTATGCA AATGGCCGGG CTGTGAAGCA
    GTATGTGAAG ACTTCCAGTC GTTCCTAAAA CATCTCAACA GTGAGCATGC GCTGGATGAT
    AGAAGTACAG CCCAATGTAG AGTACAAATG CAGGTTGTAC AGCAGTTAGA GCTACAGCTT
    GCAAAAGATA AAGAGCGCCT GCAAGCCATG ATGACACACC TGCATGTGAA GTCAACTGAA
    CCAAAAGCCA CCCCTCAGCC CCTGAATCTG GTATCGAGCG TCACGCTTTC CAAGACGGCG
    TCCGAGGCGT CTCCGCAGAG TTTACCTCAT ACTCCCACCA CCCCGACTGC GCCCATCACT
    CCCGTCACGC AGGGACCGTC GGTCATCACT ACCACGAGCA TGCACAACGT TGGGCCCATC
    CGGAGGCGGT ACTCGGACAA GTACAACGTC CCCATCTCTT CAGCAGATAT TGCCCAGAAC
    CAAGAATTTT ATAAGAACGC AGAAGTTAGA CCGCCATTCA CGTATGCATC TTTAATTAGA
    CAGGCCATCC TGGAATCTCC TGAAAAACAG CTAACACTAA ACGAAATCTA CAACTGGTTC
    ACGCGAATGT TTGCCTACTT CCGACGCAAC GCGGCGACGT GGAAGAATGC AGTGCGTCAT
    AATCTTAGTC TTCACAAGTG TTTTGTGCGA GTAGAAAACG TTAAAGGGGC AGTATGGACA
    GTGGATGAAC TAGAGTTCCA AAAACGAAGG CCACAAAAGA TCAGTGGTAA CCCTTCTCTT
    ATTAAAAACA TACAGACCAG CCACACCTAC TGCACACCTC TCAATGCTGC TTTACAGGCT
    TCAATGGCTG AGAACAGTAT ACCTCTATAC ACTACTGCTT CCATGGGAAA TCCCACTCTG
    GGCAATTTAG CCAGTGCGAT GAGGGAAGAG CTCAATGGTG CAATGGAGCA TACGAACAGT
    AACGGGAGTG ACAGCAGTCC AGGACGTTCC CCTATGCAAG CGATGCACCC CGTGCACGTC
    AAAGAAGAAC CATTGGACCC AGATGAAAAT GAAGGCCCAC TATCCTTAGT GACAACAGCC
    AACCACAGTC CAGATTTTGA TCACGACAGA GATTATGAAG ATGAACCTGT AAATGAGGAC
    ATAGAATGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.