CDH2 cDNA ORF clone, Opisthocomus hoazin

The following CDH2 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the CDH2 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OOp20154 XM_009935942.1
Latest version!
Opisthocomus hoazin cadherin 2, type 1, N-cadherin (neuronal) (CDH2), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OOp20154
    Clone ID Related Accession (Same CDS sequence) XM_009935942.1
    Accession Version XM_009935942.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2994bp)
    Protein sequence
    SNP
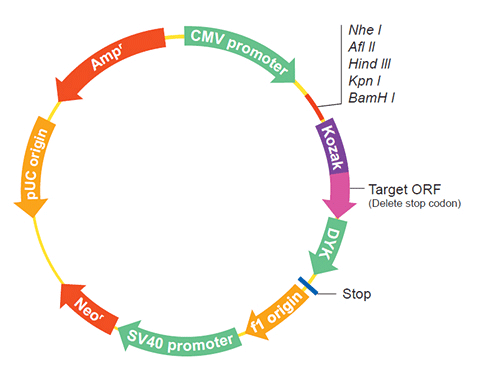
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-10-27
    Organism Opisthocomus hoazin
    Product cadherin-2
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_009901540.1) annotated using gene prediction method: Gnomon, supported by EST evidence. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Opisthocomus hoazin Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 11% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGTTGGTGG ATAAGAGAAG AGAAAGTGAT GTCATCCACC TGGACTTGAG CAAAGCATTT 
    GACACTGTCC TGCACGACAT TGTTGTCTCT AAGTTAGAGA GGCTCAGATT TGAAGGATGG
    ACCATTCGGT GGATAAGGAA TTGGCTGGAT GGTCACTCTC AAGGAGTTGC AGTCAACGGC
    TTGATGTCCA AGAGGAGACC AGTGACAAGT GGCGTTCCTC AGAGGTCGGT ATTTGGACTG
    GCACTGTTTA ACATCTCTGT CACTGACATG GACAGTGGGA TTGAGTGTAC CCTCCGCAAG
    TTTGCCTACG ACACCAAGCT GTGTGGTGGG GCACCGATAA AAGCAACCTG TGAAGATCTG
    TCATGCAAGA CTGGATTTCC TGAAGATGTT CACAGTGCAG TGGTGTCAAG GAGTGTACAT
    GGAGGACAGC CTCTTCTCAA TGTGAGGTTT CGAAGCTGTG ATGGAAACAA AAAAATACAC
    TTTGGAAGCA GTGAGCCAGA AGATTTCAGA GTAGGTGAAG ATGGTGTGGT CTACGCAGAG
    AGAAGCTTTC AACTTTCAGC AGAGCCCACA GAATTTGTTG TGTCTGCTCA GGACAAGGAA
    ACCCAGGAAG AATGGCAAAT GAGAGTTAAG CTAACCCCTG AACCAGCCTT CGCAGGGTCT
    TCAGAAAAGG ACCAAAAAAA AATTCAAGAC ATCATATTTC CATGGCAACA ATACAAGCAC
    AGCAGCCCGC TGAAGAGGCA GAAGAGAGAC TGGGTTATTC CTCCAATCAA CCTGCCAGAA
    AATTCCAGAG GACCTTTTCC TCAGGAGTTA GTCAGGATTA GGTCTGATCG TGATAAAAGC
    CTCTCCCTAC GCTACAGTGT GACTGGCCCA GGAGCTGACC AACCTCCAAC AGGCATCTTC
    ATCATCAACC CCATCTCAGG ACAGCTGTCT GTGACAAAGC CTTTAGACCG GGAGCAGATT
    GCTTCTTTTC ATCTGAGAGC ACACGCAGTG GATGTAAATG GAAACCAGGT GGAAAATCCT
    ATTGACATTG TTATTAATGT CATTGATATG AATGACAATA GACCTGAGTT CTTACACCAG
    GTTTGGAACG GGACAGTCCC TGAAGGATCA AAGCCAGGAA CTTACGTGAT GACTGTTACT
    GCCATTGATG CTGATGATCC CAATGCGCAG AATGGGATGC TGAGATACAG GATCTTGTCA
    CAGGCCCCAA GCAGCCCCTC TCCAAACATG TTTACAATCA ACAACGAGAC TGGTGACATT
    ATCACTGTAG CAGCTGGGCT TGACAGAGAG AAAGTACAGC AATATACATT AATAATTCAA
    GCTACGGACA TGGAAGGAAA CCCAACATAT GGTCTTTCAA ACACAGCAAC TGCTGTCATC
    ACTGTGACAG ATGTCAATGA CAATCCTCCA GAGTTCACTG CCATGACTTT CTACGGGGAA
    GTACCGGAAA ACAGAGTGGA TGTGATTGTA GCCAATTTGA CGGTAACGGA TAAAGATCAG
    CCCCACACGC CTGCCTGGAA TGCAATGTAC CGAATGACTG GAGGAGATCC GACAGGTCGA
    TTTACCATCC TGACTGATCC CAATAGCAAC GATGGACTGG TGACTGTTGT GAAGCCTATT
    GACTTCGAGA CCAACAGGAT GTTCGTGCTT ACAGTAGCTG CGGAAAATCA AGTGCCTTTG
    GCTAAGGGGA TTCAGCATCC TCCCCAGTCC ACAGCAACTG TGTCAATTAC GGTCATTGAT
    GTGAATGAGA GCCCATATTT TGTTCCAAAC CCCAAGCTTG TACGTCAAGA AGAAGGGCTA
    CTTGCTGGTA GCATATTGAC AACTTTCACT GCTCAGGACC CAGATCGTTA CATGCAGCAA
    ACCTCTTTAA GGTATTCAAA ACTGTCAGAT CCTGCAAACT GGCTGAAAAT TGACCCTGTT
    AATGGACAAA TAACTACTAC AGCTGTTTTG GACAGAGAGT CAATATATGT GCAAAACAAC
    ATGTATAATG CAACGTTTCT TGCTTCTGAT AATGGAATCC CCCCGATGAG CGGAACTGGC
    ACGCTTCAGA TACACCTGCT GGACATCAAT GATAATGCCC CCCAAGTGAA TCCAAAAGAA
    GCCACGACTT GCGAAACACT GCAGCCTAAT GCTATTAACA TCACTGCTGT AGACCCTGAC
    ATAGATCCAA ATGCAGGCCC GTTTGCTTTT GAACTGCCTG ACACACCTGC TAGTATTAAG
    AGGAATTGGA CTATTGTTCG AATTAGTGGT GATCACGCCC AGCTCTCTTT AAGGATCAGG
    TTCCTGGAGG CTGGTATCTA CGATGTGCCC ATAGTAATTA CAGATTCTGG AAATCCACAT
    GCATCTAGCA CTTCCGTGCT GAAAGTGAAA GTTTGCCAAT GTGACATAAA TGGAGACTGC
    ACTGATGTTG ACCGGATCGT TGGTGCGGGG CTGGGCACTG GTGCTATCAT TGCAATTCTG
    CTTTGTATCA TCATCTTGCT AATTTTAGTT TTAATGTTCG TGGTATGGAT GAAACGCCGT
    GATAAAGAAC GTCAGGCAAA GCAGCTCTTG ATTGATCCAG AAGATGATGT GAGAGACAAC
    ATTCTGAAAT ACGATGAAGA AGGTGGTGGA GAAGAAGATC AGGATTATGA CTTGAGCCAG
    CTCCAGCAGC CTGACACTGT TGAACCAGAT GCCATCAAGC CTGTTGGAAT CAGACGTCTT
    GATGAAAGGC CAATCCATGC AGAACCTCAG TATCCAGTCA GATCAGCTGC TCCTCATCCT
    GGGGACATTG GGGACTTCAT TAATGAGGGA CTGAAAGCAG CCGACAATGA CCCTACAGCC
    CCGCCGTATG ACTCCCTCTT AGTCTTTGAC TATGAAGGAA GTGGCTCCAC TGCTGGATCC
    TTGAGCTCTC TTAACTCCTC GAGTAGTGGT GGTGAGCAAG ACTATGACTA CCTAAATGAC
    TGGGGCCCAC GTTTCAAGAA ACTTGCTGAT ATGTACGGCG GAGGTGATGA CTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_009934244.1
    CDS1..2994
    Translation

    Target ORF information:

    RefSeq Version XM_009935942.1
    Organism Opisthocomus hoazin
    Definition Opisthocomus hoazin cadherin 2, type 1, N-cadherin (neuronal) (CDH2), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_009935942.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGTTGGTGG ATAAGAGAAG AGAAAGTGAT GTCATCCACC TGGACTTGAG CAAAGCATTT 
    GACACTGTCC TGCACGACAT TGTTGTCTCT AAGTTAGAGA GGCTCAGATT TGAAGGATGG
    ACCATTCGGT GGATAAGGAA TTGGCTGGAT GGTCACTCTC AAGGAGTTGC AGTCAACGGC
    TTGATGTCCA AGAGGAGACC AGTGACAAGT GGCGTTCCTC AGAGGTCGGT ATTTGGACTG
    GCACTGTTTA ACATCTCTGT CACTGACATG GACAGTGGGA TTGAGTGTAC CCTCCGCAAG
    TTTGCCTACG ACACCAAGCT GTGTGGTGGG GCACCGATAA AAGCAACCTG TGAAGATCTG
    TCATGCAAGA CTGGATTTCC TGAAGATGTT CACAGTGCAG TGGTGTCAAG GAGTGTACAT
    GGAGGACAGC CTCTTCTCAA TGTGAGGTTT CGAAGCTGTG ATGGAAACAA AAAAATACAC
    TTTGGAAGCA GTGAGCCAGA AGATTTCAGA GTAGGTGAAG ATGGTGTGGT CTACGCAGAG
    AGAAGCTTTC AACTTTCAGC AGAGCCCACA GAATTTGTTG TGTCTGCTCA GGACAAGGAA
    ACCCAGGAAG AATGGCAAAT GAGAGTTAAG CTAACCCCTG AACCAGCCTT CGCAGGGTCT
    TCAGAAAAGG ACCAAAAAAA AATTCAAGAC ATCATATTTC CATGGCAACA ATACAAGCAC
    AGCAGCCCGC TGAAGAGGCA GAAGAGAGAC TGGGTTATTC CTCCAATCAA CCTGCCAGAA
    AATTCCAGAG GACCTTTTCC TCAGGAGTTA GTCAGGATTA GGTCTGATCG TGATAAAAGC
    CTCTCCCTAC GCTACAGTGT GACTGGCCCA GGAGCTGACC AACCTCCAAC AGGCATCTTC
    ATCATCAACC CCATCTCAGG ACAGCTGTCT GTGACAAAGC CTTTAGACCG GGAGCAGATT
    GCTTCTTTTC ATCTGAGAGC ACACGCAGTG GATGTAAATG GAAACCAGGT GGAAAATCCT
    ATTGACATTG TTATTAATGT CATTGATATG AATGACAATA GACCTGAGTT CTTACACCAG
    GTTTGGAACG GGACAGTCCC TGAAGGATCA AAGCCAGGAA CTTACGTGAT GACTGTTACT
    GCCATTGATG CTGATGATCC CAATGCGCAG AATGGGATGC TGAGATACAG GATCTTGTCA
    CAGGCCCCAA GCAGCCCCTC TCCAAACATG TTTACAATCA ACAACGAGAC TGGTGACATT
    ATCACTGTAG CAGCTGGGCT TGACAGAGAG AAAGTACAGC AATATACATT AATAATTCAA
    GCTACGGACA TGGAAGGAAA CCCAACATAT GGTCTTTCAA ACACAGCAAC TGCTGTCATC
    ACTGTGACAG ATGTCAATGA CAATCCTCCA GAGTTCACTG CCATGACTTT CTACGGGGAA
    GTACCGGAAA ACAGAGTGGA TGTGATTGTA GCCAATTTGA CGGTAACGGA TAAAGATCAG
    CCCCACACGC CTGCCTGGAA TGCAATGTAC CGAATGACTG GAGGAGATCC GACAGGTCGA
    TTTACCATCC TGACTGATCC CAATAGCAAC GATGGACTGG TGACTGTTGT GAAGCCTATT
    GACTTCGAGA CCAACAGGAT GTTCGTGCTT ACAGTAGCTG CGGAAAATCA AGTGCCTTTG
    GCTAAGGGGA TTCAGCATCC TCCCCAGTCC ACAGCAACTG TGTCAATTAC GGTCATTGAT
    GTGAATGAGA GCCCATATTT TGTTCCAAAC CCCAAGCTTG TACGTCAAGA AGAAGGGCTA
    CTTGCTGGTA GCATATTGAC AACTTTCACT GCTCAGGACC CAGATCGTTA CATGCAGCAA
    ACCTCTTTAA GGTATTCAAA ACTGTCAGAT CCTGCAAACT GGCTGAAAAT TGACCCTGTT
    AATGGACAAA TAACTACTAC AGCTGTTTTG GACAGAGAGT CAATATATGT GCAAAACAAC
    ATGTATAATG CAACGTTTCT TGCTTCTGAT AATGGAATCC CCCCGATGAG CGGAACTGGC
    ACGCTTCAGA TACACCTGCT GGACATCAAT GATAATGCCC CCCAAGTGAA TCCAAAAGAA
    GCCACGACTT GCGAAACACT GCAGCCTAAT GCTATTAACA TCACTGCTGT AGACCCTGAC
    ATAGATCCAA ATGCAGGCCC GTTTGCTTTT GAACTGCCTG ACACACCTGC TAGTATTAAG
    AGGAATTGGA CTATTGTTCG AATTAGTGGT GATCACGCCC AGCTCTCTTT AAGGATCAGG
    TTCCTGGAGG CTGGTATCTA CGATGTGCCC ATAGTAATTA CAGATTCTGG AAATCCACAT
    GCATCTAGCA CTTCCGTGCT GAAAGTGAAA GTTTGCCAAT GTGACATAAA TGGAGACTGC
    ACTGATGTTG ACCGGATCGT TGGTGCGGGG CTGGGCACTG GTGCTATCAT TGCAATTCTG
    CTTTGTATCA TCATCTTGCT AATTTTAGTT TTAATGTTCG TGGTATGGAT GAAACGCCGT
    GATAAAGAAC GTCAGGCAAA GCAGCTCTTG ATTGATCCAG AAGATGATGT GAGAGACAAC
    ATTCTGAAAT ACGATGAAGA AGGTGGTGGA GAAGAAGATC AGGATTATGA CTTGAGCCAG
    CTCCAGCAGC CTGACACTGT TGAACCAGAT GCCATCAAGC CTGTTGGAAT CAGACGTCTT
    GATGAAAGGC CAATCCATGC AGAACCTCAG TATCCAGTCA GATCAGCTGC TCCTCATCCT
    GGGGACATTG GGGACTTCAT TAATGAGGGA CTGAAAGCAG CCGACAATGA CCCTACAGCC
    CCGCCGTATG ACTCCCTCTT AGTCTTTGAC TATGAAGGAA GTGGCTCCAC TGCTGGATCC
    TTGAGCTCTC TTAACTCCTC GAGTAGTGGT GGTGAGCAAG ACTATGACTA CCTAAATGAC
    TGGGGCCCAC GTTTCAAGAA ACTTGCTGAT ATGTACGGCG GAGGTGATGA CTGA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.