LGR5 cDNA ORF clone, Opisthocomus hoazin

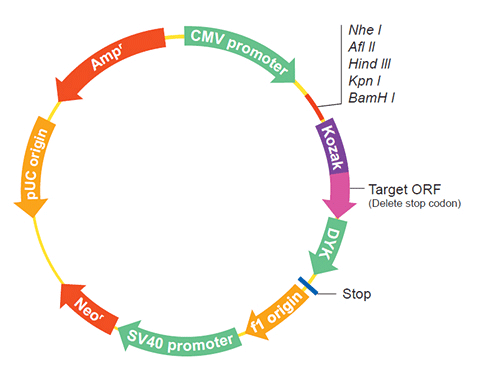
The following LGR5 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LGR5 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
OOp16490 XM_009931563.1
Latest version!
Opisthocomus hoazin leucine-rich repeat containing G protein-coupled receptor 5 (LGR5), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID OOp16490
    Clone ID Related Accession (Same CDS sequence) XM_009931563.1
    Accession Version XM_009931563.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2505bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2014-10-27
    Organism Opisthocomus hoazin
    Product leucine-rich repeat-containing G-protein coupled receptor 5
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_009900501.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Opisthocomus hoazin Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 6.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGAACAACA TTACTAAGCT GCCCTCAAAC CCTGTGCACA ATCTCCGCTT CCTGGAAGAG 
    CTACGTCTTG CAGGAAACGG CTTGACATAC ATTCCTAAGG GAGTCTTTGC TGGCCTTTTC
    AGTCTTAAAG TGCTGATGCT GCAGAACAAC CAACTACGCC AGGTTCCTAC TGAAGCACTC
    CAGAACTTGC ACAGCCTGCA GTCTCTACGT CTGGATGCCA ACCACATCAA CTATGTGCCC
    CCCAACTGCT TCAATGGCTT GGTCTCCCTT AGACACCTGT GGCTAGACGA TAACTCTTTG
    ACAGAAATTC CCGTCCAAGC TTTTAGAAGT TTACCAGCAC TTCAGGCAAT GACATTGGCA
    CTGAATAAAA TTCATTACAT ACCAGACTAT GCTTTCGGAA ACCTGTCTAG TTTGGTAGTT
    CTACATCTCC ATAACAATAG AATCTACTCC CTGGGAAAGA AATGCTTTGA TGGGCTCCAC
    AGCCTAGAGA CTTTAGATTT AAATTACAAC AGTCTGGACG AGTTCCCCAC TGCTATCAGG
    ACACTAACAA ACCTAAAAGA ACTGGGATTT CATAGCAATA ACATCAAGTC AATTCCTGAG
    CGTGCATTTG TGGGTAATCC GTCACTTATT ACAATACATT TTTATGATAA CCCTATCCAG
    CTTGTCGGAA AATCTGCTTT TCAGCACTTA CCGGAACTCA GAACACTGAC TTTAAATGGT
    GCTTCACAGA TAACGGAGTT TCCTGATCTG ACAGGCACTA CAAGTCTGGA GAGTTTGACA
    CTCACAGGAG CACAAATCAC CTCTCTCCCC AAATCAGCTT GTGACCAGTT ACCTAATCTC
    CAAGTGCTGG ATCTGTCTTA CAATCTTCTG GAAGATTTAC CCTGTTTTAC TGCATGTAAA
    AAACTCCAAA AAATTGATTT GCATCACAAT GAAATCGGTG AAATCAAAGC AGACACGTTT
    TGGCAGCTGG CTGCTCTTCG GTCTCTGGAT TTAGCTTGGA ACAAAATTAA AATTATTCAC
    CCCAATGCCT TCTCCTCTTT ACCATCTCTG ATCAAACTGG ATGTGTCATC CAACCTTTTG
    TCCTCTTTTC CTGTGACGGG GCTACATGGT TTAACTCATT TAAAATTAAC AGGAAATCAT
    GCCCTACAAA GTCTGATATC ATCTGAAAAT TTTCCAGAAC TCAAGGTCAT GGAAATGCCT
    TATGCTTATC AGTGTTGTGC CTTTGGAGCT TGTGAGAGCC ACTACAAAAT CTCCAGCCAG
    TGGAACAAAG ATGAGAACAA CAGCATTGAC GATTTTCACA GGAAGGATGC TGGGTTGTTA
    CAAATTCAAG ATGAGCGTGA CTTTGAAGAT TTTTTTCTTG ACTTTGAAGA AGATTTGAAA
    GCTCATCATT CAGTGCAATG CTCACCTTCT CCAGGTCCCT TCAAACCATG TGACCATCTG
    TTTGGTAGCT GGCTGATCAG AATTGGAGTG TGGACTATAG TTGGTCTGAC GTTTATTTGC
    AATGCACTGG TGTCTGCTAC AGTTTTCCGA TCTCCATTGT ATATGTCCTC CATAAAACTT
    CTTATCGGTT TAATAGCTAT TGTAGATGCG TTGATGGGTC TGTCCAGCGG AGTACTGGCT
    AGCGTGGATG CATCAACTTT TGGTAGCTTT GCTCAGTACG GGGCACAGTG GGAAAGTGGA
    ATTGGTTGCC AAATAACTGG CCTTCTCTCC ATTTTTGCTT CAGAGGCTTC CATTTTCCTC
    CTTACCCTAG CTGCGCTTGA ACGTGCATTC TCTGTAAAGC ACGCTACGAA GTTTGAAACA
    AAATCCTCCA CTGCTAGTGT AAAAATTGCC ATTTTCTTTT GCTTTGTGTT GGCACTAATC
    ATTGCAGTGA TACCATTTCT TACTGGGAGT GAGTATGGGG TTTCTCCGCT TTGTTTACCA
    CTACCATTTG GAGAACCCAC TGCTATGGGC TACATGGTAG CTCTGGTATT GATGAACTCC
    CTTTGTTTTC TGGTAATGAC TATTGCTTAT ACAAAGCTCT ACTGTAGTTT AGAAAAGGGA
    GAACTAGACA ACATTTGGGA TTGCTCTATG GTCAAACATA TAGCCTTGCT ACTTTTTACT
    AATTGCATTC TTTATTGCCC TGTGGCCTTC TTATCTTTTT CCTCCTTACT AAACCTCACT
    TTCATCAGCC CAGAAGTGAT TAAGTCAATA CTGCTAGTGA TTGTCCCATT GCCTGCGTGT
    CTAAACCCAC TCCTTTATAT ACTTTTCAAT CCACACTTTA AGGAGGACTT GGGAAGTCTG
    CGAAAGCAAA CTTTGTTATG GAGGAGATCA AAACATGCTA GTCTGATCTC TGTGAATTCA
    GAAGACATAG AAAAACAATC TTGTGACTCA ACACAAGCAT TGGTAACCTT CACAAGTGCC
    AGCATATCGT ATGACATGCC TACCAGCAAT TCACTAATGC CATCGTCTTA TCAAATGACG
    GAAAGCTGCA ATCTTTCATC AGTCGCCTTT GTTCCATGCC GCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_009929865.1
    CDS28..2532
    Translation

    Target ORF information:

    RefSeq Version XM_009931563.1
    Organism Opisthocomus hoazin
    Definition Opisthocomus hoazin leucine-rich repeat containing G protein-coupled receptor 5 (LGR5), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_009931563.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    ATGAACAACA TTACTAAGCT GCCCTCAAAC CCTGTGCACA ATCTCCGCTT CCTGGAAGAG 
    CTACGTCTTG CAGGAAACGG CTTGACATAC ATTCCTAAGG GAGTCTTTGC TGGCCTTTTC
    AGTCTTAAAG TGCTGATGCT GCAGAACAAC CAACTACGCC AGGTTCCTAC TGAAGCACTC
    CAGAACTTGC ACAGCCTGCA GTCTCTACGT CTGGATGCCA ACCACATCAA CTATGTGCCC
    CCCAACTGCT TCAATGGCTT GGTCTCCCTT AGACACCTGT GGCTAGACGA TAACTCTTTG
    ACAGAAATTC CCGTCCAAGC TTTTAGAAGT TTACCAGCAC TTCAGGCAAT GACATTGGCA
    CTGAATAAAA TTCATTACAT ACCAGACTAT GCTTTCGGAA ACCTGTCTAG TTTGGTAGTT
    CTACATCTCC ATAACAATAG AATCTACTCC CTGGGAAAGA AATGCTTTGA TGGGCTCCAC
    AGCCTAGAGA CTTTAGATTT AAATTACAAC AGTCTGGACG AGTTCCCCAC TGCTATCAGG
    ACACTAACAA ACCTAAAAGA ACTGGGATTT CATAGCAATA ACATCAAGTC AATTCCTGAG
    CGTGCATTTG TGGGTAATCC GTCACTTATT ACAATACATT TTTATGATAA CCCTATCCAG
    CTTGTCGGAA AATCTGCTTT TCAGCACTTA CCGGAACTCA GAACACTGAC TTTAAATGGT
    GCTTCACAGA TAACGGAGTT TCCTGATCTG ACAGGCACTA CAAGTCTGGA GAGTTTGACA
    CTCACAGGAG CACAAATCAC CTCTCTCCCC AAATCAGCTT GTGACCAGTT ACCTAATCTC
    CAAGTGCTGG ATCTGTCTTA CAATCTTCTG GAAGATTTAC CCTGTTTTAC TGCATGTAAA
    AAACTCCAAA AAATTGATTT GCATCACAAT GAAATCGGTG AAATCAAAGC AGACACGTTT
    TGGCAGCTGG CTGCTCTTCG GTCTCTGGAT TTAGCTTGGA ACAAAATTAA AATTATTCAC
    CCCAATGCCT TCTCCTCTTT ACCATCTCTG ATCAAACTGG ATGTGTCATC CAACCTTTTG
    TCCTCTTTTC CTGTGACGGG GCTACATGGT TTAACTCATT TAAAATTAAC AGGAAATCAT
    GCCCTACAAA GTCTGATATC ATCTGAAAAT TTTCCAGAAC TCAAGGTCAT GGAAATGCCT
    TATGCTTATC AGTGTTGTGC CTTTGGAGCT TGTGAGAGCC ACTACAAAAT CTCCAGCCAG
    TGGAACAAAG ATGAGAACAA CAGCATTGAC GATTTTCACA GGAAGGATGC TGGGTTGTTA
    CAAATTCAAG ATGAGCGTGA CTTTGAAGAT TTTTTTCTTG ACTTTGAAGA AGATTTGAAA
    GCTCATCATT CAGTGCAATG CTCACCTTCT CCAGGTCCCT TCAAACCATG TGACCATCTG
    TTTGGTAGCT GGCTGATCAG AATTGGAGTG TGGACTATAG TTGGTCTGAC GTTTATTTGC
    AATGCACTGG TGTCTGCTAC AGTTTTCCGA TCTCCATTGT ATATGTCCTC CATAAAACTT
    CTTATCGGTT TAATAGCTAT TGTAGATGCG TTGATGGGTC TGTCCAGCGG AGTACTGGCT
    AGCGTGGATG CATCAACTTT TGGTAGCTTT GCTCAGTACG GGGCACAGTG GGAAAGTGGA
    ATTGGTTGCC AAATAACTGG CCTTCTCTCC ATTTTTGCTT CAGAGGCTTC CATTTTCCTC
    CTTACCCTAG CTGCGCTTGA ACGTGCATTC TCTGTAAAGC ACGCTACGAA GTTTGAAACA
    AAATCCTCCA CTGCTAGTGT AAAAATTGCC ATTTTCTTTT GCTTTGTGTT GGCACTAATC
    ATTGCAGTGA TACCATTTCT TACTGGGAGT GAGTATGGGG TTTCTCCGCT TTGTTTACCA
    CTACCATTTG GAGAACCCAC TGCTATGGGC TACATGGTAG CTCTGGTATT GATGAACTCC
    CTTTGTTTTC TGGTAATGAC TATTGCTTAT ACAAAGCTCT ACTGTAGTTT AGAAAAGGGA
    GAACTAGACA ACATTTGGGA TTGCTCTATG GTCAAACATA TAGCCTTGCT ACTTTTTACT
    AATTGCATTC TTTATTGCCC TGTGGCCTTC TTATCTTTTT CCTCCTTACT AAACCTCACT
    TTCATCAGCC CAGAAGTGAT TAAGTCAATA CTGCTAGTGA TTGTCCCATT GCCTGCGTGT
    CTAAACCCAC TCCTTTATAT ACTTTTCAAT CCACACTTTA AGGAGGACTT GGGAAGTCTG
    CGAAAGCAAA CTTTGTTATG GAGGAGATCA AAACATGCTA GTCTGATCTC TGTGAATTCA
    GAAGACATAG AAAAACAATC TTGTGACTCA ACACAAGCAT TGGTAACCTT CACAAGTGCC
    AGCATATCGT ATGACATGCC TACCAGCAAT TCACTAATGC CATCGTCTTA TCAAATGACG
    GAAAGCTGCA ATCTTTCATC AGTCGCCTTT GTTCCATGCC GCTAG

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.