LOC108650263 cDNA ORF clone, Drosophila navojoa

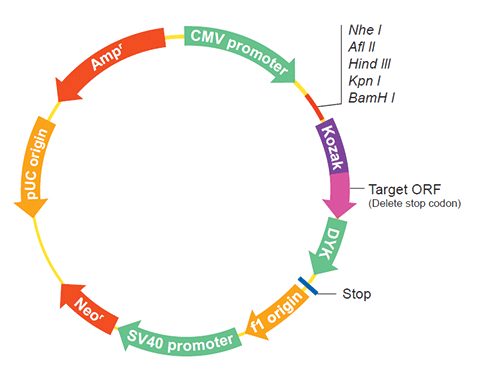
The following LOC108650263 gene cDNA ORF clone sequences were retrieved from the NCBI Reference Sequence Database (RefSeq). These sequences represent the protein coding region of the LOC108650263 cDNA ORF which is encoded by the open reading frame (ORF) sequence. ORF sequences can be delivered in our standard vector, pcDNA3.1+/C-(K)DYK or the vector of your choice as an expression/transfection-ready ORF clone. Not the clone you want? Click here to find your clone.

***CloneID Accession No. Definition **Vector *Turnaround time Price (USD) Select
ODr245132 XM_018099382.1
Latest version!
Drosophila navojoa uncharacterized LOC108650263 (LOC108650263), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $510.30
$729.00
ODr336335 XM_030386760.1
Latest version!
Drosophila navojoa uncharacterized LOC108650263 (LOC108650263), mRNA. pcDNA3.1-C-(k)DYK or customized vector 14-16 $475.30
$679.00

ORF Online Only Promotion

Next-day Shipping ORF Clones ( in default vector with tag)
1 Clone 30% OFF
2-4 Clone 40% OFF
5 or more Clone 50% OFF
All Other ORF Clones
30% OFF

*Business Day

** You may select a custom vector to replace pcDNA3.1+/C-(K)DYK after clone is added to cart.

** GenScript guarantees 100% sequence accuracy of all synthetic DNA constructs we deliver, but we do not guarantee protein expression in your experimental system. Protein expression is influenced by many factors that may vary between experiments or laboratories. In addition, please pay attention to the signal peptide, propeptide and transit peptide in target ORF, which may affect the choice of vector (N/C terminal tag vector).

***One clone ID might be correlated to multiple accession numbers, which share the same CDS sequence.

  • Reference Sequences (Refseq)
    CloneID ODr245132
    Clone ID Related Accession (Same CDS sequence) XM_018099382.1
    Accession Version XM_018099382.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2919bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2016-09-07
    Organism Drosophila navojoa
    Product uncharacterized protein LOC108650263
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_017181430.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Version :: Drosophila navojoa Annotation Release 100 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 7.1 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 12% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    ATGTCTACAT ATAAATCAAA TGTAAAATTG TGCCGCGCTA TTGCAAATCA GCCGATATTG 
    TATGATGAAA GTAATGAACA TTATAGAAAA AGATTGCCTT CAGAGAATTG CTGGGATTTA
    GTCGCTTCAG AGTTGGGAGA GCCTGCGGAT AAGTGCAAGC GTCGCTGGCG TCAGATTCGT
    AACGATTACG TGCGTTGGAT ATCATCGGAC AATCAGCGTC AACGCAACGG ACAGAAGCGA
    CCGGGGTTTT ACTTGGCCGA AGAGCTTCAA TTCTTGAATC CGCATCTGTC GGGTGCCGAT
    CGCGAACGAG ATTCGCCGGA GAGTGAGCGC GGTAGCGAGC GAGATAGCAA GAGCAAAAGC
    AAAGAGCCGG CGATCGAGGA ATATAAAGGC AAGCAGAAGG ACATTGACGA GTCAGTGGAG
    GAGCAGCCGC TGGCCAAGCT CAAGCAGACG GCCAAAGATA AAGAACTAGA GAAAGAGAAA
    GACAAAGGCA AAGAGAAGGA GAAGGAGAAA GACAAAGAGA AAGAACGGAA ATCTCGGTCA
    GAAGGCCCCG TCACGCCCAC ATCCTCCGAG GACTCGCCCG TGGGCAGCTC GAAGCAGGAG
    TTTTTCATCA AGCAGAACAA CAGCAACAGC CTCTCCAATT GCCTGATCAT TGGCGTGAAA
    CCGGCCGGCT CCTCGGCTAG CGACTCACCA CTGCTCGACT CGATGGCGGA CGACAGCGCC
    GACGAGACCG CCAGCATGGG CGGCGGCCGG CGCTTGCGGC GTGGCGCCAA TCGCACCAAG
    AACTCGGCCA TACAGAAGGC GAGCGTCGAG CAGCGCCTGA CGCGCCTGCA GCGTCGCAAG
    TCCATGACCA TGGCGGCGGC CAACAGCTTG CTGAGCTCCA CGTCGCCGGT GAAGATGACG
    CCGGTGCCCC GAACCAGCAT GCCCGCCAGC ACCACCGCCA ACGCCAACGC TGGGCAGCCA
    AAGGCGGGCA ATAAGGCGCC CGCCAAGCAT GCGCTGGCCG GCGCCCGGGA TGACATATTT
    CCACGGCCAA GGGCCGCGGC GCCGGTCAAC CAGCAGGTGG TGCTCGCTCG CCATCCTGGC
    GTGCCGCTCC AGATGCCGCC AAAGTTGCAG CCGCCGCAGG GCGTGCAAGC CATGCCGCCA
    CGTCCTAACT ACGGCATCGG ACGTCCGCCG GGCCCTGCAC GGCTGGCGGC CAATGCCCAG
    GCTAAACGTC TACTGGCTGG GGCTGCACCA CCCGGACCCC GGGCCAACTT CCCCGGGCAA
    CAGCGCCCGC CGGCGCCCGA TGGCTTCAAG GCGCCCGCGA CCAGCTCCGC GCCAACCTCG
    CAGGCGCAGG CGCAGGCTCA GGCCACCACC AACAACAGCT CGGTGAGCAG CTCGAGCGGC
    ATCAGCAGCA TGGCCAACAT GTCCAACATG GTCAGCTTGA GCAGCCTTGC GAGCATTGCC
    GGCTCCAGCA GCGGCTTCAG CCTCAGCGCC AATTCCAACT CCAATTCCAC GCCCAGCTCG
    AGCTTCGGCA CACAGACAGC CTCGATCACC GCCTCGCCGA TTGTGAGCAC CACCCCACCC
    ACCATAGCGC TGATCAAGCG CTGCGAGCGG GGCAACCAGA CCGAGTGCCA GGACATCTTC
    TCGGACGAGC ACTTCCTGGA AATGGTGCGG CCGCAGATGA AGGAGATGAA TCCGCGCCAG
    AAGATGCACT TCAAGCAAAA GATCTTCCAG GCCCTGATCG AGATCTTTGA CGACGCCACC
    GACTTCCCGG CCAGCGGCGA GGTGCAGCAC TTCAATATAA ACACCCCGTC GGGCTTCGAC
    CATGTCACCG ACGACGAGCT GCGTCTCATA CGGGAGCTGG TGAGCATGGT GGGCGCTGCC
    AAGCATACAG CCGGCTCCAG CCCCGGCACG CCGTTGTTGG CACAGCGTGT GGCCACGCCC
    AAGACGCCAA GCGCGCTGCC GAACGCCTTC AGGCCAACCC TAAGCACAAC GCCACTGGGC
    GACGAGAAGA AACTCTATCG CATCATGAAG ACGAACAACC AAACCAAGAT CGTGCCCAAT
    GCATCCCCAT TGACGGATCA GCGCAAGGAC AGCCGCAGCA GCAGCAGCAG CAAGTTCGCC
    GTGCCCGGCG TGGCAGTGAA GGCCGTGGCC CGTCCGCTGG ATCCCTTGAA CCAGCTGTTC
    GGCCAGGGCG GCAGGCCAGC GGCCGCTACG GCCATCTCGC CCAAGGAGCC CATCCTGGTG
    CGTCAAATGG GCCGACGCTA CTCGGTCTGC GGCGGCGGTG GTCCCGCCAA CTCCTTGGGC
    GCCAATGGGA TCAATGCCAA CGCCAACATC GACGTGGCCG TGCTCAAGCG TCGCATCACG
    CCCATAGCAC AGCCCATGGC AGCGCCTGCA CAGCGGCCGC GCTACTCGCC CAACTCTCAG
    CCGCCGGTCA ACCCGATGGC AGCCATTCCG CCGGGCAACA GCCTGCTGAT GCGCCGCGCC
    GTCAACGCCA ACGGCGGCCA GCGCCAGGCG TCGCCGCTGT CGGCGAGCGT CGTGCCCCAG
    AAGACGCCGC AGATTGCGAG CATTCAGGGC AACGTCTTCA ACGAGTTTGC CACGCCCACG
    GCCGTGCGCG GCGGCAGCGG CGGCGGCGGC TCGCCAAGTG GCATCTCGCC AGGGATGCCG
    CCGCTCAAGC GTGCCATGAT CGTGGCCAAT GCCAAGACCA CTGCACAGCC GAAGCCAACG
    ACGACCCTGG CTCGCTCCCA GGTGAGCCCG GCCAGCGGAC AGGTGAGGTC GGCCAGCCAG
    TCGCCCGGCT CGAATGTGGC CAATCTCTTG GCCGAGCCAC GCCCAGAGGT GCCCAACGCC
    GACATGGCCG GCACCATTGC AGCGGATGAC TTCGACATGG GTCGCCTCAA GCGGGAGCCA
    GTGGACCCCG ATGATACGGT GGATATACTG GGCATTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_017954871.1
    CDS356..3274
    Translation

    Target ORF information:

    RefSeq Version XM_018099382.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa uncharacterized LOC108650263 (LOC108650263), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_018099382.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    ATGTCTACAT ATAAATCAAA TGTAAAATTG TGCCGCGCTA TTGCAAATCA GCCGATATTG 
    TATGATGAAA GTAATGAACA TTATAGAAAA AGATTGCCTT CAGAGAATTG CTGGGATTTA
    GTCGCTTCAG AGTTGGGAGA GCCTGCGGAT AAGTGCAAGC GTCGCTGGCG TCAGATTCGT
    AACGATTACG TGCGTTGGAT ATCATCGGAC AATCAGCGTC AACGCAACGG ACAGAAGCGA
    CCGGGGTTTT ACTTGGCCGA AGAGCTTCAA TTCTTGAATC CGCATCTGTC GGGTGCCGAT
    CGCGAACGAG ATTCGCCGGA GAGTGAGCGC GGTAGCGAGC GAGATAGCAA GAGCAAAAGC
    AAAGAGCCGG CGATCGAGGA ATATAAAGGC AAGCAGAAGG ACATTGACGA GTCAGTGGAG
    GAGCAGCCGC TGGCCAAGCT CAAGCAGACG GCCAAAGATA AAGAACTAGA GAAAGAGAAA
    GACAAAGGCA AAGAGAAGGA GAAGGAGAAA GACAAAGAGA AAGAACGGAA ATCTCGGTCA
    GAAGGCCCCG TCACGCCCAC ATCCTCCGAG GACTCGCCCG TGGGCAGCTC GAAGCAGGAG
    TTTTTCATCA AGCAGAACAA CAGCAACAGC CTCTCCAATT GCCTGATCAT TGGCGTGAAA
    CCGGCCGGCT CCTCGGCTAG CGACTCACCA CTGCTCGACT CGATGGCGGA CGACAGCGCC
    GACGAGACCG CCAGCATGGG CGGCGGCCGG CGCTTGCGGC GTGGCGCCAA TCGCACCAAG
    AACTCGGCCA TACAGAAGGC GAGCGTCGAG CAGCGCCTGA CGCGCCTGCA GCGTCGCAAG
    TCCATGACCA TGGCGGCGGC CAACAGCTTG CTGAGCTCCA CGTCGCCGGT GAAGATGACG
    CCGGTGCCCC GAACCAGCAT GCCCGCCAGC ACCACCGCCA ACGCCAACGC TGGGCAGCCA
    AAGGCGGGCA ATAAGGCGCC CGCCAAGCAT GCGCTGGCCG GCGCCCGGGA TGACATATTT
    CCACGGCCAA GGGCCGCGGC GCCGGTCAAC CAGCAGGTGG TGCTCGCTCG CCATCCTGGC
    GTGCCGCTCC AGATGCCGCC AAAGTTGCAG CCGCCGCAGG GCGTGCAAGC CATGCCGCCA
    CGTCCTAACT ACGGCATCGG ACGTCCGCCG GGCCCTGCAC GGCTGGCGGC CAATGCCCAG
    GCTAAACGTC TACTGGCTGG GGCTGCACCA CCCGGACCCC GGGCCAACTT CCCCGGGCAA
    CAGCGCCCGC CGGCGCCCGA TGGCTTCAAG GCGCCCGCGA CCAGCTCCGC GCCAACCTCG
    CAGGCGCAGG CGCAGGCTCA GGCCACCACC AACAACAGCT CGGTGAGCAG CTCGAGCGGC
    ATCAGCAGCA TGGCCAACAT GTCCAACATG GTCAGCTTGA GCAGCCTTGC GAGCATTGCC
    GGCTCCAGCA GCGGCTTCAG CCTCAGCGCC AATTCCAACT CCAATTCCAC GCCCAGCTCG
    AGCTTCGGCA CACAGACAGC CTCGATCACC GCCTCGCCGA TTGTGAGCAC CACCCCACCC
    ACCATAGCGC TGATCAAGCG CTGCGAGCGG GGCAACCAGA CCGAGTGCCA GGACATCTTC
    TCGGACGAGC ACTTCCTGGA AATGGTGCGG CCGCAGATGA AGGAGATGAA TCCGCGCCAG
    AAGATGCACT TCAAGCAAAA GATCTTCCAG GCCCTGATCG AGATCTTTGA CGACGCCACC
    GACTTCCCGG CCAGCGGCGA GGTGCAGCAC TTCAATATAA ACACCCCGTC GGGCTTCGAC
    CATGTCACCG ACGACGAGCT GCGTCTCATA CGGGAGCTGG TGAGCATGGT GGGCGCTGCC
    AAGCATACAG CCGGCTCCAG CCCCGGCACG CCGTTGTTGG CACAGCGTGT GGCCACGCCC
    AAGACGCCAA GCGCGCTGCC GAACGCCTTC AGGCCAACCC TAAGCACAAC GCCACTGGGC
    GACGAGAAGA AACTCTATCG CATCATGAAG ACGAACAACC AAACCAAGAT CGTGCCCAAT
    GCATCCCCAT TGACGGATCA GCGCAAGGAC AGCCGCAGCA GCAGCAGCAG CAAGTTCGCC
    GTGCCCGGCG TGGCAGTGAA GGCCGTGGCC CGTCCGCTGG ATCCCTTGAA CCAGCTGTTC
    GGCCAGGGCG GCAGGCCAGC GGCCGCTACG GCCATCTCGC CCAAGGAGCC CATCCTGGTG
    CGTCAAATGG GCCGACGCTA CTCGGTCTGC GGCGGCGGTG GTCCCGCCAA CTCCTTGGGC
    GCCAATGGGA TCAATGCCAA CGCCAACATC GACGTGGCCG TGCTCAAGCG TCGCATCACG
    CCCATAGCAC AGCCCATGGC AGCGCCTGCA CAGCGGCCGC GCTACTCGCC CAACTCTCAG
    CCGCCGGTCA ACCCGATGGC AGCCATTCCG CCGGGCAACA GCCTGCTGAT GCGCCGCGCC
    GTCAACGCCA ACGGCGGCCA GCGCCAGGCG TCGCCGCTGT CGGCGAGCGT CGTGCCCCAG
    AAGACGCCGC AGATTGCGAG CATTCAGGGC AACGTCTTCA ACGAGTTTGC CACGCCCACG
    GCCGTGCGCG GCGGCAGCGG CGGCGGCGGC TCGCCAAGTG GCATCTCGCC AGGGATGCCG
    CCGCTCAAGC GTGCCATGAT CGTGGCCAAT GCCAAGACCA CTGCACAGCC GAAGCCAACG
    ACGACCCTGG CTCGCTCCCA GGTGAGCCCG GCCAGCGGAC AGGTGAGGTC GGCCAGCCAG
    TCGCCCGGCT CGAATGTGGC CAATCTCTTG GCCGAGCCAC GCCCAGAGGT GCCCAACGCC
    GACATGGCCG GCACCATTGC AGCGGATGAC TTCGACATGG GTCGCCTCAA GCGGGAGCCA
    GTGGACCCCG ATGATACGGT GGATATACTG GGCATTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    CloneID ODr336335
    Clone ID Related Accession (Same CDS sequence) XM_030386760.1
    Accession Version XM_030386760.1 Latest version! Documents for ORF clone product in default vector
    Sequence Information ORF Nucleotide Sequence (Length: 2949bp)
    Protein sequence
    SNP
    Vector pcDNA3.1-C-(k)DYK or customized vector User Manual
    Clone information Clone Map MSDS
    Tag on pcDNA3.1+/C-(K)DYK C terminal DYKDDDDK tags
    ORF Insert Method CloneEZ™ Seamless cloning technology
    Insert Structure linear
    Update Date 2019-08-15
    Organism Drosophila navojoa
    Product uncharacterized protein LOC108650263
    Comment Comment: MODEL REFSEQ: This record is predicted by automated computational analysis. This record is derived from a genomic sequence (NW_022045977.1) annotated using gene prediction method: Gnomon. Also see: Documentation of NCBI's Annotation Process ##Genome-Annotation-Data-START## Annotation Provider :: NCBI Annotation Status :: Full annotation Annotation Name :: Drosophila navojoa Annotation Release 101 Annotation Version :: 101 Annotation Pipeline :: NCBI eukaryotic genome annotation pipeline Annotation Software Version :: 8.2 Annotation Method :: Best-placed RefSeq; Gnomon Features Annotated :: Gene; mRNA; CDS; ncRNA ##Genome-Annotation-Data-END## ##RefSeq-Attributes-START## ab initio :: 6% of CDS bases ##RefSeq-Attributes-END##

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGTCTACAT ATAAATCAAA TGTAAAATTG TGCCGCGCTA TTGCAAATCA GCCGATATTG 
    TATGATGAAA GTAATGAACA TTATAGAAAA AGATTGCCTT CAGAGAATTG CTGGGATTTA
    GTCGCTTCAG AGTTGGGAGA GCCTGCGGAT AAGTGCAAGC GTCGCTGGCG TCAGATTCGT
    AACGATTACG TGCGTTGGAT ATCATCGGAC AATCAGCGTC AACGCAACGG ACAGAAGCGA
    CCGGGGTTTT ACTTGGCCGA AGAGCTTCAA TTCTTGAATC CGCATCTGTC GGGTGCCGAT
    CGCGAACGAG ATTCGCCGGA GAGTGAGCGC GGTAGCGAGC GAGATAGCAA GAGCAAAAGC
    AAAGAGCCGG CGATCGAGGA ATATAAAGGC AAGCAGAAGG ACATTGACGA GTCAGTGGAG
    GAGCAGCCGC TGGCCAAGCT CAAGCAGACG GCCAAAGATA AAGAACTAGA GAAAGAGAAA
    GACAAAGGCA AAGAGAAGGA GAAGGAGAAA GACAAAGAGA AAGATAAAGC TACTGATAAA
    CGAGCGGACA AGGAACGGAA ATCTCGGTCA GAAGGCCCCG TCACGCCCAC ATCCTCCGAG
    GACTCGCCCG TGGGCAGCTC GAAGCAGGAG TTTTTCATCA AGCAGAACAA CAGCAACAGC
    CTCTCCAATT GCCTGATCAT TGGCGTGAAA CCGGCCGGCT CCTCGGCTAG CGACTCACCA
    CTGCTCGACT CGATGGCGGA CGACAGCGCC GACGAGACCG CCAGCATGGG CGGCGGCCGG
    CGCTTGCGGC GTGGCGCCAA TCGCACCAAG AACTCGGCCA TACAGAAGGC GAGCGTCGAG
    CAGCGCCTGA CGCGCCTGCA GCGTCGCAAG TCCATGACCA TGGCGGCGGC CAACAGCTTG
    CTGAGCTCCA CGTCGCCGGT GAAGATGACG CCGGTGCCCC GAACCAGCAT GCCCGCCAGC
    ACCACCGCCA ACGCCAACGC TGGGCAGCCA AAGGCGGGCA ATAAGGCGCC CGCCAAGCAT
    GCGCTGGCCG GCGCCCGGGA TGACATATTT CCACGGCCAA GGGCCGCGGC GCCGGTCAAC
    CAGCAGGTGG TGCTCGCTCG CCATCCTGGC GTGCCGCTCC AGATGCCGCC AAAGTTGCAG
    CCGCCGCAGG GCGTGCAAGC CATGCCGCCA CGTCCTAACT ACGGCATCGG ACGTCCGCCG
    GGCCCTGCAC GGCTGGCGGC CAATGCCCAG GCTAAACGTC TACTGGCTGG GGCTGCACCA
    CCCGGACCCC GGGCCAACTT CCCCGGGCAA CAGCGCCCGC CGGCGCCCGA TGGCTTCAAG
    GCGCCCGCGA CCAGCTCCGC GCCAACCTCG CAGGCGCAGG CGCAGGCTCA GGCCACCACC
    AACAACAGCT CGGTGAGCAG CTCGAGCGGC ATCAGCAGCA TGGCCAACAT GTCCAACATG
    GTCAGCTTGA GCAGCCTTGC GAGCATTGCC GGCTCCAGCA GCGGCTTCAG CCTCAGCGCC
    AATTCCAACT CCAATTCCAC GCCCAGCTCG AGCTTCGGCA CACAGACAGC CTCGATCACC
    GCCTCGCCGA TTGTGAGCAC CACCCCACCC ACCATAGCGC TGATCAAGCG CTGCGAGCGG
    GGCAACCAGA CCGAGTGCCA GGACATCTTC TCGGACGAGC ACTTCCTGGA AATGGTGCGG
    CCGCAGATGA AGGAGATGAA TCCGCGCCAG AAGATGCACT TCAAGCAAAA GATCTTCCAG
    GCCCTGATCG AGATCTTTGA CGACGCCACC GACTTCCCGG CCAGCGGCGA GGTGCAGCAC
    TTCAATATAA ACACCCCGTC GGGCTTCGAC CATGTCACCG ACGACGAGCT GCGTCTCATA
    CGGGAGCTGG TGAGCATGGT GGGCGCTGCC AAGCATACAG CCGGCTCCAG CCCCGGCACG
    CCGTTGTTGG CACAGCGTGT GGCCACGCCC AAGACGCCAA GCGCGCTGCC GAACGCCTTC
    AGGCCAACCC TAAGCACAAC GCCACTGGGC GACGAGAAGA AACTCTATCG CATCATGAAG
    ACGAACAACC AAACCAAGAT CGTGCCCAAT GCATCCCCAT TGACGGATCA GCGCAAGGAC
    AGCCGCAGCA GCAGCAGCAG CAAGTTCGCC GTGCCCGGCG TGGCAGTGAA GGCCGTGGCC
    CGTCCGCTGG ATCCCTTGAA CCAGCTGTTC GGCCAGGGCG GCAGGCCAGC GGCCGCTACG
    GCCATCTCGC CCAAGGAGCC CATCCTGGTG CGTCAAATGG GCCGACGCTA CTCGGTCTGC
    GGCGGCGGTG GTCCCGCCAA CTCCTTGGGC GCCAATGGGA TCAATGCCAA CGCCAACATC
    GACGTGGCCG TGCTCAAGCG TCGCATCACG CCCATAGCAC AGCCCATGGC AGCGCCTGCA
    CAGCGGCCGC GCTACTCGCC CAACTCTCAG CCGCCGGTCA ACCCGATGGC AGCCATTCCG
    CCGGGCAACA GCCTGCTGAT GCGCCGCGCC GTCAACGCCA ACGGCGGCCA GCGCCAGGCG
    TCGCCGCTGT CGGCGAGCGT CGTGCCCCAG AAGACGCCGC AGATTGCGAG CATTCAGGGC
    AACGTCTTCA ACGAGTTTGC CACGCCCACG GCCGTGCGCG GCGGCAGCGG CGGCGGCGGC
    TCGCCAAGTG GCATCTCGCC AGGGATGCCG CCGCTCAAGC GTGCCATGAT CGTGGCCAAT
    GCCAAGACCA CTGCACAGCC GAAGCCAACG ACGACCCTGG CTCGCTCCCA GGTGAGCCCG
    GCCAGCGGAC AGGTGAGGTC GGCCAGCCAG TCGCCCGGCT CGAATGTGGC CAATCTCTTG
    GCCGAGCCAC GCCCAGAGGT GCCCAACGCC GACATGGCCG GCACCATTGC AGCGGATGAC
    TTCGACATGG GTCGCCTCAA GCGGGAGCCA GTGGACCCCG ATGATACGGT GGATATACTG
    GGCATTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.

    RefSeq XP_030242620.1
    CDS293..3241
    Translation

    Target ORF information:

    RefSeq Version XM_030386760.1
    Organism Drosophila navojoa
    Definition Drosophila navojoa uncharacterized LOC108650263 (LOC108650263), mRNA.

    Target ORF information:

    Epitope DYKDDDDK
    Bacterial selection AMPR
    Mammalian selection NeoR
    Vector pcDNA3.1+/C-(K)DYK
    XM_030386760.1

    ORF Insert Sequence:

    1
    61
    121
    181
    241
    301
    361
    421
    481
    541
    601
    661
    721
    781
    841
    901
    961
    1021
    1081
    1141
    1201
    1261
    1321
    1381
    1441
    1501
    1561
    1621
    1681
    1741
    1801
    1861
    1921
    1981
    2041
    2101
    2161
    2221
    2281
    2341
    2401
    2461
    2521
    2581
    2641
    2701
    2761
    2821
    2881
    2941
    ATGTCTACAT ATAAATCAAA TGTAAAATTG TGCCGCGCTA TTGCAAATCA GCCGATATTG 
    TATGATGAAA GTAATGAACA TTATAGAAAA AGATTGCCTT CAGAGAATTG CTGGGATTTA
    GTCGCTTCAG AGTTGGGAGA GCCTGCGGAT AAGTGCAAGC GTCGCTGGCG TCAGATTCGT
    AACGATTACG TGCGTTGGAT ATCATCGGAC AATCAGCGTC AACGCAACGG ACAGAAGCGA
    CCGGGGTTTT ACTTGGCCGA AGAGCTTCAA TTCTTGAATC CGCATCTGTC GGGTGCCGAT
    CGCGAACGAG ATTCGCCGGA GAGTGAGCGC GGTAGCGAGC GAGATAGCAA GAGCAAAAGC
    AAAGAGCCGG CGATCGAGGA ATATAAAGGC AAGCAGAAGG ACATTGACGA GTCAGTGGAG
    GAGCAGCCGC TGGCCAAGCT CAAGCAGACG GCCAAAGATA AAGAACTAGA GAAAGAGAAA
    GACAAAGGCA AAGAGAAGGA GAAGGAGAAA GACAAAGAGA AAGATAAAGC TACTGATAAA
    CGAGCGGACA AGGAACGGAA ATCTCGGTCA GAAGGCCCCG TCACGCCCAC ATCCTCCGAG
    GACTCGCCCG TGGGCAGCTC GAAGCAGGAG TTTTTCATCA AGCAGAACAA CAGCAACAGC
    CTCTCCAATT GCCTGATCAT TGGCGTGAAA CCGGCCGGCT CCTCGGCTAG CGACTCACCA
    CTGCTCGACT CGATGGCGGA CGACAGCGCC GACGAGACCG CCAGCATGGG CGGCGGCCGG
    CGCTTGCGGC GTGGCGCCAA TCGCACCAAG AACTCGGCCA TACAGAAGGC GAGCGTCGAG
    CAGCGCCTGA CGCGCCTGCA GCGTCGCAAG TCCATGACCA TGGCGGCGGC CAACAGCTTG
    CTGAGCTCCA CGTCGCCGGT GAAGATGACG CCGGTGCCCC GAACCAGCAT GCCCGCCAGC
    ACCACCGCCA ACGCCAACGC TGGGCAGCCA AAGGCGGGCA ATAAGGCGCC CGCCAAGCAT
    GCGCTGGCCG GCGCCCGGGA TGACATATTT CCACGGCCAA GGGCCGCGGC GCCGGTCAAC
    CAGCAGGTGG TGCTCGCTCG CCATCCTGGC GTGCCGCTCC AGATGCCGCC AAAGTTGCAG
    CCGCCGCAGG GCGTGCAAGC CATGCCGCCA CGTCCTAACT ACGGCATCGG ACGTCCGCCG
    GGCCCTGCAC GGCTGGCGGC CAATGCCCAG GCTAAACGTC TACTGGCTGG GGCTGCACCA
    CCCGGACCCC GGGCCAACTT CCCCGGGCAA CAGCGCCCGC CGGCGCCCGA TGGCTTCAAG
    GCGCCCGCGA CCAGCTCCGC GCCAACCTCG CAGGCGCAGG CGCAGGCTCA GGCCACCACC
    AACAACAGCT CGGTGAGCAG CTCGAGCGGC ATCAGCAGCA TGGCCAACAT GTCCAACATG
    GTCAGCTTGA GCAGCCTTGC GAGCATTGCC GGCTCCAGCA GCGGCTTCAG CCTCAGCGCC
    AATTCCAACT CCAATTCCAC GCCCAGCTCG AGCTTCGGCA CACAGACAGC CTCGATCACC
    GCCTCGCCGA TTGTGAGCAC CACCCCACCC ACCATAGCGC TGATCAAGCG CTGCGAGCGG
    GGCAACCAGA CCGAGTGCCA GGACATCTTC TCGGACGAGC ACTTCCTGGA AATGGTGCGG
    CCGCAGATGA AGGAGATGAA TCCGCGCCAG AAGATGCACT TCAAGCAAAA GATCTTCCAG
    GCCCTGATCG AGATCTTTGA CGACGCCACC GACTTCCCGG CCAGCGGCGA GGTGCAGCAC
    TTCAATATAA ACACCCCGTC GGGCTTCGAC CATGTCACCG ACGACGAGCT GCGTCTCATA
    CGGGAGCTGG TGAGCATGGT GGGCGCTGCC AAGCATACAG CCGGCTCCAG CCCCGGCACG
    CCGTTGTTGG CACAGCGTGT GGCCACGCCC AAGACGCCAA GCGCGCTGCC GAACGCCTTC
    AGGCCAACCC TAAGCACAAC GCCACTGGGC GACGAGAAGA AACTCTATCG CATCATGAAG
    ACGAACAACC AAACCAAGAT CGTGCCCAAT GCATCCCCAT TGACGGATCA GCGCAAGGAC
    AGCCGCAGCA GCAGCAGCAG CAAGTTCGCC GTGCCCGGCG TGGCAGTGAA GGCCGTGGCC
    CGTCCGCTGG ATCCCTTGAA CCAGCTGTTC GGCCAGGGCG GCAGGCCAGC GGCCGCTACG
    GCCATCTCGC CCAAGGAGCC CATCCTGGTG CGTCAAATGG GCCGACGCTA CTCGGTCTGC
    GGCGGCGGTG GTCCCGCCAA CTCCTTGGGC GCCAATGGGA TCAATGCCAA CGCCAACATC
    GACGTGGCCG TGCTCAAGCG TCGCATCACG CCCATAGCAC AGCCCATGGC AGCGCCTGCA
    CAGCGGCCGC GCTACTCGCC CAACTCTCAG CCGCCGGTCA ACCCGATGGC AGCCATTCCG
    CCGGGCAACA GCCTGCTGAT GCGCCGCGCC GTCAACGCCA ACGGCGGCCA GCGCCAGGCG
    TCGCCGCTGT CGGCGAGCGT CGTGCCCCAG AAGACGCCGC AGATTGCGAG CATTCAGGGC
    AACGTCTTCA ACGAGTTTGC CACGCCCACG GCCGTGCGCG GCGGCAGCGG CGGCGGCGGC
    TCGCCAAGTG GCATCTCGCC AGGGATGCCG CCGCTCAAGC GTGCCATGAT CGTGGCCAAT
    GCCAAGACCA CTGCACAGCC GAAGCCAACG ACGACCCTGG CTCGCTCCCA GGTGAGCCCG
    GCCAGCGGAC AGGTGAGGTC GGCCAGCCAG TCGCCCGGCT CGAATGTGGC CAATCTCTTG
    GCCGAGCCAC GCCCAGAGGT GCCCAACGCC GACATGGCCG GCACCATTGC AGCGGATGAC
    TTCGACATGG GTCGCCTCAA GCGGGAGCCA GTGGACCCCG ATGATACGGT GGATATACTG
    GGCATTTAA

    The stop codons will be deleted if pcDNA3.1+/C-(K)DYK vector is selected.